À quoi sert ce calculateur
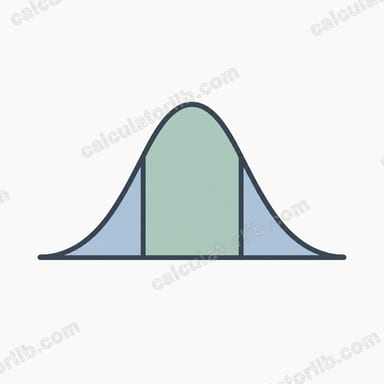
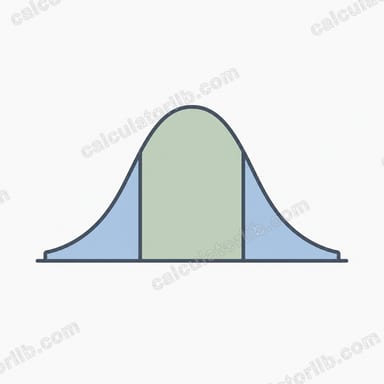
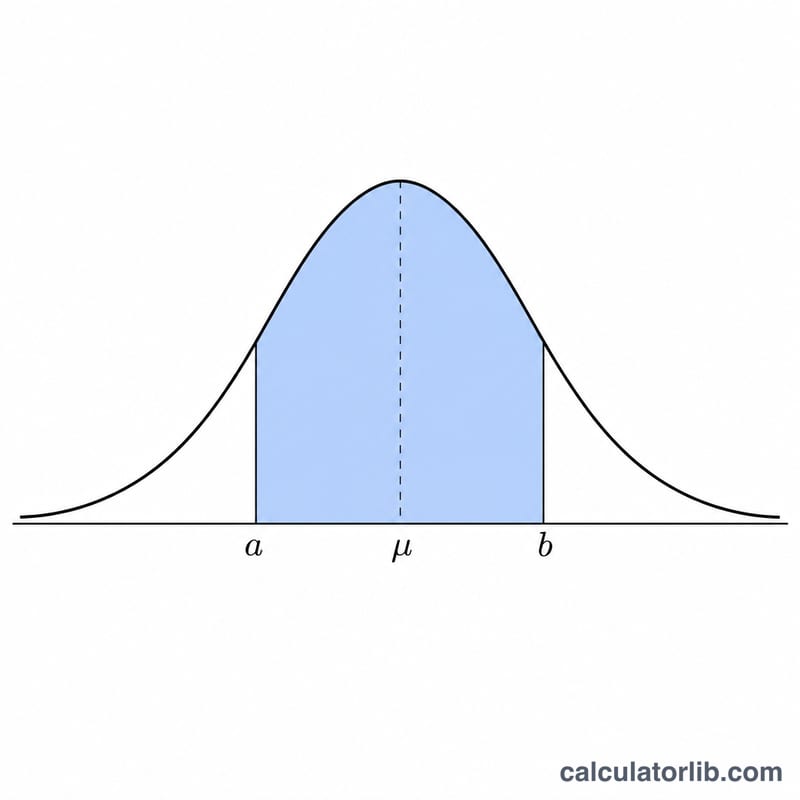
Cet outil calcule la probabilité qu'une variable aléatoire X suivant une loi normale se situe entre deux valeurs, a et b — ce que l'on note \(P(a < X < b)\). Il vous suffit d'indiquer la moyenne de la distribution (\(\mu\)), son écart type (\(\sigma\)) et les deux bornes. Le calculateur convertit chaque borne en cote z (score z), puis applique la fonction de répartition de la loi normale centrée réduite \(\Phi\) pour renvoyer l'aire exacte sous la courbe en cloche comprise entre ces deux valeurs.
Comment l'utiliser
Saisissez la moyenne et l'écart type de votre distribution, puis entrez la borne inférieure a et la borne supérieure b. Cliquez sur Calculer. Le résultat affiche la probabilité sous forme décimale (de 0 à 1) et en pourcentage, accompagnée des deux cotes z. Si vous inversez les valeurs, le calculateur considère automatiquement la plus petite comme a et la plus grande comme b.
La formule expliquée
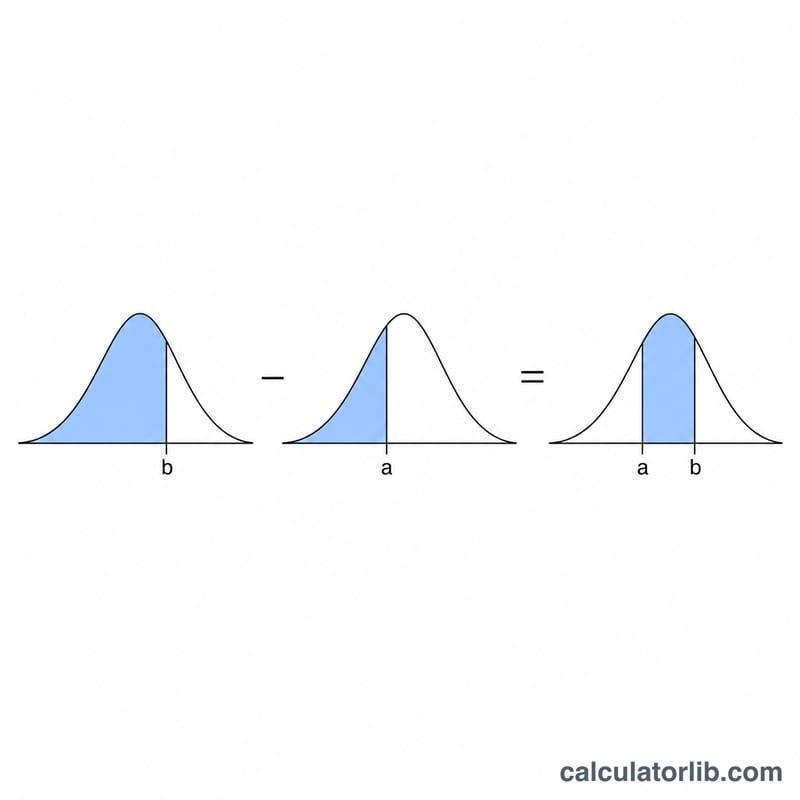
La probabilité entre a et b est égale à la valeur de la fonction de répartition en b moins sa valeur en a :
$$P(a < X < b) = \Phi\left(\frac{b-\mu}{\sigma}\right) - \Phi\left(\frac{a-\mu}{\sigma}\right)$$Le terme \(\frac{x-\mu}{\sigma}\) transforme une valeur brute en cote z, c'est-à-dire le nombre d'écarts types qui la séparent de la moyenne. \(\Phi(z)\) donne l'aire cumulée à gauche de \(z\) sous la courbe normale centrée réduite. La soustraction des deux aires cumulées laisse l'aire strictement comprise entre a et b. Ce calculateur évalue \(\Phi\) à l'aide d'une approximation très précise de la fonction d'erreur.
Exemple concret
Supposons que les scores de QI suivent une loi normale de moyenne \(\mu = 100\) et d'écart type \(\sigma = 15\), et que l'on cherche \(P(85 < X < 115)\). Les cotes z valent
$$\frac{85-100}{15} = -1 \quad\text{et}\quad \frac{115-100}{15} = +1$$Comme \(\Phi(1) \approx 0{,}8413\) et \(\Phi(-1) \approx 0{,}1587\), la probabilité \(\approx 0{,}8413 - 0{,}1587 = 0{,}6827\), soit environ 68,3 % — la fameuse règle de l'écart type unique.
Probabilités normales courantes et table des scores z
Pour une variable normale standard \(Z\) (moyenne 0, écart type 1), la probabilité de tomber à moins de \(z\) écarts types de la moyenne est \(P(-z<Z<z)=2\Phi(z)-1\). Ces valeurs s'appliquent à toute loi normale une fois que x est converti en score z.
| z | P(-z < Z < z) | Pourcentage |
|---|---|---|
| 1 | 0,6827 | 68,27 % |
| 1,645 | 0,9000 | 90,00 % |
| 1,96 | 0,9500 | 95,00 % |
| 2 | 0,9545 | 95,45 % |
| 2,576 | 0,9900 | 99,00 % |
| 3 | 0,9973 | 99,73 % |
La règle 68-95-99,7
- Environ 68 % des valeurs se situent dans \(\mu \pm 1\sigma\).
- Environ 95 % se situent dans \(\mu \pm 2\sigma\) (plus précisément 95,45 %).
- Environ 99,7 % se situent dans \(\mu \pm 3\sigma\) (plus précisément 99,73 %).
Les valeurs 1,645, 1,96 et 2,576 sont arrondies à trois décimales, de sorte que les probabilités correspondantes sont elles aussi arrondies.
Interpréter votre probabilité
Le résultat \(P(a<X<b)\) est la proportion de la distribution comprise entre \(a\) et \(b\). Un résultat de 0,8186 signifie qu'environ 81,86 % des observations devraient tomber dans cet intervalle. De manière équivalente, une observation choisie au hasard a cette probabilité de s'y trouver.
Un score z indique à combien d'écarts types une valeur se trouve de la moyenne. \(z=0\) correspond à la moyenne, \(z=2\) à deux écarts types au-dessus, et \(z=-1\) à un écart type en dessous. Comparer \(z_a\) et \(z_b\) montre la largeur de votre intervalle en unités d'écart type.
Vous pouvez comparer votre résultat à la règle empirique. Un intervalle \(\mu\pm1\sigma\) donne environ 0,68, \(\mu\pm2\sigma\) environ 0,95 et \(\mu\pm3\sigma\) environ 0,997. Si votre intervalle est plus étroit que l'un de ces intervalles, attendez-vous à une probabilité plus faible.
- Valeurs très faibles (par exemple inférieures à 0,01) : l'intervalle est étroit ou situé loin dans une queue de distribution. De tels résultats sont rares sous ce modèle.
- Valeurs proches de 1 : l'intervalle couvre presque toute la distribution. La probabilité restante se trouve dans les queues situées en dehors de \(a\) et \(b\).
Le calcul suppose que la variable suit réellement une loi normale de moyenne et d'écart type que vous avez saisis. Des données réelles peuvent être asymétriques ou avoir des queues plus lourdes, ce qui rend les probabilités de queue moins fiables. Vérifiez cette hypothèse à l'aide d'un histogramme ou d'un graphique de probabilité normale. Si vous avez estimé \(\mu\) et \(\sigma\) à partir d'un petit échantillon, le résultat n'est qu'approximatif.
Questions fréquentes
Est-ce que le choix entre < et ≤ change le résultat ? Non. Pour une loi normale continue, la probabilité en un point précis est nulle ; \(P(a < X < b)\) et \(P(a \le X \le b)\) sont donc identiques.
Que se passe-t-il si mon écart type vaut 0 ? Un écart type doit être strictement positif ; avec \(\sigma = 0\), la distribution n'est pas définie, et le calculateur renvoie 0.
Quelle est la précision du résultat ? La fonction de répartition est calculée avec l'approximation d'Abramowitz et Stegun, précise à environ 7 décimales — largement suffisant pour les travaux statistiques courants.