Công cụ này làm gì
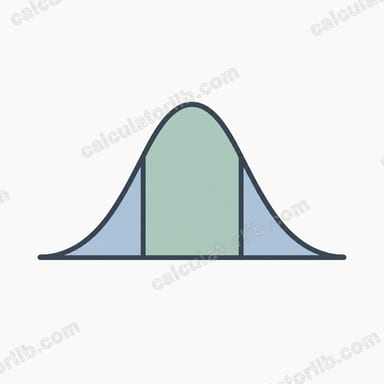
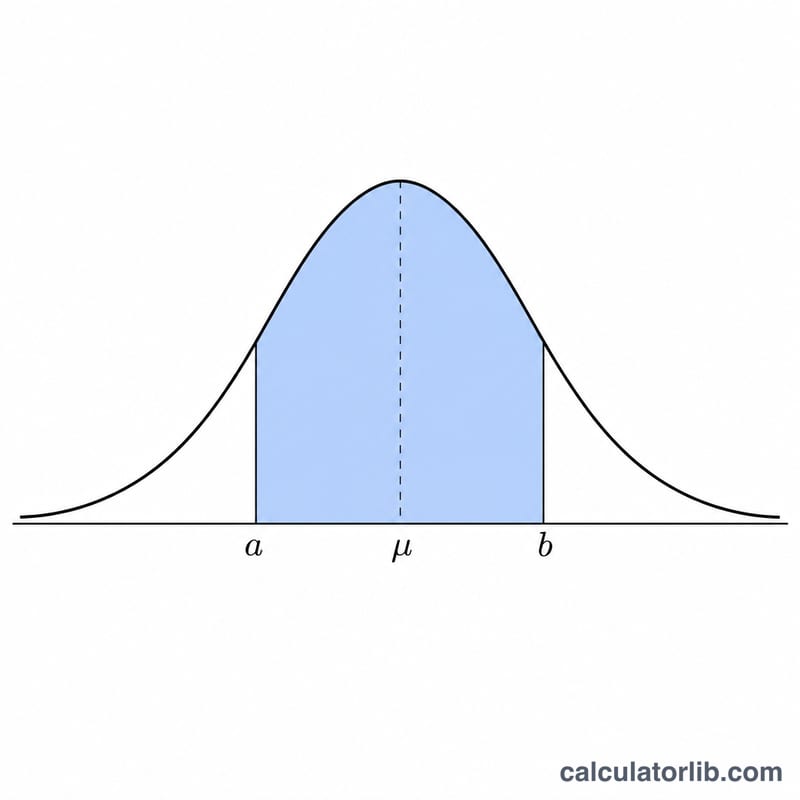
Công cụ giúp bạn tính xác suất để một biến ngẫu nhiên X tuân theo phân phối chuẩn rơi vào khoảng giữa hai giá trị a và b — ký hiệu là \(P(a < X < b)\). Bạn chỉ cần nhập giá trị trung bình (\(\mu\)), độ lệch chuẩn (\(\sigma\)) và hai giá trị biên. Công cụ sẽ chuẩn hóa từng giá trị biên thành điểm z, sau đó dùng hàm phân phối tích lũy chuẩn \(\Phi\) để trả về chính xác phần diện tích dưới đường cong hình chuông nằm giữa hai biên đó.
Cách sử dụng
Nhập giá trị trung bình và độ lệch chuẩn của phân phối, rồi điền giá trị cận dưới a và cận trên b. Nhấn nút tính toán. Kết quả hiển thị xác suất dưới dạng số thập phân (từ 0 đến 1) và dưới dạng phần trăm, kèm theo hai điểm z tương ứng. Nếu bạn nhập hai giá trị ngược thứ tự, công cụ sẽ tự động lấy số nhỏ hơn làm a và số lớn hơn làm b.
Giải thích công thức
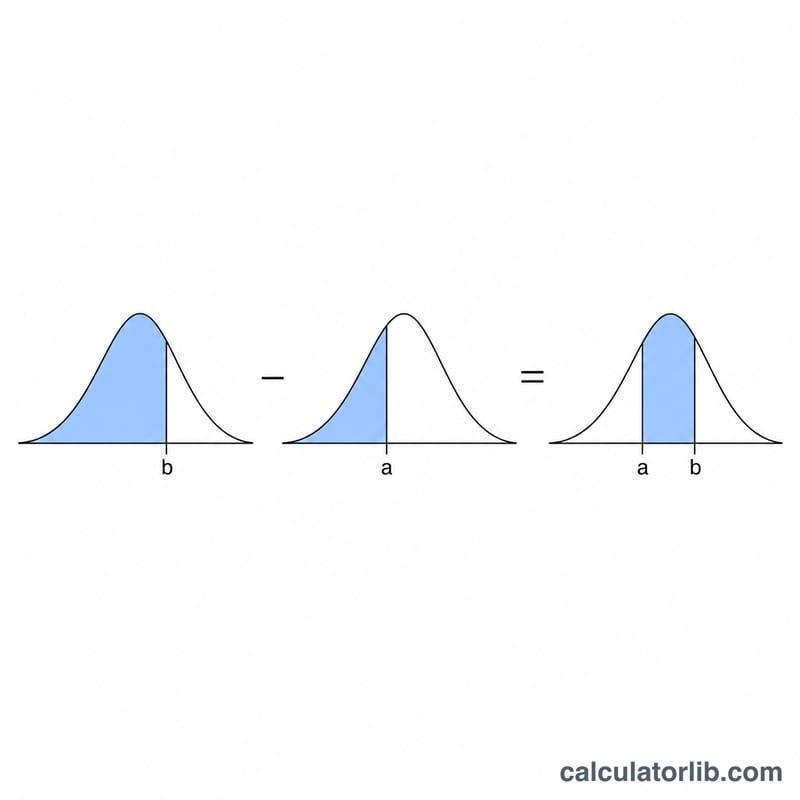
Xác suất giữa a và b bằng giá trị CDF tại b trừ đi giá trị CDF tại a:
$$P(a < X < b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)$$Biểu thức \(\frac{x-\mu}{\sigma}\) chuyển một giá trị gốc thành điểm z — tức là số lần độ lệch chuẩn so với trung bình. \(\Phi(z)\) cho biết phần diện tích tích lũy nằm bên trái z dưới đường cong chuẩn tắc. Khi lấy hiệu của hai diện tích tích lũy này, ta thu được phần diện tích nằm hoàn toàn giữa a và b. Công cụ tính \(\Phi\) bằng một phép xấp xỉ hàm sai số có độ chính xác cao.
Ví dụ minh họa
Giả sử chỉ số IQ tuân theo phân phối chuẩn với \(\mu = 100\) và \(\sigma = 15\), và bạn muốn tính \(P(85 < X < 115)\). Các điểm z là
$$\frac{85-100}{15} = -1 \quad\text{và}\quad \frac{115-100}{15} = +1$$Ta có \(\Phi(1) \approx 0{,}8413\) và \(\Phi(-1) \approx 0{,}1587\), nên xác suất
$$\approx 0{,}8413 - 0{,}1587 = 0{,}6827$$tức khoảng 68,3% — đúng theo quy tắc "một độ lệch chuẩn" quen thuộc.
Các xác suất chuẩn thông dụng và bảng tra điểm z
Với biến chuẩn tắc \(Z\) (kỳ vọng 0, độ lệch chuẩn 1), xác suất rơi vào khoảng cách trung bình trong phạm vi \(z\) độ lệch chuẩn là \(P(-z<Z<z)=2\Phi(z)-1\). Các giá trị này áp dụng cho mọi phân phối chuẩn sau khi chuyển x thành điểm z.
| z | P(-z < Z < z) | Phần trăm |
|---|---|---|
| 1 | 0.6827 | 68.27% |
| 1.645 | 0.9000 | 90.00% |
| 1.96 | 0.9500 | 95.00% |
| 2 | 0.9545 | 95.45% |
| 2.576 | 0.9900 | 99.00% |
| 3 | 0.9973 | 99.73% |
Quy tắc 68-95-99.7
- Khoảng 68% giá trị nằm trong \(\mu \pm 1\sigma\).
- Khoảng 95% nằm trong \(\mu \pm 2\sigma\) (chính xác hơn là 95.45%).
- Khoảng 99.7% nằm trong \(\mu \pm 3\sigma\) (chính xác hơn là 99.73%).
Các giá trị 1.645, 1.96 và 2.576 được làm tròn đến ba chữ số thập phân, vì vậy các xác suất tương ứng cũng được làm tròn.
Diễn giải xác suất của bạn
Kết quả \(P(a<X<b)\) là tỷ lệ của phân phối nằm giữa \(a\) và \(b\). Kết quả 0.8186 có nghĩa là khoảng 81.86% quan sát được kỳ vọng rơi vào khoảng đó. Nói cách khác, một quan sát được chọn ngẫu nhiên có xác suất rơi vào khoảng này bằng chính con số đó.
Điểm z cho biết một giá trị cách trung bình bao nhiêu độ lệch chuẩn. \(z=0\) là trung bình, \(z=2\) cao hơn trung bình hai độ lệch chuẩn, còn \(z=-1\) thấp hơn một độ lệch chuẩn. So sánh \(z_a\) và \(z_b\) cho thấy khoảng của bạn rộng bao nhiêu theo đơn vị độ lệch chuẩn.
Bạn có thể so sánh kết quả với quy tắc thực nghiệm. Khoảng \(\mu\pm1\sigma\) cho khoảng 0.68, \(\mu\pm2\sigma\) cho khoảng 0.95 và \(\mu\pm3\sigma\) cho khoảng 0.997. Nếu khoảng của bạn hẹp hơn một trong các khoảng này, hãy kỳ vọng xác suất nhỏ hơn.
- Giá trị rất nhỏ (ví dụ dưới 0.01) cho thấy khoảng hẹp hoặc nằm xa ở đuôi phân phối. Những kết quả như vậy hiếm gặp theo mô hình này.
- Giá trị gần 1 cho thấy khoảng bao phủ gần như toàn bộ phân phối. Phần xác suất còn lại nằm ở các đuôi bên ngoài \(a\) và \(b\).
Phép tính giả định rằng biến thực sự tuân theo phân phối chuẩn với kỳ vọng và độ lệch chuẩn mà bạn đã nhập. Dữ liệu thực tế có thể bị lệch hoặc có đuôi dày hơn, điều này khiến xác suất ở đuôi kém tin cậy hơn. Hãy kiểm tra giả định bằng biểu đồ tần suất hoặc biểu đồ xác suất chuẩn. Nếu bạn ước lượng \(\mu\) và \(\sigma\) từ một mẫu nhỏ, kết quả chỉ mang tính gần đúng.
Câu hỏi thường gặp
Dùng dấu < hay ≤ có khác nhau không? Không. Với phân phối chuẩn liên tục, xác suất tại bất kỳ một điểm đơn lẻ nào đều bằng 0, nên \(P(a < X < b)\) và \(P(a \le X \le b)\) cho kết quả như nhau.
Nếu độ lệch chuẩn bằng 0 thì sao? Độ lệch chuẩn bắt buộc phải là số dương; khi \(\sigma = 0\) thì phân phối không xác định, nên công cụ sẽ trả về 0.
Kết quả chính xác đến đâu? Hàm CDF được tính theo phép xấp xỉ Abramowitz & Stegun, chính xác đến khoảng 7 chữ số thập phân — quá đủ cho hầu hết các bài toán thống kê thông thường.