这个计算器能做什么
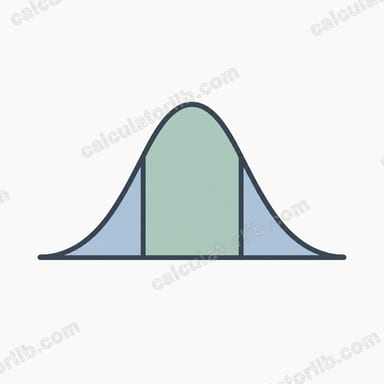
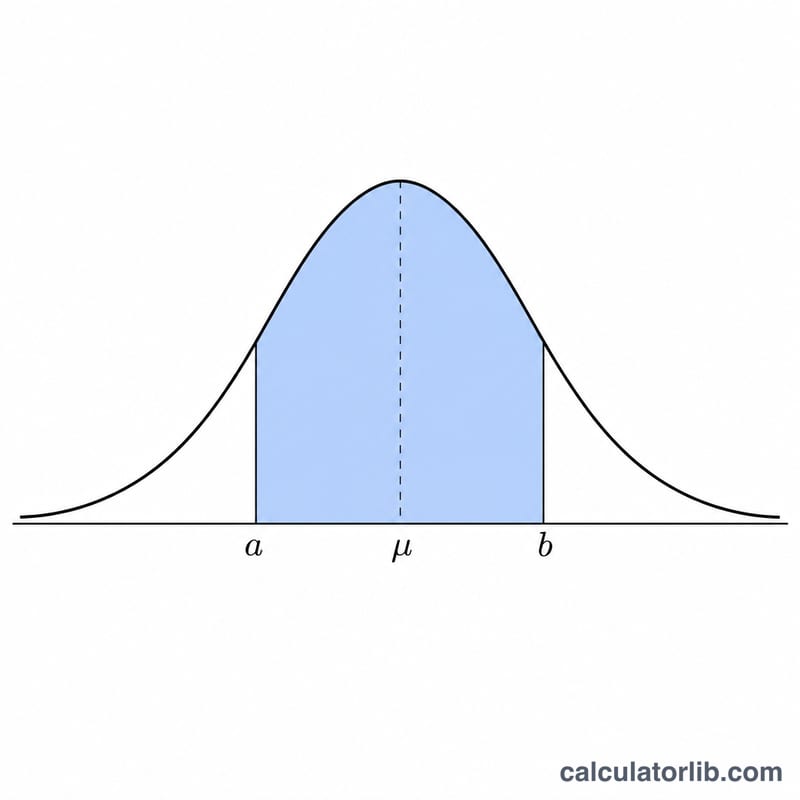
这款工具用来计算服从正态分布的随机变量 X 落在两个数值 a 与 b 之间的概率,记作 \(P(a < X < b)\)。你只需提供分布的均值(\(\mu\))、标准差(\(\sigma\))以及两个边界值,计算器会把每个边界标准化为 z 分数,再借助标准正态累积分布函数 \(\Phi\),精确求出钟形曲线在这两点之间所覆盖的面积。
使用方法
先填入分布的均值和标准差,再输入下界 a 和上界 b,点击「计算」即可。结果会以小数(0 到 1)和百分比两种形式给出概率,并同时显示两个边界对应的 z 分数。即便你把数值的大小顺序写反了也没关系——计算器会自动把较小值当作 a,较大值当作 b。
公式解析
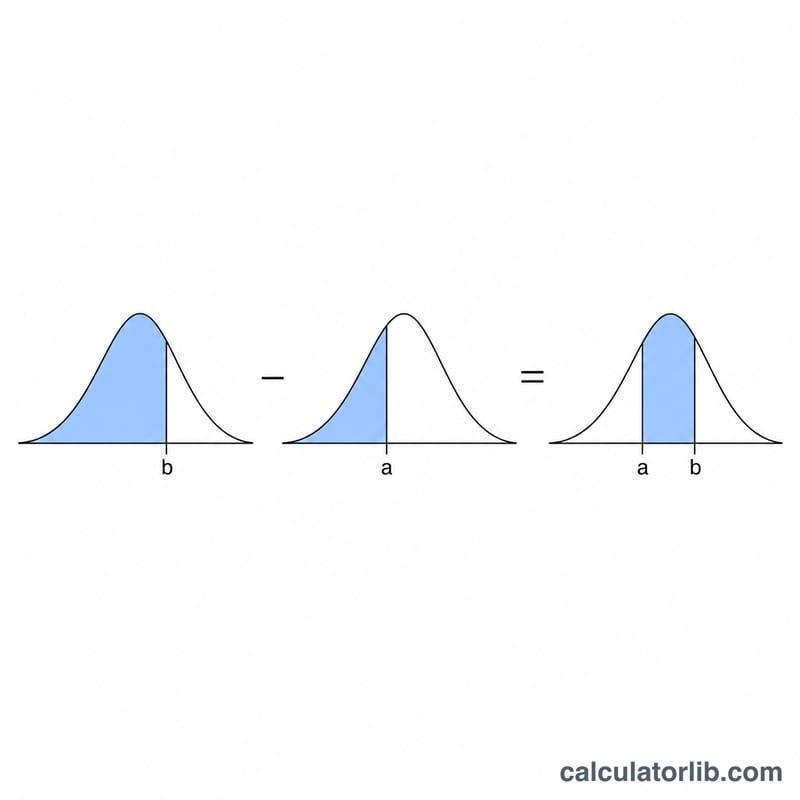
a 到 b 之间的概率等于 b 处的累积分布值减去 a 处的累积分布值:
$$P(a < X < b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)$$其中 \((x-\mu)/\sigma\) 把原始数值换算成 z 分数,也就是该值距离均值有多少个标准差。\(\Phi(z)\) 表示标准正态曲线下 z 左侧的累积面积。两个累积面积相减,剩下的正好是严格介于 a 与 b 之间的面积。本计算器采用高精度的误差函数近似来求 \(\Phi\)。
实例演算
假设智商分数服从均值 \(\mu = 100\)、标准差 \(\sigma = 15\) 的正态分布,想求 \(P(85 < X < 115)\)。两个 z 分数分别为 \((85-100)/15 = -1\) 和 \((115-100)/15 = +1\)。由 \(\Phi(1) \approx 0.8413\)、\(\Phi(-1) \approx 0.1587\),可得概率约为 $$0.8413 - 0.1587 = 0.6827$$ 也就是约 68.3%——这正是我们常说的「一个标准差范围」经验法则。
常见正态概率与 Z 分数参考表
对于标准正态变量 \(Z\)(均值 0,标准差 1),落在均值两侧 \(z\) 个标准差范围内的概率为 \(P(-z<Z<z)=2\Phi(z)-1\)。一旦将 x 转换为 z 分数,这些数值适用于任何正态分布。
| z | P(-z < Z < z) | 百分比 |
|---|---|---|
| 1 | 0.6827 | 68.27% |
| 1.645 | 0.9000 | 90.00% |
| 1.96 | 0.9500 | 95.00% |
| 2 | 0.9545 | 95.45% |
| 2.576 | 0.9900 | 99.00% |
| 3 | 0.9973 | 99.73% |
68-95-99.7 法则
- 约 68% 的数值位于 \(\mu \pm 1\sigma\) 范围内。
- 约 95% 的数值位于 \(\mu \pm 2\sigma\) 范围内(更精确地说是 95.45%)。
- 约 99.7% 的数值位于 \(\mu \pm 3\sigma\) 范围内(更精确地说是 99.73%)。
数值 1.645、1.96 和 2.576 是四舍五入到三位小数的,因此对应的概率也经过了四舍五入。
解读你的概率结果
结果 \(P(a<X<b)\) 表示分布中位于 \(a\) 与 \(b\) 之间的比例。结果为 0.8186 意味着约 81.86% 的观测值预计落在该范围内。换言之,随机选取的一个观测值落在该范围内的机会即为此概率。
z 分数表示一个数值偏离均值的标准差个数。\(z=0\) 为均值,\(z=2\) 比均值高两个标准差,\(z=-1\) 比均值低一个标准差。比较 \(z_a\) 与 \(z_b\) 可以看出你的区间以标准差为单位有多宽。
你可以将结果与经验法则进行比较。区间 \(\mu\pm1\sigma\) 约对应 0.68,\(\mu\pm2\sigma\) 约对应 0.95,\(\mu\pm3\sigma\) 约对应 0.997。如果你的区间比其中某一个更窄,那么预计概率会更小。
- 非常小的数值(例如低于 0.01)表示区间很窄,或位于远离中心的尾部。在该模型下,这类结果很罕见。
- 接近 1 的数值表示区间几乎覆盖了整个分布。剩余的概率位于 \(a\) 与 \(b\) 之外的尾部。
该计算假设变量确实服从正态分布,且均值和标准差与你输入的一致。真实数据可能有偏态或更厚的尾部,这会使尾部概率的可靠性降低。可以用直方图或正态概率图检验该假设。如果你是从小样本中估计 \(\mu\) 和 \(\sigma\) 的,那么结果只是近似值。
常见问题
用 \(<\) 还是 \(\le\) 会影响结果吗?不会。对于连续型正态分布,任何单个点的概率都为零,因此 \(P(a < X < b)\) 与 \(P(a \le X \le b)\) 完全相同。
如果标准差是 0 怎么办?标准差必须为正数;当 \(\sigma = 0\) 时分布无定义,此时计算器会返回 0。
结果有多精确?累积分布函数采用 Abramowitz & Stegun 近似算法,精度约达 7 位小数,对于一般统计计算而言绰绰有余。