이 계산기의 기능
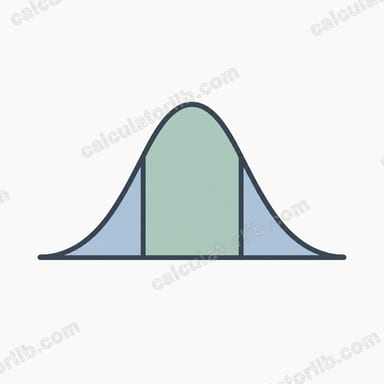
이 도구는 정규분포를 따르는 확률변수 X가 두 값 a와 b 사이에 들어갈 확률, 즉 \(P(a < X < b)\)를 계산합니다. 분포의 평균(\(\mu\)), 표준편차(\(\sigma\)), 그리고 두 경곗값만 입력하면 됩니다. 계산기는 각 경곗값을 z점수로 표준화한 뒤 표준정규 누적분포함수 \(\Phi\)를 이용해 종 모양 곡선 아래의 정확한 면적(확률)을 구해 줍니다.
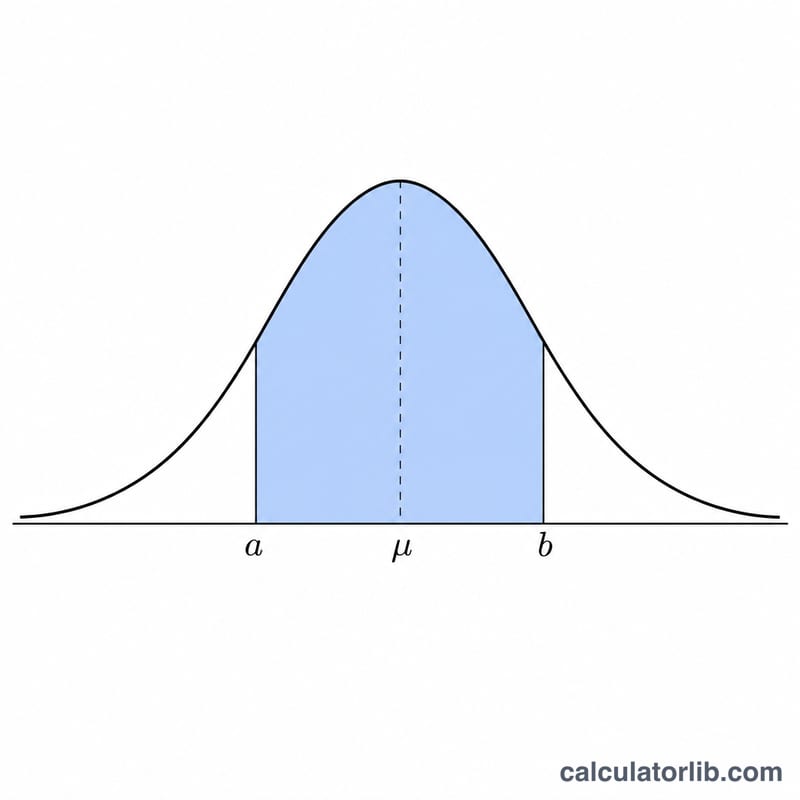
사용 방법
먼저 분포의 평균과 표준편차를 입력한 다음, 하한값 a와 상한값 b를 차례로 입력하세요. 계산 버튼을 누르면 확률이 소수(0~1)와 백분율로 표시되고, 두 z점수도 함께 나타납니다. 값의 순서를 바꿔 입력하더라도 계산기가 자동으로 작은 값을 a, 큰 값을 b로 처리하니 걱정하지 않아도 됩니다.
공식 풀이
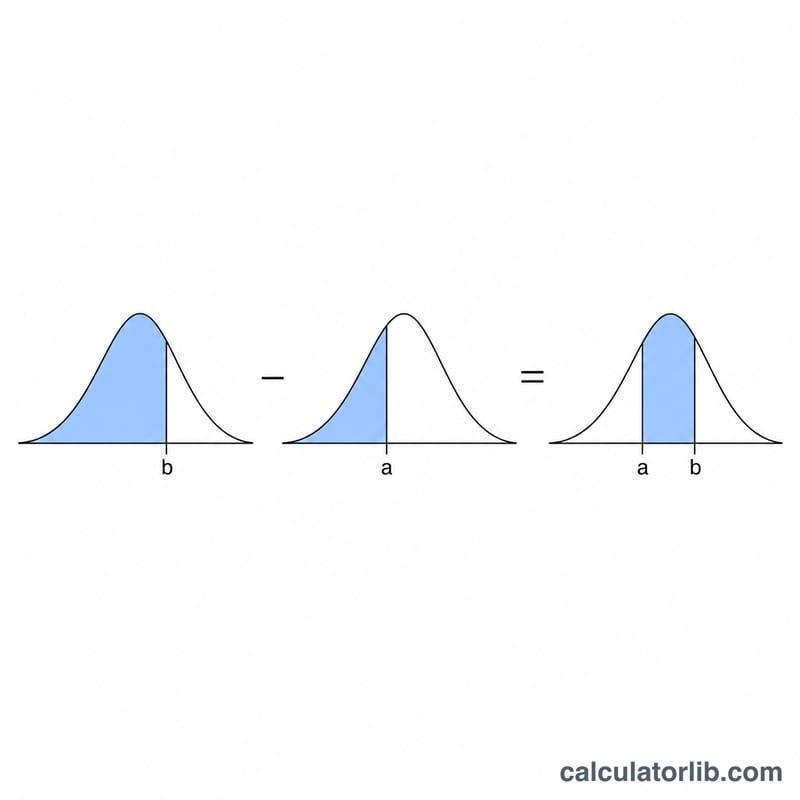
a와 b 사이의 확률은 b에서의 CDF 값에서 a에서의 CDF 값을 뺀 값과 같습니다. 즉 $$P(a < X < b) = \Phi\!\left(\dfrac{b-\mu}{\sigma}\right) - \Phi\!\left(\dfrac{a-\mu}{\sigma}\right)$$ 입니다. 여기서 \(\frac{x-\mu}{\sigma}\)는 원점수를 z점수, 다시 말해 평균에서 표준편차 몇 배만큼 떨어져 있는지를 나타내는 값으로 변환합니다. \(\Phi(z)\)는 표준정규곡선에서 \(z\)의 왼쪽에 해당하는 누적 면적을 의미합니다. 두 누적 면적을 빼면 정확히 a와 b 사이의 면적만 남습니다. 이 계산기는 고정밀 오차함수 근사식을 사용해 \(\Phi\)를 계산합니다.
계산 예시
IQ 점수가 평균 \(\mu = 100\), 표준편차 \(\sigma = 15\)인 정규분포를 따른다고 하고, \(P(85 < X < 115)\)를 구한다고 해 봅시다. z점수는 각각 $$\frac{85-100}{15} = -1 \quad\text{과}\quad \frac{115-100}{15} = +1$$ 입니다. \(\Phi(1) \approx 0.8413\)이고 \(\Phi(-1) \approx 0.1587\)이므로 확률은 약 $$0.8413 - 0.1587 = 0.6827$$ 즉 약 68.3%가 됩니다. 바로 우리에게 익숙한 '표준편차 1배(1σ) 규칙'이지요.
일반 정규확률 및 z-점수 참조표
표준 정규변수 \(Z\)(평균 0, 표준편차 1)에 대해, 평균으로부터 \(z\) 표준편차 이내에 놓일 확률은 \(P(-z<Z<z)=2\Phi(z)-1\)입니다. 이 값들은 x를 z-점수로 변환한 뒤에는 모든 정규분포에 적용됩니다.
| z | P(-z < Z < z) | 백분율 |
|---|---|---|
| 1 | 0.6827 | 68.27% |
| 1.645 | 0.9000 | 90.00% |
| 1.96 | 0.9500 | 95.00% |
| 2 | 0.9545 | 95.45% |
| 2.576 | 0.9900 | 99.00% |
| 3 | 0.9973 | 99.73% |
68-95-99.7 법칙
- 값의 약 68%가 \(\mu \pm 1\sigma\) 범위 안에 있습니다.
- 약 95%가 \(\mu \pm 2\sigma\) 범위 안에 있습니다(더 정확하게는 95.45%).
- 약 99.7%가 \(\mu \pm 3\sigma\) 범위 안에 있습니다(더 정확하게는 99.73%).
1.645, 1.96, 2.576 값은 소수점 셋째 자리까지 반올림한 것이므로, 이들에 대한 확률도 마찬가지로 반올림된 값입니다.
확률 해석하기
결과 \(P(a<X<b)\)는 \(a\)와 \(b\) 사이에 놓인 분포의 비율입니다. 결과가 0.8186이면 관측값의 약 81.86%가 그 범위에 놓일 것으로 予상됩니다. 즉, 무작위로 뽑은 관측값이 그 범위에 들어갈 확률이 그만큼이라는 뜻입니다.
z-점수는 값이 평균으로부터 표준편차 몇 개만큼 떨어져 있는지를 나타냅니다. \(z=0\)은 평균이고, \(z=2\)는 평균보다 표준편차 2개만큼 위, \(z=-1\)은 1개만큼 아래입니다. \(z_a\)와 \(z_b\)를 비교하면 구간이 표준편차 단위로 얼마나 넓은지 알 수 있습니다.
답을 경험적 법칙과 비교해 볼 수 있습니다. \(\mu\pm1\sigma\) 구간은 약 0.68, \(\mu\pm2\sigma\)는 약 0.95, \(\mu\pm3\sigma\)는 약 0.997입니다. 구간이 이들 중 하나보다 좁다면 확률은 더 작을 것으로 예상하세요.
- 매우 작은 값(예: 0.01 미만)은 구간이 좁거나 분포의 꼬리 쪽 멀리 떨어져 있다는 뜻입니다. 이 모델에서는 그런 결과가 드뭅니다.
- 1에 가까운 값은 구간이 분포의 거의 전부를 포함한다는 뜻입니다. 나머지 확률은 \(a\)와 \(b\) 바깥쪽 꼬리에 있습니다.
이 계산은 변수가 실제로 입력한 평균과 표준편차를 갖는 정규분포를 따른다고 가정합니다. 실제 데이터는 비대칭이거나 꼬리가 더 두꺼울 수 있으며, 이 경우 꼬리 확률의 신뢰도가 떨어집니다. 히스토그램이나 정규확률도표로 이 가정을 확인하세요. \(\mu\)와 \(\sigma\)를 작은 표본에서 추정했다면 결과는 근사값에 불과합니다.
자주 묻는 질문
<와 ≤ 중 무엇을 쓰는지가 결과에 영향을 주나요? 아니요. 연속적인 정규분포에서는 어느 한 점에서의 확률이 0이기 때문에 \(P(a < X < b)\)와 \(P(a \le X \le b)\)는 완전히 동일합니다.
표준편차가 0이면 어떻게 되나요? 표준편차는 반드시 양수여야 합니다. \(\sigma = 0\)이면 분포 자체가 정의되지 않으므로 계산기는 0을 반환합니다.
결과는 얼마나 정확한가요? CDF는 Abramowitz & Stegun 근사식으로 계산되며 소수점 약 7자리까지 정확합니다. 일반적인 통계 작업에는 차고도 넘치는 정밀도입니다.