Что делает этот калькулятор
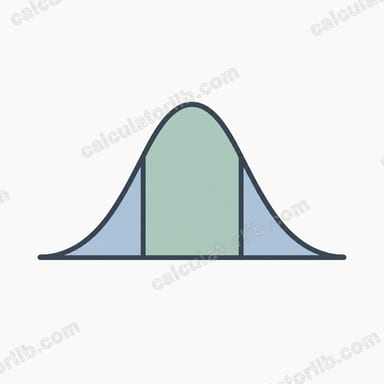
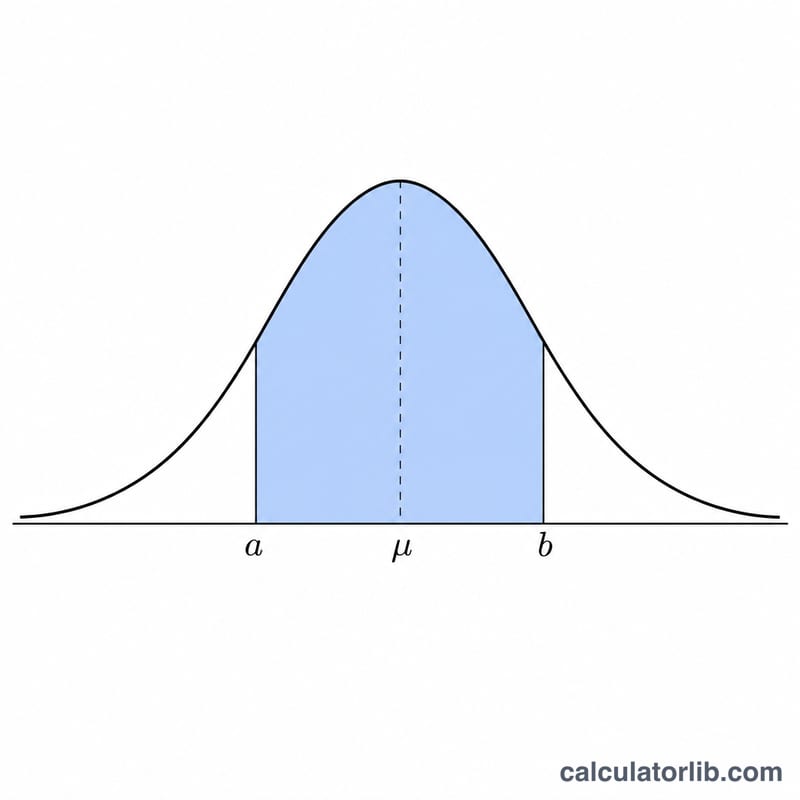
Инструмент вычисляет вероятность того, что нормально распределённая случайная величина X окажется между двумя значениями — a и b. В записи это выглядит как \(P(a < X < b)\). Вы задаёте среднее распределения (\(\mu\)), стандартное отклонение (\(\sigma\)) и две границы. Калькулятор переводит каждую границу в z-оценку и с помощью функции распределения стандартного нормального закона \(\Phi\) возвращает точную площадь под колоколообразной кривой между ними.
Как пользоваться
Укажите среднее и стандартное отклонение вашего распределения, затем введите нижнее значение a и верхнее значение b. Нажмите «Рассчитать». Результат покажет вероятность в виде десятичной дроби (от 0 до 1) и в процентах, а также обе z-оценки. Если вы перепутаете порядок значений, калькулятор автоматически возьмёт меньшее за a, а большее — за b.
Разбор формулы
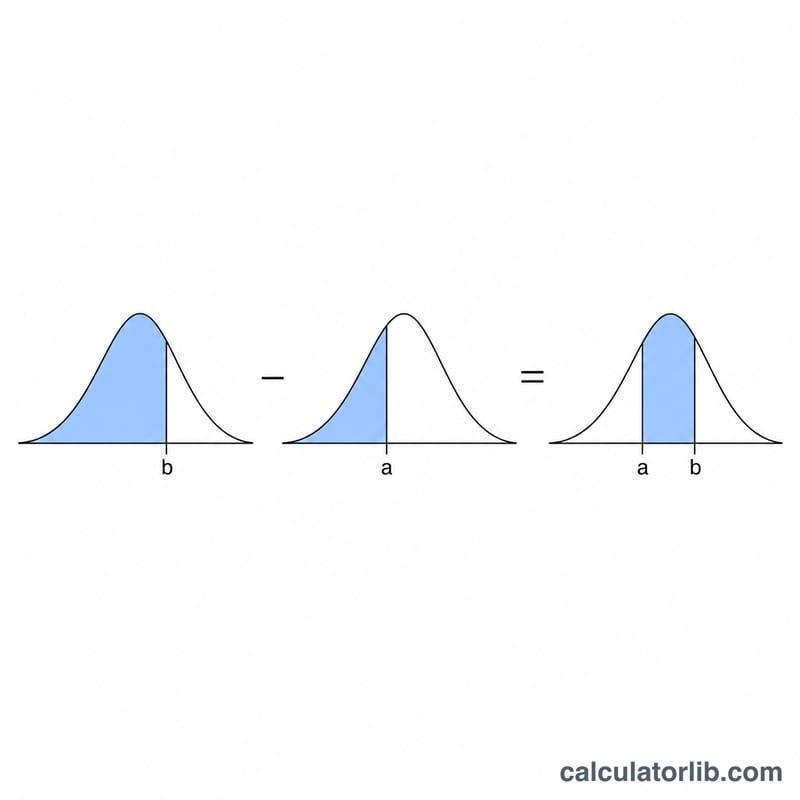
Вероятность попадания между a и b равна значению функции распределения (CDF) в точке b минус её значение в точке a:
$$P(a < X < b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)$$Выражение \(\frac{x-\mu}{\sigma}\) превращает исходное значение в z-оценку — число стандартных отклонений от среднего. \(\Phi(z)\) даёт накопленную площадь слева от z под стандартной нормальной кривой. Вычитая одну накопленную площадь из другой, мы получаем площадь строго между a и b. Этот калькулятор вычисляет \(\Phi\) через высокоточное приближение функции ошибок.
Пример расчёта
Допустим, показатели IQ распределены нормально с \(\mu = 100\) и \(\sigma = 15\), и нужно найти \(P(85 < X < 115)\). z-оценки равны
$$\frac{85-100}{15} = -1 \quad \text{и} \quad \frac{115-100}{15} = +1$$\(\Phi(1) \approx 0{,}8413\) и \(\Phi(-1) \approx 0{,}1587\), поэтому вероятность
$$\approx 0{,}8413 - 0{,}1587 = 0{,}6827,$$то есть около 68,3% — знакомое «правило одного стандартного отклонения».
Частые вопросы
Важно ли, что я использую < или ≤? Нет. Для непрерывного нормального распределения вероятность попадания ровно в одну точку равна нулю, поэтому \(P(a < X < b)\) и \(P(a \le X \le b)\) совпадают.
А если стандартное отклонение равно 0? Стандартное отклонение должно быть положительным; при \(\sigma = 0\) распределение не определено, поэтому калькулятор возвращает 0.
Насколько точен результат? Функция распределения вычисляется по приближению Абрамовица и Стиган с точностью примерно до 7 знаков после запятой — этого с запасом хватает для типичных статистических задач.
Общие нормальные вероятности и справочник z-оценок
Для стандартной нормальной случайной величины \(Z\) (среднее 0, стандартное отклонение 1) вероятность попасть в пределы \(z\) стандартных отклонений от среднего равна \(P(-z<Z<z)=2\Phi(z)-1\). Эти значения справедливы для любого нормального распределения, после того как x переведён в z-оценку.
| z | P(-z < Z < z) | Процент |
|---|---|---|
| 1 | 0.6827 | 68.27% |
| 1.645 | 0.9000 | 90.00% |
| 1.96 | 0.9500 | 95.00% |
| 2 | 0.9545 | 95.45% |
| 2.576 | 0.9900 | 99.00% |
| 3 | 0.9973 | 99.73% |
Правило 68-95-99.7
- Около 68% значений лежат в пределах \(\mu \pm 1\sigma\).
- Около 95% лежат в пределах \(\mu \pm 2\sigma\) (точнее 95.45%).
- Около 99.7% лежат в пределах \(\mu \pm 3\sigma\) (точнее 99.73%).
Значения 1.645, 1.96 и 2.576 округлены до трёх знаков после запятой, поэтому и вероятности для них также округлены.
Интерпретация вашей вероятности
Результат \(P(a<X<b)\) — это доля распределения, лежащая между \(a\) и \(b\). Результат 0.8186 означает, что около 81.86% наблюдений, как ожидается, попадут в этот диапазон. Иначе говоря, случайно выбранное наблюдение имеет такой шанс оказаться в этом диапазоне.
z-оценка показывает, на сколько стандартных отклонений значение отстоит от среднего. \(z=0\) соответствует среднему, \(z=2\) — на два стандартных отклонения выше него, а \(z=-1\) — на одно ниже. Сравнение \(z_a\) и \(z_b\) показывает, насколько широк ваш интервал в единицах стандартного отклонения.
Вы можете сравнить свой ответ с эмпирическим правилом. Интервал \(\mu\pm1\sigma\) даёт около 0.68, \(\mu\pm2\sigma\) — около 0.95, а \(\mu\pm3\sigma\) — около 0.997. Если ваш интервал уже одного из них, ожидайте меньшей вероятности.
- Очень малые значения (например, меньше 0.01) означают, что интервал узкий или находится далеко в хвосте распределения. Такие исходы редки при данной модели.
- Значения, близкие к 1, означают, что интервал охватывает почти всё распределение. Оставшаяся вероятность приходится на хвосты за пределами \(a\) и \(b\).
Расчёт предполагает, что величина действительно нормально распределена со средним и стандартным отклонением, которые вы ввели. Реальные данные могут быть асимметричными или иметь более тяжёлые хвосты, что делает вероятности в хвостах менее надёжными. Проверьте это предположение с помощью гистограммы или графика нормальной вероятности. Если вы оценивали \(\mu\) и \(\sigma\) по небольшой выборке, результат лишь приблизительный.