這個計算器能做什麼
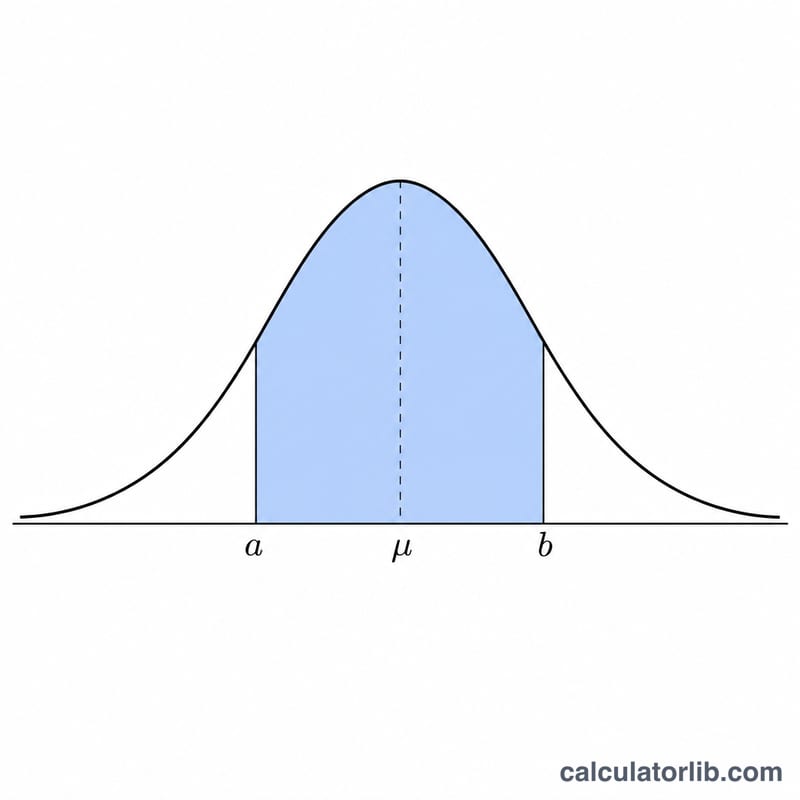
本工具用來計算服從常態分布的隨機變數 X 落在兩個數值 a 與 b 之間的機率,也就是 \(P(a < X < b)\)。你只要輸入分布的平均數(\(\mu\))、標準差(\(\sigma\)),以及上下兩個邊界值即可。計算器會先把每個邊界值標準化成 z 分數,再透過標準常態累積分布函數 \(\Phi\),精準算出鐘形曲線在這兩點之間的面積。
使用方法
先填入分布的平均數與標準差,接著輸入較小的數值 a 和較大的數值 b,按下計算即可。結果會以小數(0 到 1)和百分比兩種形式呈現機率,同時列出兩個 z 分數。即使你不小心把大小順序填反,計算器也會自動把較小者當作 a、較大者當作 b。
公式說明
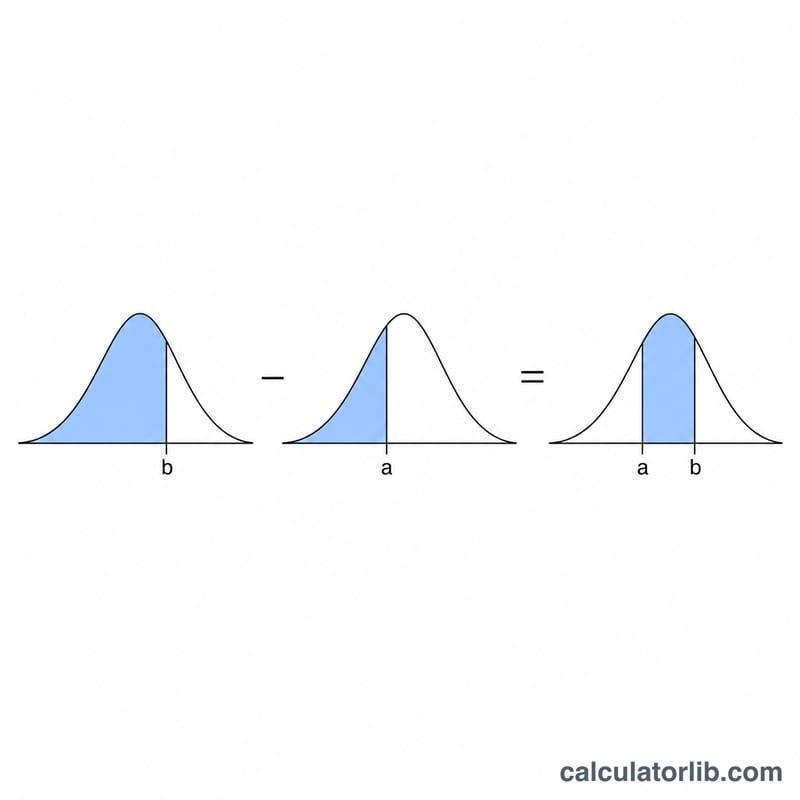
a 與 b 之間的機率,等於 b 點的累積分布函數值減去 a 點的累積分布函數值:
$$P(a < X < b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)$$其中 \((x-\mu)/\sigma\) 會把原始分數換算成 z 分數,也就是距離平均數有幾個標準差。\(\Phi(z)\) 代表標準常態曲線中 z 左側的累積面積。把兩個累積面積相減,剩下的正好是 a 與 b 之間的面積。本計算器以高精度的誤差函數近似法計算 \(\Phi\)。
實例演算
假設智商(IQ)分數呈常態分布,\(\mu = 100\)、\(\sigma = 15\),而你想求 \(P(85 < X < 115)\)。兩個 z 分數分別為 \((85-100)/15 = -1\) 和 \((115-100)/15 = +1\)。由於 \(\Phi(1) \approx 0.8413\)、\(\Phi(-1) \approx 0.1587\),因此機率 \(\approx 0.8413 - 0.1587 = 0.6827\),約等於 68.3%——這正是大家熟悉的「一個標準差法則」。
常見常態機率與 Z 分數參考表
對於標準常態變數 \(Z\)(平均數 0、標準差 1),落在平均數正負 \(z\) 個標準差範圍內的機率為 \(P(-z<Z<z)=2\Phi(z)-1\)。只要將 x 轉換為 z 分數,這些數值適用於任何常態分布。
| z | P(-z < Z < z) | 百分比 |
|---|---|---|
| 1 | 0.6827 | 68.27% |
| 1.645 | 0.9000 | 90.00% |
| 1.96 | 0.9500 | 95.00% |
| 2 | 0.9545 | 95.45% |
| 2.576 | 0.9900 | 99.00% |
| 3 | 0.9973 | 99.73% |
68-95-99.7 法則
- 約 68% 的數值落在 \(\mu \pm 1\sigma\) 範圍內。
- 約 95% 的數值落在 \(\mu \pm 2\sigma\) 範圍內(更精確為 95.45%)。
- 約 99.7% 的數值落在 \(\mu \pm 3\sigma\) 範圍內(更精確為 99.73%)。
數值 1.645、1.96 和 2.576 已四捨五入至小數點後三位,因此這些數值對應的機率也經過四捨五入。
解讀你的機率
結果 \(P(a<X<b)\) 是分布中位於 \(a\) 與 \(b\) 之間的比例。若結果為 0.8186,表示預期約有 81.86% 的觀測值會落在該範圍內。換句話說,隨機選出的一個觀測值落在該範圍內的機會即為此數值。
z 分數說明某個數值距離平均數有多少個標準差。\(z=0\) 為平均數,\(z=2\) 表示高於平均數兩個標準差,\(z=-1\) 則表示低於平均數一個標準差。比較 \(z_a\) 與 \(z_b\),可看出你的區間以標準差為單位有多寬。
你可以將答案與經驗法則比較。區間 \(\mu\pm1\sigma\) 約為 0.68,\(\mu\pm2\sigma\) 約為 0.95,\(\mu\pm3\sigma\) 約為 0.997。若你的區間比其中任何一個更窄,預期機率會較小。
- 非常小的數值(例如低於 0.01)表示區間很窄,或位於遠離中心的尾部。在此模型下,這類結果很罕見。
- 接近 1 的數值表示區間涵蓋幾乎整個分布。剩餘的機率位於 \(a\) 與 \(b\) 之外的尾部。
此計算假設變數確實服從常態分布,且平均數與標準差即為你所輸入的數值。實際資料可能有偏態或較厚的尾部,這會使尾部機率的可靠度降低。可以用直方圖或常態機率圖檢查此假設。若你是由小樣本估計 \(\mu\) 與 \(\sigma\),結果只是近似值。
常見問題
用 \(<\) 還是 \(\le\) 有差別嗎?沒有差別。對於連續型常態分布來說,任何單一點的機率都是零,所以 \(P(a < X < b)\) 與 \(P(a \le X \le b)\) 完全相同。
如果標準差是 0 怎麼辦?標準差必須為正值;當 \(\sigma = 0\) 時分布無法定義,因此計算器會回傳 0。
計算結果有多精準?本計算器採用 Abramowitz & Stegun 近似法計算累積分布函數,精度約達小數點後 7 位,對一般統計運算來說綽綽有餘。