Bu hesaplayıcı ne işe yarar?
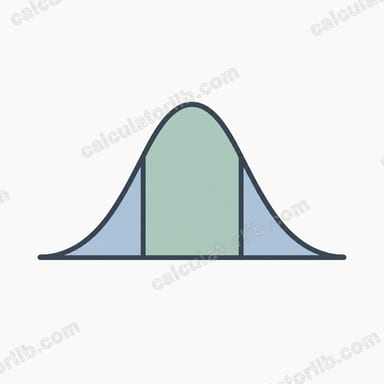
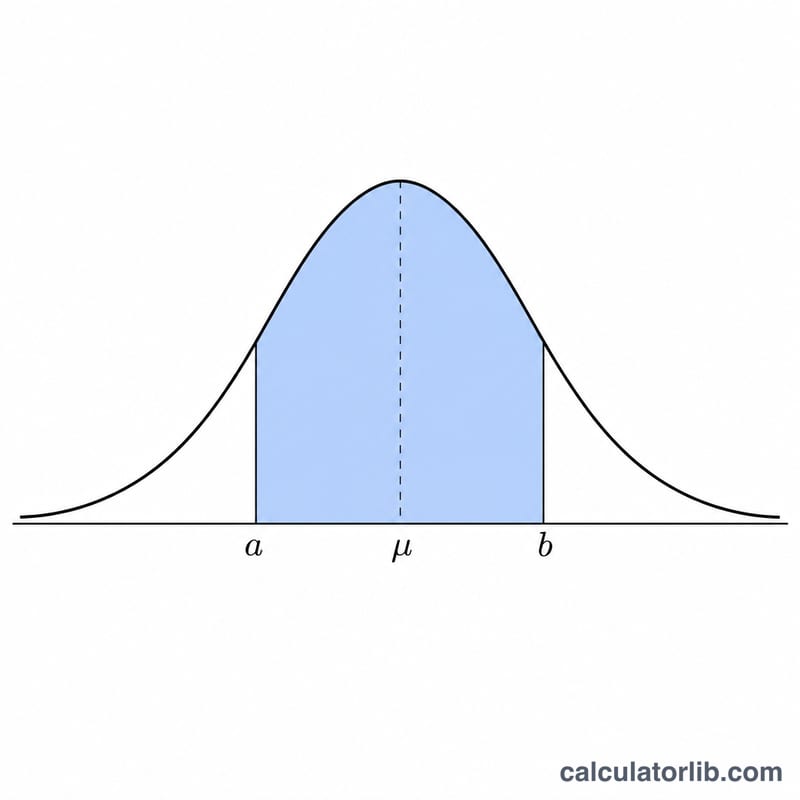
Bu araç, normal dağılım gösteren bir rastgele değişken X'in a ile b değerleri arasında yer alma olasılığını hesaplar; matematiksel olarak \(P(a < X < b)\) şeklinde yazılır. Dağılımın ortalamasını (\(\mu\)), standart sapmasını (\(\sigma\)) ve iki sınır değerini girersiniz. Hesaplayıcı her sınırı bir z-skoruna dönüştürür ve standart normal birikimli dağılım fonksiyonu \(\Phi\)'yi kullanarak çan eğrisinin bu iki değer arasında kalan alanını tam olarak verir.
Nasıl kullanılır?
Önce dağılımınızın ortalamasını ve standart sapmasını girin, ardından alt değer a ile üst değer b'yi yazın. "Hesapla" butonuna basın. Sonuç, olasılığı hem ondalık biçimde (0 ile 1 arasında) hem de yüzde olarak gösterir; ayrıca iki z-skorunu da görürsünüz. Değerleri ters sırayla girerseniz endişelenmeyin: hesaplayıcı küçük olanı otomatik olarak a, büyük olanı b kabul eder.
Formülün açıklaması
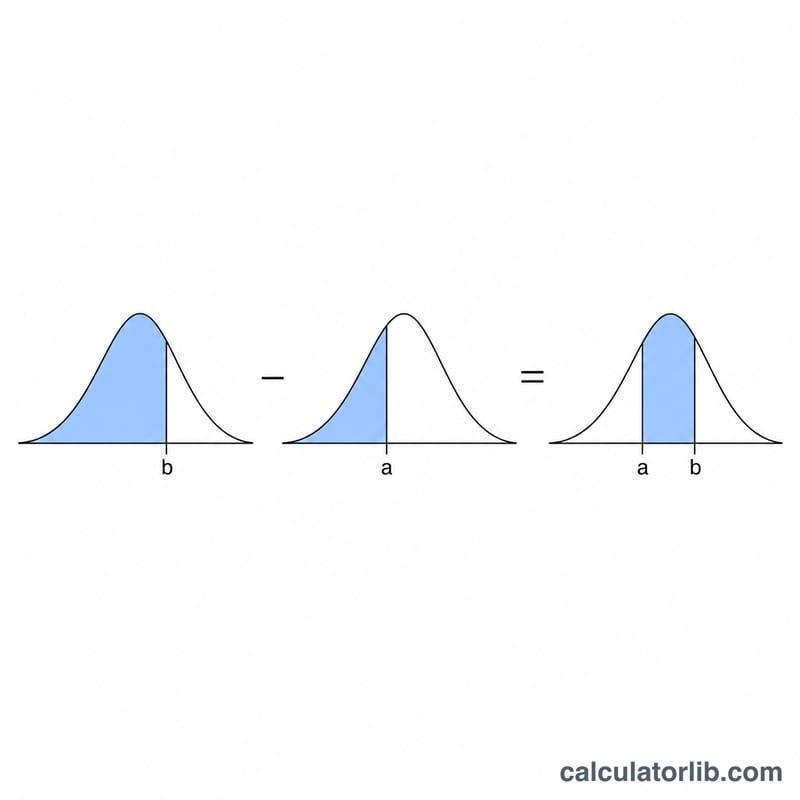
a ile b arasındaki olasılık, b noktasındaki CDF değerinden a noktasındaki CDF değerinin çıkarılmasıyla bulunur:
$$P(a < X < b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)$$Buradaki \((x-\mu)/\sigma\) ifadesi ham bir değeri z-skoruna çevirir; yani değerin ortalamadan kaç standart sapma uzakta olduğunu söyler. \(\Phi(z)\) ise standart normal eğride z'nin solunda kalan birikimli alanı verir. İki birikimli alanı birbirinden çıkardığınızda yalnızca a ile b arasında kalan alan geriye kalır. Bu hesaplayıcı \(\Phi\) değerini yüksek doğrulukta bir hata fonksiyonu yaklaşımıyla hesaplar.
Çözümlü örnek
Diyelim ki IQ puanları \(\mu = 100\) ve \(\sigma = 15\) ile normal dağılıyor ve \(P(85 < X < 115)\) olasılığını merak ediyorsunuz. z-skorları
$$\frac{85-100}{15} = -1 \quad \text{ve} \quad \frac{115-100}{15} = +1$$olur. \(\Phi(1) \approx 0{,}8413\) ve \(\Phi(-1) \approx 0{,}1587\) olduğundan olasılık
$$\approx 0{,}8413 - 0{,}1587 = 0{,}6827$$yani yaklaşık %68,3 çıkar — bu da bildiğimiz "bir standart sapma" kuralıdır.
Sık sorulan sorular
< ile ≤ kullanmak arasında fark var mı? Hayır. Sürekli bir normal dağılımda herhangi bir tek noktanın olasılığı sıfırdır; dolayısıyla \(P(a < X < b)\) ile \(P(a \le X \le b)\) tamamen aynıdır.
Standart sapmam 0 ise ne olur? Standart sapma pozitif olmak zorundadır. \(\sigma = 0\) olduğunda dağılım tanımlı değildir, bu nedenle hesaplayıcı 0 döndürür.
Sonuç ne kadar doğru? CDF, Abramowitz & Stegun yaklaşımıyla hesaplanır ve yaklaşık 7 ondalık basamağa kadar doğrudur — günlük istatistik çalışmaları için fazlasıyla yeterli.
Ortak Normal Olasılıklar ve Z-Skoru Referansı
Standart normal bir \(Z\) değişkeni için (ortalama 0, standart sapma 1), değerin ortalamadan \(z\) standart sapma içinde kalma olasılığı \(P(-z<Z<z)=2\Phi(z)-1\) ile verilir. Bu değerler, x değeri bir z-skoruna dönüştürüldükten sonra herhangi bir normal dağılım için geçerlidir.
| z | P(-z < Z < z) | Yüzde |
|---|---|---|
| 1 | 0.6827 | %68.27 |
| 1.645 | 0.9000 | %90.00 |
| 1.96 | 0.9500 | %95.00 |
| 2 | 0.9545 | %95.45 |
| 2.576 | 0.9900 | %99.00 |
| 3 | 0.9973 | %99.73 |
68-95-99.7 kuralı
- Değerlerin yaklaşık %68'i \(\mu \pm 1\sigma\) aralığında yer alır.
- Yaklaşık %95'i \(\mu \pm 2\sigma\) aralığında yer alır (daha kesin olarak %95.45).
- Yaklaşık %99.7'si \(\mu \pm 3\sigma\) aralığında yer alır (daha kesin olarak %99.73).
1.645, 1.96 ve 2.576 değerleri üç ondalık basamağa yuvarlanmıştır; bu nedenle bunlara karşılık gelen olasılıklar da yuvarlanmıştır.
Olasılığınızı Yorumlama
\(P(a<X<b)\) sonucu, dağılımın \(a\) ile \(b\) arasında kalan oranıdır. 0.8186 sonucu, gözlemlerin yaklaşık %81.86'sının bu aralığa düşmesinin beklendiği anlamına gelir. Eşdeğer olarak, rastgele seçilen bir gözlemin bu aralığa düşme şansı budur.
Z-skoru, bir değerin ortalamadan kaç standart sapma uzakta olduğunu gösterir. \(z=0\) ortalamadır, \(z=2\) ortalamanın iki standart sapma üstündedir ve \(z=-1\) ise bir standart sapma altındadır. \(z_a\) ile \(z_b\) değerlerini karşılaştırmak, aralığınızın standart sapma birimlerinde ne kadar geniş olduğunu gösterir.
Cevabınızı ampirik kuralla karşılaştırabilirsiniz. \(\mu\pm1\sigma\) aralığı yaklaşık 0.68, \(\mu\pm2\sigma\) yaklaşık 0.95 ve \(\mu\pm3\sigma\) yaklaşık 0.997 verir. Aralığınız bunlardan birinden daha darsa, daha küçük bir olasılık beklemelisiniz.
- Çok küçük değerler (örneğin 0.01'in altında), aralığın dar olduğunu veya kuyruğun çok uzağında bulunduğunu gösterir. Bu model altında bu tür sonuçlar nadirdir.
- 1'e yakın değerler, aralığın dağılımın neredeyse tamamını kapsadığı anlamına gelir. Kalan olasılık, \(a\) ve \(b\) dışındaki kuyruklarda yer alır.
Hesaplama, değişkenin girdiğiniz ortalama ve standart sapma ile gerçekten normal dağıldığını varsayar. Gerçek veriler çarpık olabilir veya daha ağır kuyruklara sahip olabilir; bu da kuyruk olasılıklarını daha az güvenilir kılar. Varsayımı bir histogram veya normal olasılık grafiği ile kontrol edin. \(\mu\) ve \(\sigma\) değerlerini küçük bir örneklemden tahmin ettiyseniz, sonuç yalnızca yaklaşıktır.