この臨界値計算ツールでできること
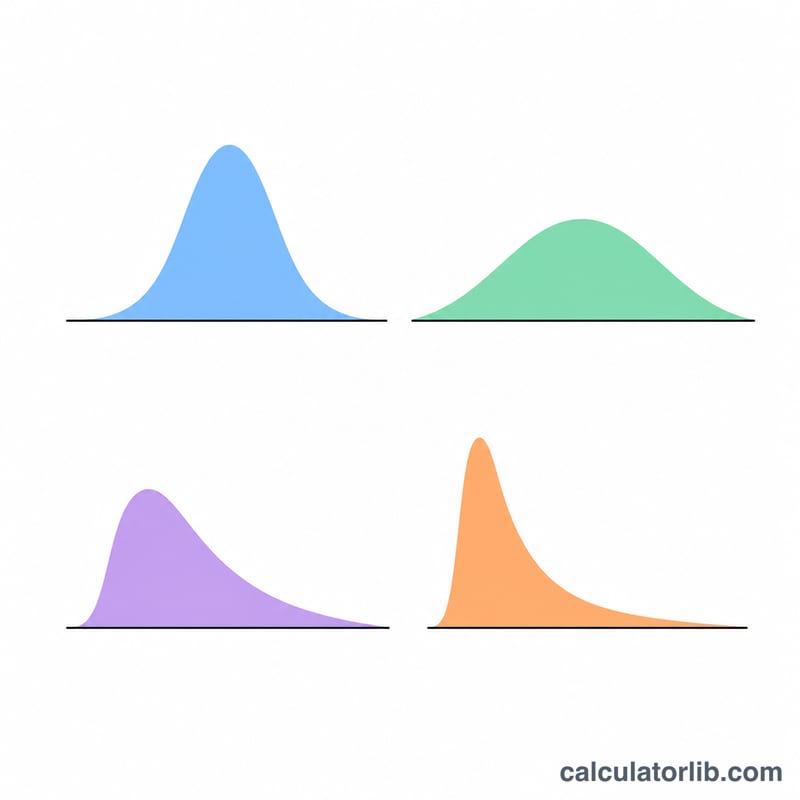
このツールは、統計的仮説検定や信頼区間の作成に欠かせない「臨界値」を求めるためのものです。臨界値とは、確率分布上で帰無仮説を棄却する領域と棄却しない領域を分ける境界点のこと。古い統計数値表を引っ張り出してにらめっこする必要はありません。いくつかの項目を入力するだけで、正規分布(Z)、スチューデントのt分布、カイ二乗分布(χ²)、F分布それぞれの正確な値がすぐに得られます。
入力項目の意味
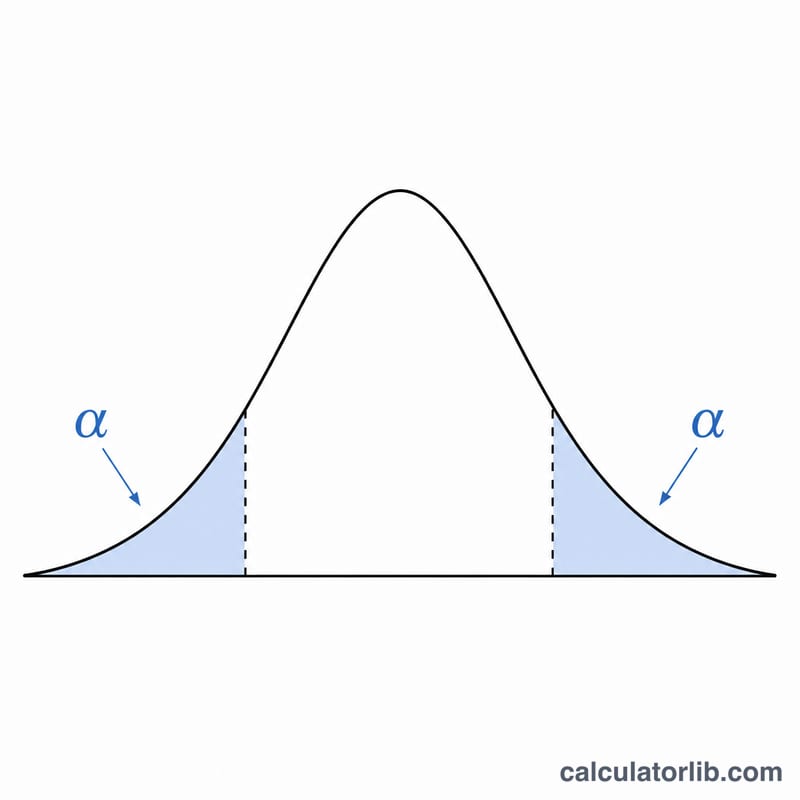
- 信頼水準(%) ― 例:95。ツールはこの値を有意水準アルファに変換します。計算式は \(\alpha = \frac{100 - \text{信頼水準}}{100}\)。信頼水準95%なら、\(\alpha = 0.05\) となります。
- 分布タイプ ― 正規分布(Z)、スチューデントのt分布、カイ二乗分布(χ²)、F分布から選びます。
- 自由度 ― t分布、カイ二乗分布、F分布で必要です。F分布の場合は分子の自由度を指します。
- 自由度(分母) ― F分布でのみ使用します。
計算の仕組み
このツールは、選んだ分布の累積分布関数の逆関数(分位点関数)を用いて計算します。
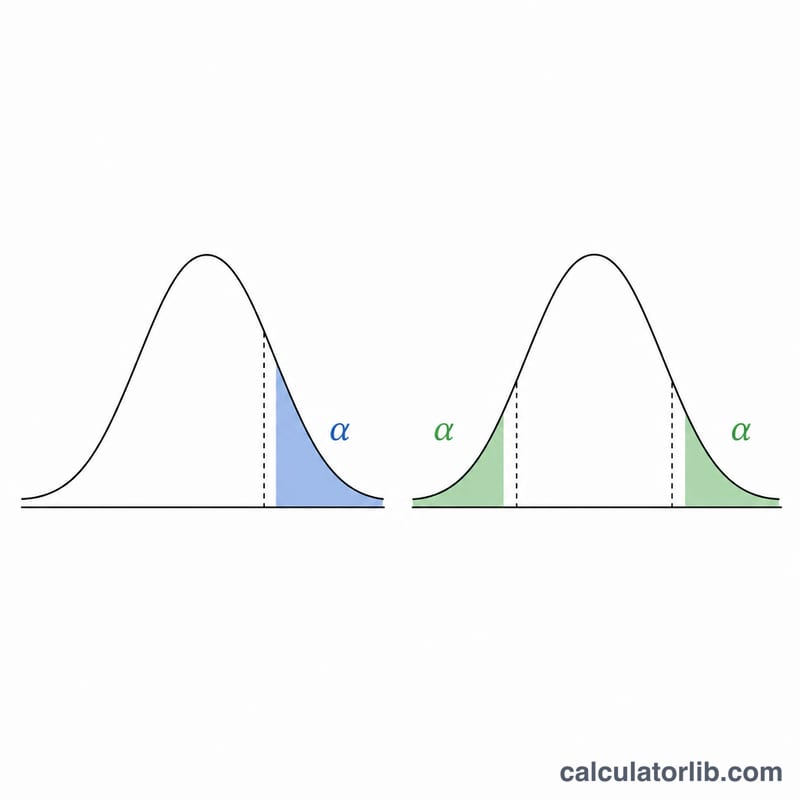
- 正規分布・t分布(両側): \(\text{臨界値} = \left| \text{inverseCDF}(\alpha / 2) \right|\)。アルファを左右両側の裾に均等に振り分けます。
- カイ二乗分布・F分布(右側): \(\text{臨界値} = \text{inverseCDF}(1 - \alpha)\)。アルファをすべて上側の裾に置きます。
計算例
たとえば、信頼水準95%・自由度20で両側のt検定を行う場合を考えましょう。\(\alpha = \frac{100 - 95}{100} = 0.05\) なので、\(\alpha / 2 = 0.025\) です。ツールは自由度20のt分布について 0.025 における逆累積分布関数を評価し、その絶対値を返します。結果、臨界値はおよそ 2.086 となります。検定統計量の絶対値がこの 2.086 を超えれば、帰無仮説を棄却します。
信頼水準95%・自由度10のカイ二乗検定なら、\(\text{inverseCDF}(0.95)\) を計算して約 18.31 が得られます。
臨界値の解釈
臨界値は棄却領域の境界であり、分布の水平軸上の点であり、この点を超えた検定統計量は、選択した有意水準 \(\alpha\) においては、偶然だけでは説明できないほど極端であると見なされます。
判定ルール
- 両側 Z または t 検定。 帰無仮説 \(H_0\) を、\(|\text{検定統計量}| \ge\) 臨界値 のときに棄却します;それ以外は棄却しません。棄却領域は両側の尾部であり、それぞれが面積 \(\alpha/2\) を含みます。
- 片側 Z または t 検定。 右側検定の場合、統計量が \(\ge +\) 臨界値 のときに棄却します;左側検定の場合、統計量が \(\le -\) 臨界値 のときに棄却します。単一の尾部は全面積 \(\alpha\) を含みます。
- カイ二乗検定と F 検定。 これらは上側検定として使用されます: \(H_0\) を棄却するのは統計量が上側臨界値を超える場合で、それ以外は棄却しません。両方の統計量は非負であり、より大きな値は帰無仮説からのより大きな乖離を意味します。
等価な p 値ルール
統計量を臨界値と比較することと p 値を \(\alpha\) と比較することは、同じ判定の 2 つの説明であり、常に一致します:
$$\text{棄却 } H_0 \iff |T| \ge c_{\alpha} \iff p \le \alpha$$これが成り立つのは、臨界値 \(c_{\alpha}\) が、尾確率がちょうど \(\alpha\) である統計量として定義されているためです。\(T = c_{\alpha}\) では p 値は正確に \(\alpha\) に等しく、尾部側にあるほど p 値は小さく、中心に近いほど大きくなります。例えば、95% 信頼度での両側 z 検定では、\(z = 2.30\) は 1.960 を超え、その両側 p 値は約 0.021 であり、0.05 以下です — どちらの方法でも同じ棄却結果が得られます。
臨界値のサイズが示すもの
- より大きな臨界値はより厳しい検定を意味します。 信頼度を上げると \(\alpha\) が低下し、境界が外側に移動します: 99% で 2.576 対 95% で 1.960。統計量 2.10 は 95% では棄却されますが 99% では棄却されないため、有意水準はデータを見る前に固定する必要があります。
- t 臨界値は自由度が増加するにつれて Z に向かって縮小します。 自由度が少ないと標準誤差の推定が不正確になるため、t 分布はより厚い尾部を持ち、より多くの証拠を必要とします: df = 5 で 2.571 対 df = 30 で 2.042、および極限で 1.960。
- カイ二乗と F の臨界値は、カイ二乗については自由度とともに上昇します —(t とは反対方向)統計量がより多くの項を合計するためです。したがって、カイ二乗 20 は df = 5(臨界値 11.070)では極端ですが、df = 20(臨界値 31.410)では極端ではありません。
棄却されないことが意味すること、意味しないこと
\(H_0\) を棄却しないことは、\(H_0\) が真実であることの証明ではありません。これは、選択した \(\alpha\) レベルで、データが帰無仮説に反する十分な証拠を与えなかったことを意味します — 帰無仮説が実際に真実である、検出できない程度の実効果が存在する、または検定力が不十分である標本サイズといった状況と同等に一貫性のある結果です。検定は棄却するか棄却しないかのいずれかのみ可能です;決して確認されません。
信頼区間との関連
棄却領域を定義する同じ臨界値は、対応する信頼区間の幅も設定します:
$$\text{推定値} \pm c_{\alpha} \times \text{標準誤差}$$水準 \(\alpha\) での両側検定は、\(100(1-\alpha)\%\) 信頼区間が \(\mu_0\) を除外する場合に限り、\(H_0: \mu = \mu_0\) を棄却します。標本平均が 52.0、標準誤差が 1.5、\(z_{\alpha/2} = 1.960\) の場合、95% 区間は \(52.0 \pm 1.960 \times 1.5 = 52.0 \pm 2.94\)、つまり 49.06 から 54.94 です — したがって帰無値が 50 の場合は棄却されませんが、48 の場合は棄却されます。
よくある質問
なぜZ/tの結果は両側になるのですか? このツールは正規分布とt分布についてアルファを2で割り、一般的な両側検定に対応させています。片側検定を行いたい場合は、信頼水準を調整して入力してください(例:片側95%の境界を再現するには90%を指定します)。
正規分布でも自由度は必要ですか? いいえ、不要です。Zの臨界値は信頼水準だけで決まります。自由度が関係するのはt分布、カイ二乗分布、F分布です。
分母の自由度はいつ入力しますか? F分布のときだけです。F分布は分子と分母の両方の自由度を必要とします(分散分析(ANOVA)や分散の比較などでよく使われます)。