임계값 계산기로 무엇을 할 수 있나요?
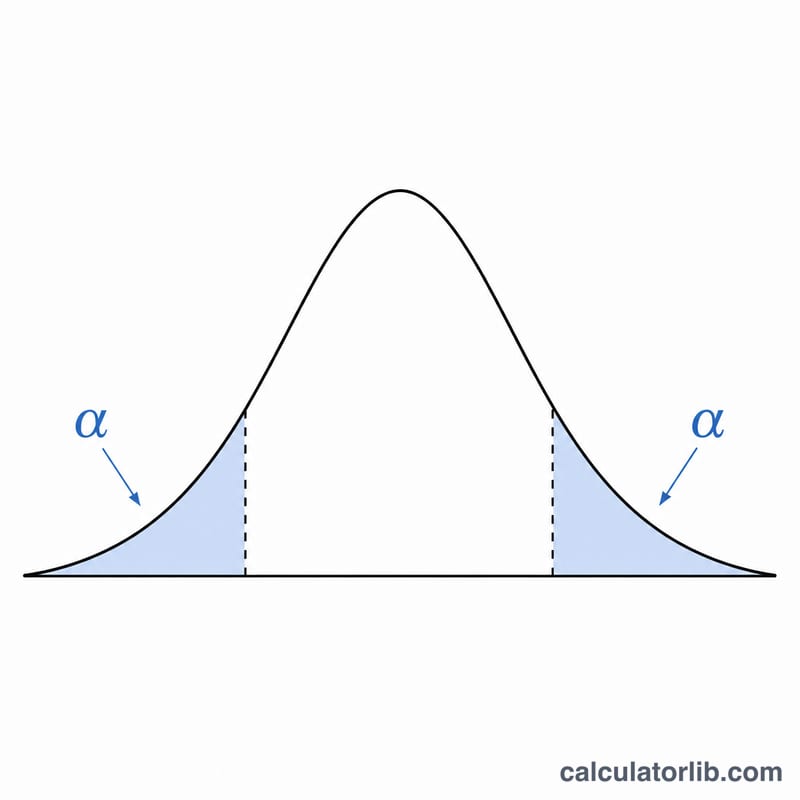
이 계산기는 통계적 가설 검정이나 신뢰구간을 구할 때 필요한 임계값(critical value)을 찾아 줍니다. 임계값이란 확률분포 위에서 귀무가설을 기각하는 영역과 기각하지 않는 영역을 나누는 경계점을 말합니다. 복잡한 통계표를 일일이 뒤질 필요 없이, 몇 가지 값만 입력하면 정규분포(Z), 스튜던트 t 분포, 카이제곱(χ²) 분포, F 분포의 임계값을 정확하게 얻을 수 있습니다.
입력 항목 설명
- 신뢰수준(%) – 예: 95. 계산기는 이 값을 다음 식으로 유의수준 알파(alpha)로 변환합니다. \( \alpha = \dfrac{100 - \text{신뢰수준}}{100} \). 신뢰수준이 95%이면 \( \alpha = 0.05 \)가 됩니다.
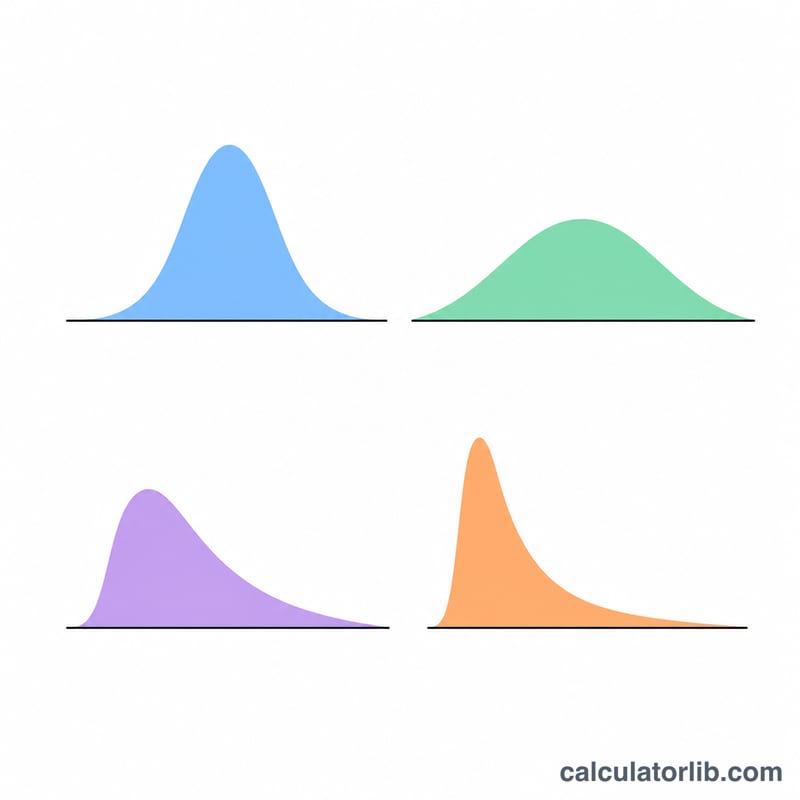
- 분포 유형 – 정규(Z), 스튜던트 t, 카이제곱(χ²), F 중에서 선택합니다.
- 자유도 – t, 카이제곱, F 분포에서 필요합니다. F 분포에서는 분자 자유도에 해당합니다.
- 자유도(분모) – F 분포에서만 사용됩니다.
계산에 쓰이는 공식
계산기는 선택한 분포의 역누적분포함수(분위수 함수)를 사용합니다.
- 정규분포 & t 분포(양측 검정): 임계값 = \( |\text{inverseCDF}(\alpha / 2)| \). 알파를 양쪽 꼬리에 나눠 배분합니다.
- 카이제곱 & F 분포(우측 검정): 임계값 = \( \text{inverseCDF}(1 - \alpha) \). 알파 전체를 위쪽 꼬리에 배치합니다.
계산 예시
신뢰수준 95%, 자유도 20에서 양측 t 검정을 한다고 가정해 봅시다. \( \alpha = (100 - 95) / 100 = 0.05 \)이므로 \( \alpha / 2 = 0.025 \)입니다. 계산기는 자유도 20인 t 분포의 역CDF를 0.025에서 평가한 뒤 절댓값을 취해, 약 2.086이라는 임계값을 돌려줍니다. 검정통계량의 절댓값이 2.086을 넘으면 귀무가설을 기각합니다.
신뢰수준 95%, 자유도 10인 카이제곱 검정이라면 \( \text{inverseCDF}(0.95) \approx \) 18.31을 계산합니다.
임계값 해석하기
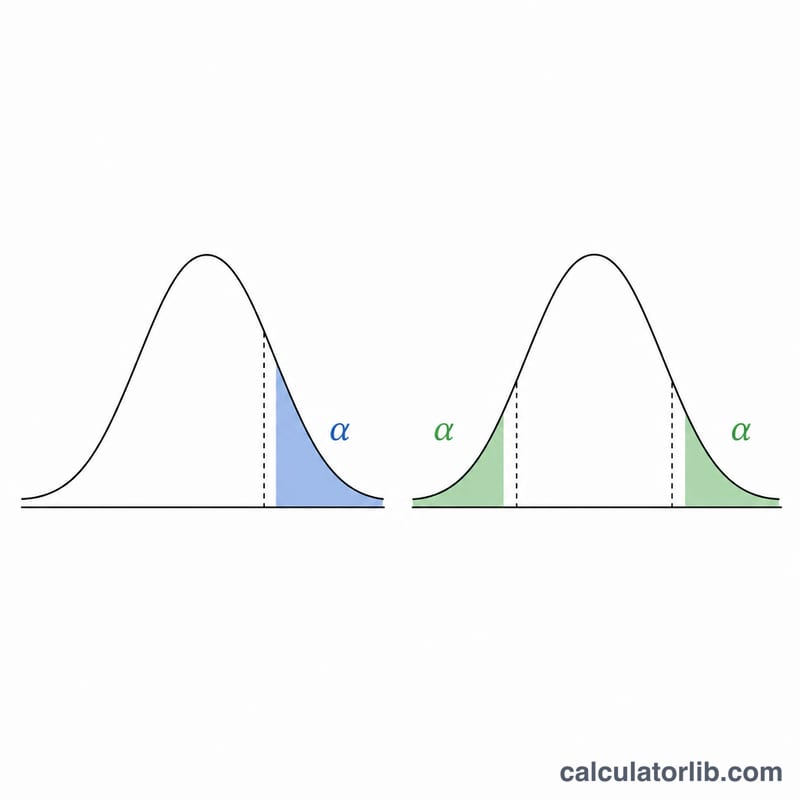
임계값은 기각 영역의 경계이며, 분포의 수평축 위의 점으로서 그 점을 넘어서면 검정 통계량이 선택한 유의 수준 \(\alpha\)에서 순수한 우연만으로는 설명할 수 없을 정도로 극단적이라고 간주됩니다.
의사결정 규칙
- 양측 Z 또는 t 검정. \(|\text{검정 통계량}| \ge\) 임계값일 때 귀무가설 \(H_0\)를 기각하고, 그렇지 않으면 기각하지 않습니다. 기각 영역은 양쪽 꼬리이며, 각각 면적 \(\alpha/2\)를 포함합니다.
- 단측 Z 또는 t 검정. 우측 검정에서는 통계량이 \(\ge +\) 임계값일 때 기각하고, 좌측 검정에서는 통계량이 \(\le -\) 임계값일 때 기각합니다. 단일 꼬리는 전체 면적 \(\alpha\)를 포함합니다.
- 카이제곱 검정과 F 검정. 이들은 상측 검정으로 사용됩니다. 통계량이 상측 임계값을 초과할 때 \(H_0\)를 기각하고, 그렇지 않으면 기각하지 않습니다. 두 통계량 모두 음이 아닌 값이며, 더 큰 값은 귀무가설로부터의 더 큰 이탈을 의미합니다.
동등한 p-값 규칙
통계량을 임계값과 비교하는 것과 p-값을 \(\alpha\)와 비교하는 것은 동일한 의사결정의 두 가지 표현이며, 항상 일치합니다:
$$\text{기각 } H_0 \iff |T| \ge c_{\alpha} \iff p \le \alpha$$이는 임계값 \(c_{\alpha}\)가 꼬리 확률이 정확히 \(\alpha\)인 통계량으로 정의되기 때문입니다. \(T = c_{\alpha}\)에서 p-값은 정확히 \(\alpha\)와 같고, 꼬리 쪽으로 더 나아간 통계량은 더 작은 p-값을 가지며, 중심에 더 가까운 것은 더 큰 p-값을 가집니다. 예를 들어, 95% 신뢰도에서의 양측 z 검정의 경우, \(z = 2.30\)은 1.960을 초과하고 그 양측 p-값은 약 0.021이며, 이는 0.05 미만입니다. 어느 경우든 동일한 기각 결정입니다.
임계값의 크기가 말해주는 것
- 더 큰 임계값은 더 엄격한 검정을 의미합니다. 신뢰 수준을 높이면 \(\alpha\)를 낮추고 경계를 바깥쪽으로 밀어냅니다. 99%에서 2.576 대 95%에서 1.960입니다. 2.10의 통계량은 95%에서는 기각되지만 99%에서는 기각되지 않습니다. 따라서 유의 수준은 데이터를 보기 전에 고정되어야 합니다.
- t 임계값은 자유도가 증가함에 따라 Z에 수렴합니다. 자유도가 적을 때는 표준 오차 자체가 제대로 추정되지 않으므로, t 분포는 더 무거운 꼬리를 가지고 더 많은 증거를 요구합니다. df = 5에서 2.571, df = 30에서 2.042, 극한에서 1.960입니다.
- 카이제곱과 F 임계값은 자유도에 대해 반대 방향으로 의존합니다. 통계량이 더 많은 항을 합산하기 때문에 자유도가 증가하면 임계값이 올라갑니다. 따라서 카이제곱 20은 df = 5에서 극단적입니다(임계값 11.070). 하지만 df = 20에서는 그렇지 않습니다(임계값 31.410).
기각 실패가 의미하는 것과 의미하지 않는 것
\(H_0\)를 기각하지 않는 것은 \(H_0\)가 참이라는 증명이 아닙니다. 이는 데이터가 선택한 \(\alpha\)에서 그에 대한 충분한 증거를 제공하지 않았음을 의미합니다. 이는 참인 귀무가설, 탐지하기에 너무 작은 실제 효과, 또는 충분한 검정력을 갖기에 너무 작은 표본 등과 동일하게 일치하는 결과입니다. 검정은 기각하거나 기각하지 않을 수만 있습니다. 절대 확증할 수 없습니다.
신뢰 구간과의 연결
기각 영역을 정의하는 동일한 임계값은 일치하는 신뢰 구간의 폭도 설정합니다:
$$\text{추정값} \pm c_{\alpha} \times \text{표준 오차}$$유의 수준 \(\alpha\)에서의 양측 검정은 \(100(1-\alpha)\%\) 신뢰 구간이 \(\mu_0\)를 제외할 때 정확히 \(H_0: \mu = \mu_0\)를 기각합니다. 표본 평균 52.0, 표준 오차 1.5, \(z_{\alpha/2} = 1.960\)의 경우, 95% 구간은 \(52.0 \pm 1.960 \times 1.5 = 52.0 \pm 2.94\)입니다. 즉, 49.06에서 54.94입니다. 따라서 귀무값 50은 기각되지 않지만, 귀무값 48은 기각됩니다.
자주 묻는 질문
Z/t 결과가 왜 양측 기준인가요? 정규분포와 t 분포에서는 표준적인 양측 검정에 맞춰 알파를 2로 나눕니다. 단측 검정을 하려면 그에 맞게 신뢰수준을 조정해 입력하세요(예: 단측 95% 경계를 얻으려면 90%를 사용).
정규분포에도 자유도가 필요한가요? 아니요. Z 임계값은 신뢰수준에만 의존합니다. 자유도는 t, 카이제곱, F 분포에서만 의미가 있습니다.
분모 자유도는 언제 입력하나요? F 분포에서만 입력합니다. F 분포는 분자와 분모 자유도가 모두 필요하며, 분산분석(ANOVA)이나 분산 비교에서 자주 쓰입니다.