臨界值計算機能幫你做什麼
這個計算機可以求出你在統計假設檢定或建立信賴區間時所需要的臨界值。所謂臨界值,就是機率分布上的一個分界點,用來區隔「拒絕虛無假設」與「不拒絕虛無假設」的範圍。你不必再翻找密密麻麻的統計表,只要輸入幾個欄位,就能立即得到常態(Z)、學生 t、卡方(χ²)或 F 分布的精確數值。
各欄位說明
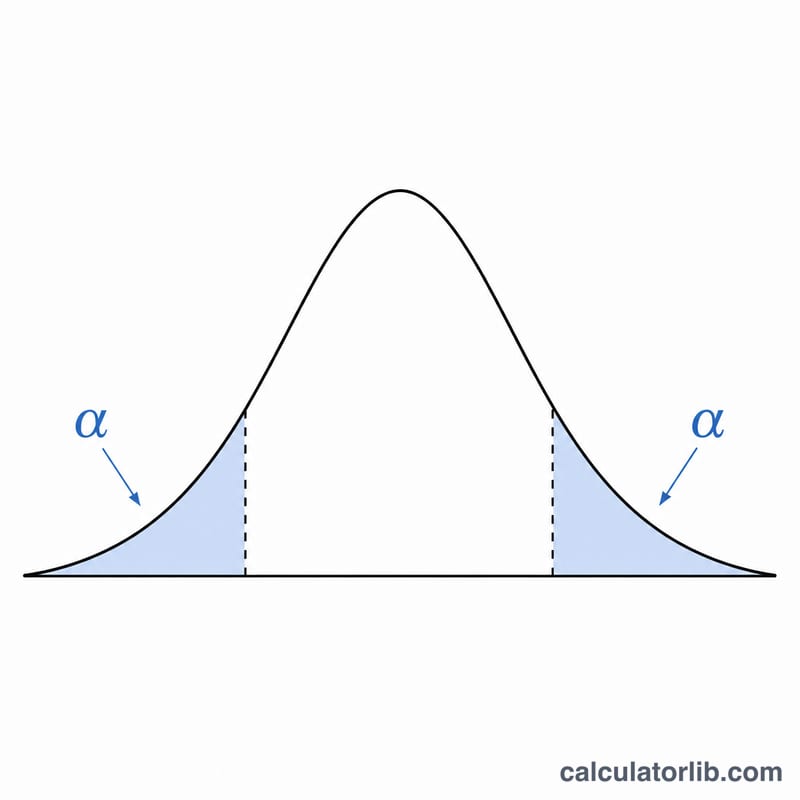
- 信賴水準(%)——例如 95。系統會將它換算成顯著水準 alpha,公式為 \( \alpha = \frac{100 - \text{信賴水準}}{100} \)。95% 的信賴水準對應 \( \alpha = 0.05 \)。
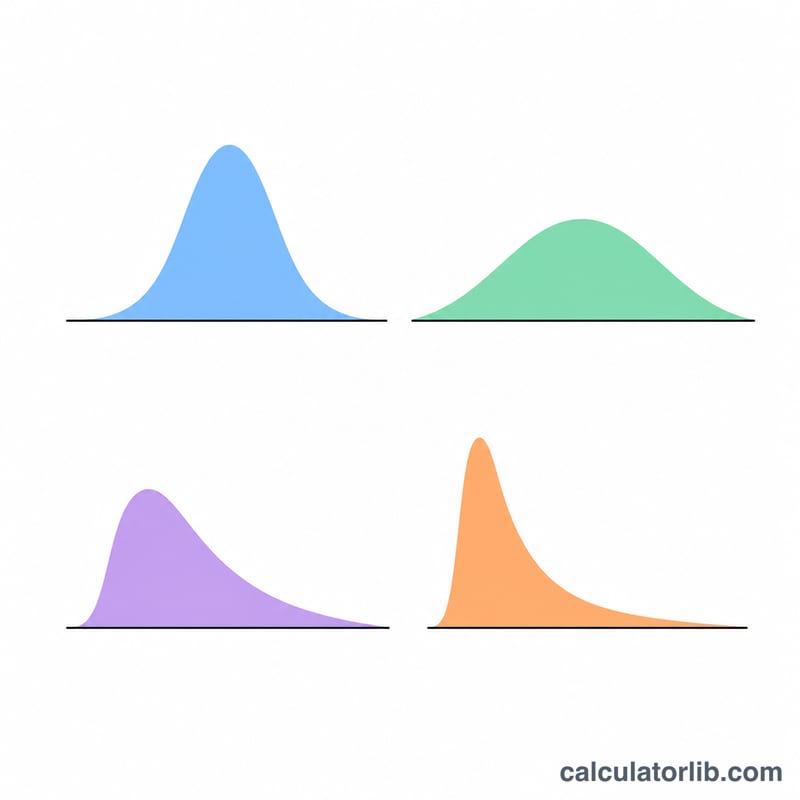
- 分布類型——可選擇常態(Z)、學生 t、卡方(χ²)或 F。
- 自由度——t、卡方與 F 分布皆需填寫。在 F 分布中,此欄為分子自由度。
- 自由度(分母)——僅 F 分布需要使用。
背後的計算公式
計算機使用所選分布的反累積分布函數(即分位數函數):
- 常態與 t(雙尾):臨界值 \( = |\text{inverseCDF}(\alpha / 2)| \)。\( \alpha \) 被平均分配到左右兩個尾端。
- 卡方與 F(右尾):臨界值 \( = \text{inverseCDF}(1 - \alpha) \),全部的 \( \alpha \) 都放在上尾。
實際範例
假設你在 95% 信賴水準下進行雙尾 t 檢定,自由度為 20。此時 \( \alpha = \frac{100 - 95}{100} = 0.05 \),因此 \( \alpha / 2 = 0.025 \)。計算機會在自由度 20 的 t 分布上計算 0.025 的反累積分布函數,並取絕對值,得到的臨界值約為 2.086。如果你的檢定統計量絕對值超過 2.086,就可以拒絕虛無假設。
若改為 95% 信賴水準、自由度 10 的卡方檢定,則計算 \( \text{inverseCDF}(0.95) \approx \) 18.31。
解釋您的臨界值
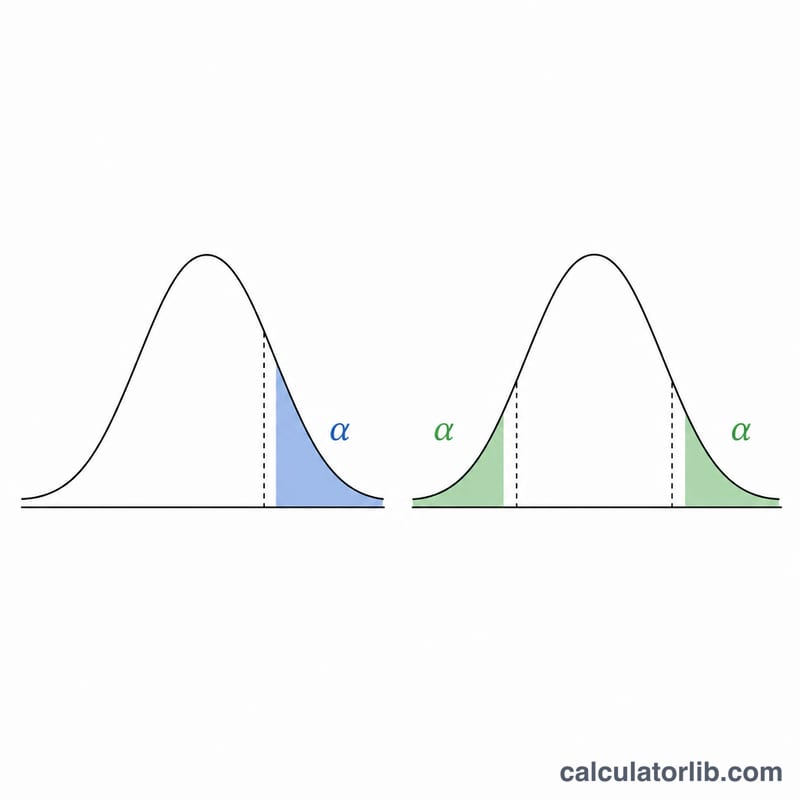
臨界值是棄卻域的邊界——在分布的水平軸上的點,超過此點的檢驗統計量被認為太極端,無法在您選定的顯著性水準 \(\alpha\) 下歸因於隨機波動。
決策規則
- 雙尾Z或t檢驗。當 \(|\text{檢驗統計量}| \ge\) 臨界值時棄卻虛無假設 \(H_0\);否則不棄卻。棄卻域在兩條尾部,每條尾部包含面積 \(\alpha/2\)。
- 單尾Z或t檢驗。對於右尾對立假設,當統計量 \(\ge +\) 臨界值時棄卻;對於左尾對立假設,當統計量 \(\le -\) 臨界值時棄卻。單條尾部包含完整面積 \(\alpha\)。
- 卡方及F檢驗。這些被用作上尾檢驗:當統計量超過上臨界值時棄卻 \(H_0\),否則不棄卻。兩個統計量都非負,較大的值表示偏離虛無假設的程度更大。
等價的p值規則
將統計量與臨界值比較和將p值與 \(\alpha\) 比較是同一決策的兩種描述方式,它們總是一致的:
$$\text{棄卻 } H_0 \iff |T| \ge c_{\alpha} \iff p \le \alpha$$這是因為臨界值 \(c_{\alpha}\) 的定義是其尾部概率恰好為 \(\alpha\) 的統計量。在 \(T = c_{\alpha}\) 時p值恰好等於 \(\alpha\);進一步進入尾部的統計量有更小的p值,而靠近中心的統計量有更大的p值。例如,在95%信心水準下進行雙尾z檢驗,\(z = 2.30\) 超過1.960,其雙尾p值約為0.021,低於0.05——無論用哪種方式得出的棄卻結論都相同。
臨界值的大小告訴您什麼
- 較大的臨界值意味著更嚴格的檢驗。提高信心水準會降低 \(\alpha\) 並將邊界向外推移:99%時為2.576對上95%時的1.960。統計量2.10在95%時棄卻虛無假設但在99%時不棄卻,因此顯著性水準必須在查看數據前固定。
- 隨著自由度增加,t臨界值收斂到Z。自由度較少時標準誤本身估計不足,所以t分布有較重的尾部並要求更多的證據:自由度5時為2.571對上自由度30時的2.042以及極限中的1.960。
- 卡方及F臨界值對自由度的依賴方向相反——對於卡方,它們隨自由度增加而上升,因為統計量是更多項的和,所以自由度5時卡方20是極端的(臨界值11.070)但自由度20時不是(臨界值31.410)。
未棄卻虛無假設的含義和不含義
未能棄卻 \(H_0\) 不是 \(H_0\) 為真的證明。它意味著數據在選定的 \(\alpha\) 處沒有提供足夠的證據反對它——這個結果同樣符合真實虛無假設、真實效應太小而無法偵測或樣本太小無法具有足夠檢驗力的情況。檢驗只能棄卻或不棄卻;它永遠不會確認。
與信心區間的連結
定義棄卻域的相同臨界值也設置匹配的信心區間的寬度:
$$\text{估計值} \pm c_{\alpha} \times \text{標準誤}$$水準 \(\alpha\) 下的雙尾檢驗在 \(100(1-\alpha)\%\) 信心區間排除 \(\mu_0\) 時恰好棄卻 \(H_0: \mu = \mu_0\)。樣本平均數為52.0、標準誤為1.5且 \(z_{\alpha/2} = 1.960\),95%區間為 \(52.0 \pm 1.960 \times 1.5 = 52.0 \pm 2.94\),即49.06到54.94——所以虛無值50不會被棄卻,而虛無值48會被棄卻。
常見問題
為什麼 Z/t 的結果是雙尾的?對於常態與 t 分布,系統會把 \( \alpha \) 除以二,對應標準的雙尾(雙側)檢定。若要進行單尾檢定,可自行調整信賴水準(例如用 90% 來模擬單尾 95% 的界限)。
常態分布需要填自由度嗎?不需要。Z 臨界值只與信賴水準有關。自由度只在 t、卡方與 F 分布中才會用到。
什麼時候要填分母自由度?只有 F 分布需要,因為它同時需要分子與分母兩個自由度(常見於變異數分析 ANOVA 與變異數比較)。