LLM VRAM 요구량 계산기란?
이 도구는 대규모 언어 모델(LLM)을 추론(inference) 목적으로 로드하고 구동할 때 필요한 GPU 비디오 메모리(VRAM)가 어느 정도인지 추정해 줍니다. 필요한 메모리 용량은 무엇보다 모델의 파라미터 수와, 각 가중치를 저장하는 데 사용하는 수치 정밀도(precision)에 따라 결정됩니다. 여기에 안전·오버헤드 계수를 더하는 이유는, KV 캐시·활성화 값(activations)·CUDA 컨텍스트처럼 순수 가중치 외에 추가로 메모리를 차지하는 요소들을 반영하기 위해서입니다.
사용 방법
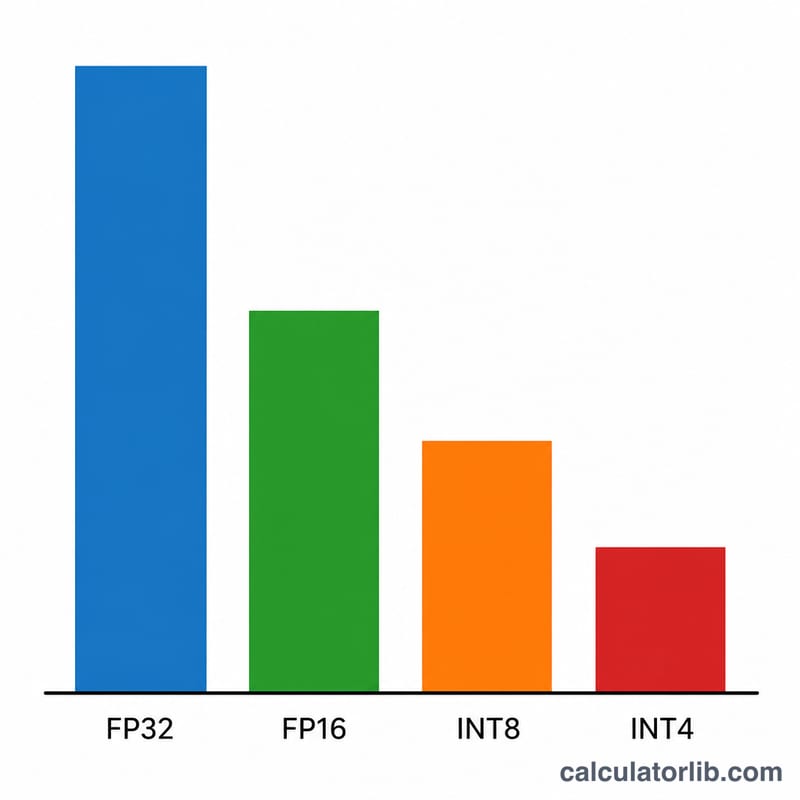
모델 크기를 10억(B) 단위 파라미터 수로 입력하세요. 예를 들어 7B 모델이라면 7, Llama-3 70B라면 70을 넣으면 됩니다. 다음으로 정밀도를 선택합니다. FP32는 가중치당 4바이트, FP16/BF16은 2바이트, INT8은 1바이트, INT4 양자화는 0.5바이트를 사용합니다. 마지막으로 오버헤드 계수를 설정하세요. 짧은 컨텍스트 추론이라면 1.2(20% 여유분)가 무난한 기본값이며, 긴 컨텍스트나 배치 처리에서는 값을 더 높여 주는 것이 좋습니다.
공식 설명
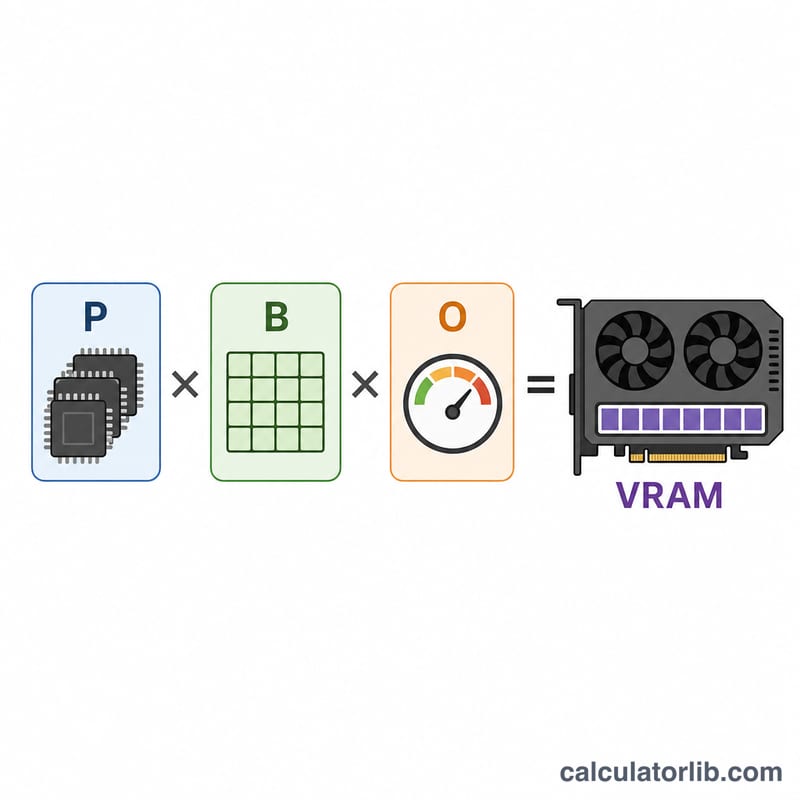
$$\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times \text{Overhead}$$ 10억 바이트 ≈ 1GB이므로, 10억 단위 파라미터 수에 파라미터당 바이트 수를 곱하면 곧바로 기가바이트 단위가 나옵니다. 여기에 오버헤드 계수를 곱하면 런타임에 실제로 소모되는 메모리까지 포함한 값으로 늘어납니다.
계산 예시
7B 모델을 FP16, 오버헤드 계수 1.2로 구동하는 경우: $$7 \times 2 \times 1.2 = 16.8\,\text{GB}$$ 24GB 그래픽카드라면 여유롭게 들어갑니다. 같은 모델을 INT4로 돌리면: $$7 \times 0.5 \times 1.2 = 4.2\,\text{GB}$$ 8GB GPU에서도 거뜬히 실행됩니다.
일반적인 모델 크기와 정밀도별 VRAM 추정치
표는 기본 오버헤드 1.2를 적용한 계산기 공식을 사용합니다: \(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\). 파라미터당 바이트 수는 FP16이 2, INT8이 1, INT4가 0.5입니다. "적합 여부" 메모는 각 결과를 단일 GPU의 공칭 용량과 비교한 것이며, 실제 사용 가능한 용량은 이보다 조금 더 적습니다.
| 모델 크기 | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
각 추정치에 필요한 GPU 등급
- 7B: FP16은 24 GB 카드가 필요합니다(16.8 GB는 16 GB에 비해 너무 큽니다). INT8은 16 GB에 적합합니다. INT4는 8 GB에 적합합니다.
- 13B: FP16은 48 GB가 필요합니다. INT8(15.6 GB)은 16 GB에 간신히 들어가므로 24 GB가 더 여유롭습니다. INT4(7.8 GB)는 8 GB에서 매우 빠듯하므로 실용적인 선택은 16 GB입니다.
- 34B: FP16(81.6 GB)은 단일 80 GB 카드를 초과하므로 여러 GPU가 필요합니다. INT8은 48 GB에 적합합니다. INT4는 24 GB에 적합합니다.
- 70B: FP16(168 GB)은 최소 3개의 80 GB GPU가 필요합니다. INT8(84 GB)은 80 GB 카드 하나를 초과하므로 GPU 2개가 필요합니다. 예를 들어 2×48 GB 또는 2×80 GB입니다. INT4(42 GB)는 48 GB에 적합합니다.
- 405B: 모든 정밀도에서 여러 GPU가 필요합니다. FP16은 최소 13개의 80 GB 카드, INT8은 최소 7개, INT4는 최소 4개가 필요합니다.
추정치가 카드 한 장의 메모리를 초과하면, 모델은 여러 GPU에 나누어 올려야 합니다(텐서 또는 파이프라인 병렬화). 이 경우 상호 연결 속도와 GPU별 오버헤드가 중요해지므로, 단순 나눗셈 결과보다 여유 공간을 추가로 확보하십시오.
형식별 파라미터당 바이트 수
| 형식 | 파라미터당 바이트 수 | 일반적인 용도 |
|---|---|---|
| FP32 | 4 | 학습 기준선, 연구, 수치에 민감한 작업; LLM 서빙에는 거의 사용되지 않음 |
| FP16 / BF16 | 2 | 표준 전체 품질 추론 및 공개된 체크포인트의 일반적인 저장 형식 |
| FP8 / INT8 | 1 | 지원되는 하드웨어와 소프트웨어에서 품질 손실이 적은 효율적인 서빙 |
| INT4 | 0.5 | 로컬 추론과 소비자용 GPU를 위한 공격적인 양자화, 일부 품질 손실 있음 |
실제 4비트 형식에 대한 참고: GGUF Q4_K_M, GPTQ, AWQ와 같은 실제 4비트 방식은 그룹별 스케일 및 기타 메타데이터를 저장합니다. 따라서 가중치당 0.5바이트보다 약간 많은, 대략 0.55~0.65바이트를 사용합니다. 이러한 형식에서는 오버헤드 계수를 조금 높이거나, INT4 결과를 약간 과소 추정된 값으로 간주하십시오.
사용 사례별 일반적인 오버헤드 계수
| 사용 사례 | 오버헤드 계수 |
|---|---|
| 짧은 컨텍스트, 단일 사용자 | 약 1.2 |
| 긴 컨텍스트 또는 중간 수준의 배칭 | 약 1.5~2.0 |
| 대량 배칭 또는 매우 긴 컨텍스트 서빙 | 2.0 이상 |
이것들은 고정된 표준이 아니라 경험에 따른 어림값입니다. 실제 값은 추론 엔진, 컨텍스트 길이, 동시 처리 수에 따라 달라집니다.
VRAM 추정치 해석하기
결과는 추론을 위한 대략적인 하한 성격의 추정치입니다. 가중치에 필요한 메모리를 계산하고, KV 캐시, 활성화 값, CUDA 컨텍스트, 프레임워크 버퍼를 위해 고정 비율을 더합니다. 이는 정확한 측정값이 아니며, 학습은 포함하지 않습니다. 학습에는 그래디언트와 옵티마이저 상태도 저장되므로 몇 배 더 많은 메모리가 필요할 수 있습니다.
KV 캐시가 확장되는 방식
KV 캐시는 컨텍스트 길이, 배치 크기, 레이어 수, 키/값 투영의 은닉 크기에 따라 선형으로 증가합니다:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
여기서 \(L\)은 레이어 수, \(d_{kv}\)는 키/값의 너비, \(T\)는 토큰 단위의 컨텍스트 길이, \(B\)는 배치 크기(동시 시퀀스 수), \(b\)는 캐시 요소당 바이트 수입니다. 계수 2는 키와 값을 모두 포함한다는 뜻입니다. 예를 들어 표준 멀티헤드 어텐션, 32개 레이어, 은닉 크기 4096, 4096 토큰의 FP16 캐시를 쓰는 모델은 \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) 바이트, 즉 시퀀스당 약 2.1 GB가 필요합니다. 그룹화된 쿼리 어텐션을 사용하는 모델은 \(d_{kv}\)가 더 작아서 캐시도 훨씬 작습니다. 긴 컨텍스트나 많은 동시 사용자가 있으면 캐시가 가중치와 비슷하거나 더 커질 수 있으므로, 이런 경우에는 오버헤드 계수를 높이십시오.
사용 가능한 메모리와 비교하기
추정치는 공칭 용량이 아니라 GPU의 사용 가능한 메모리와 비교하십시오. 드라이버, CUDA 컨텍스트, 디스플레이(GPU가 모니터도 구동하는 경우)가 메모리를 일부 차지하며, 추론 엔진은 보통 나머지의 일부를 예약해 둡니다. 24 GB로 판매되는 카드도 모델에 사용할 수 있는 용량은 일반적으로 눈에 띄게 적습니다. 추정치가 카드 용량의 몇 퍼센트 이내라면, 들어가지 않을 것으로 가정하십시오.
다중 GPU
텐서 병렬화를 사용하면 가중치와 KV 캐시가 GPU들에 나뉘므로, 각 카드는 전체의 대략 자기 몫만큼을 보유합니다. 그래도 각 GPU는 자체 CUDA 컨텍스트와 버퍼를 가지며, 통신 버퍼가 추가로 더해지므로 모든 GPU를 합친 총량은 단일 GPU 추정치보다 다소 높아집니다.
Mixture-of-Experts 모델
Mixture-of-Experts(MoE) 모델의 경우, 활성 파라미터 수가 아니라 전체 파라미터 수를 입력하십시오. 토큰마다 일부 전문가만 실행되어 연산량은 줄어들지만, 라우터가 어떤 전문가든 선택할 수 있도록 모든 전문가 가중치는 보통 VRAM에 상주해야 합니다.
이 내용은 계획 수립을 위한 일반 정보입니다. 실제 사용량은 사용하는 소프트웨어와 작업 부하로 직접 확인하십시오.
자주 묻는 질문
실제 사용량이 순수 가중치보다 큰 이유는 무엇인가요? KV 캐시는 컨텍스트 길이와 배치 크기에 따라 커지고, 프레임워크는 활성화 값과 버퍼를 위한 메모리를 추가로 예약합니다. 오버헤드 계수는 바로 이 부분을 어림잡아 반영한 값입니다.
학습(training)도 포함되나요? 아닙니다. 학습에는 옵티마이저 상태와 그래디언트를 위해 대략 3~4배 더 많은 메모리가 필요합니다. 이 계산기는 추론을 기준으로 합니다.
오버헤드는 얼마로 잡아야 하나요? 짧은 프롬프트에는 약 1.2를, 긴 컨텍스트나 무거운 배치 처리에는 1.5~2.0 이상을 사용하세요.