이 계산기의 기능
음이항분포 평균·분산 계산기는 음이항분포의 처음 두 적률(moment)을 반환합니다. 표준적인 "성공 전 실패 횟수" 매개변수화에서 확률변수 X는 독립적인 베르누이 시행의 수열에서 r번째 성공이 일어나기 전까지 발생하는 실패의 횟수를 셉니다. 여기서 각 시행은 확률 p로 성공합니다. r과 p를 입력하면 이 도구가 X의 평균, 분산, 표준편차를 알려 줍니다.
작동 방식
각 시행은 성공 확률 p가 일정한 독립적인 성공-또는-실패 실험입니다. r번의 성공이 쌓일 때까지 계속 표본을 뽑으며, X는 그 과정에서 관측된 실패의 횟수입니다. X는 각각 한 번의 성공 전 실패 횟수를 세는 r개의 독립적인 기하 변수의 합으로 쓸 수 있기 때문에, 그 평균과 분산은 하나의 기하 항의 평균과 분산의 정확히 r배가 됩니다. 이로부터 r과 p에만 의존하는 닫힌 형태의 식이 나옵니다.
공식
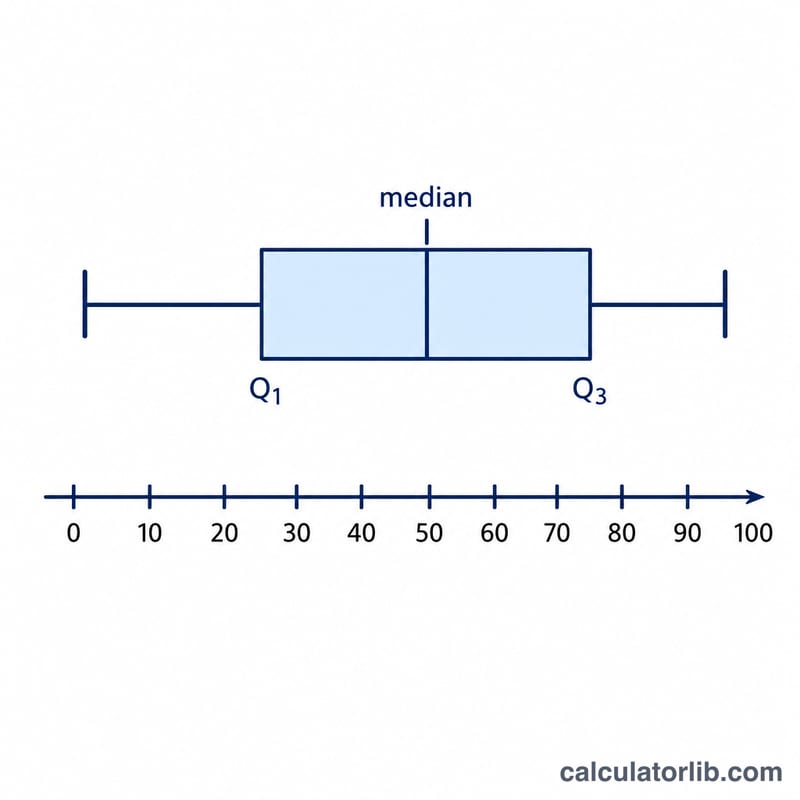
X의 평균, 분산, 표준편차는 다음과 같습니다.
여기서 r은 목표 성공 횟수이고 p는 시행당 성공 확률이며, 0 < p <= 1 입니다. 분산은 항상 평균보다 1/p 배 크므로, 음이항분포는 포아송분포에 비해 과대산포(over-dispersed)한다는 점에 유의하세요.
풀이 예시
r = 5번의 성공이 필요하고 각 시행이 확률 p = 0.5로 성공한다고 합시다. 5번째 성공 전까지의 평균 실패 횟수는 5(1 - 0.5)/0.5 = 5 입니다. 분산은 5(1 - 0.5)/0.5^2 = 2.5/0.25 = 10 이므로, 표준편차는 sqrt(10), 약 3.16 입니다. 평균적으로 약 5번의 실패가 예상되며, 그 평균을 중심으로 대체로 약 3번의 실패만큼 퍼져 있습니다.
자주 묻는 질문
어떤 음이항분포 매개변수화를 사용하나요? 표준적인 "r번째 성공 전 실패 횟수" 관례를 사용하므로 평균은 r(1-p)/p 입니다. 교재가 실패 횟수 대신 전체 시행 횟수를 센다면, 두 관례 사이를 변환하기 위해 평균에 r을 더하세요.
r은 반드시 정수여야 하나요? 고전적인 계수 해석에서는 r이 양의 정수이지만, 평균과 분산 공식은 임의의 실수 r > 0에 대해 유효하며, 이것이 일반화된 (Polya) 음이항분포의 경우입니다.
p가 1에 가까워지면 어떻게 되나요? p가 1에 가까우면 거의 모든 시행이 성공하므로 실패가 거의 없고 평균과 분산 모두 0에 가까워집니다. p가 작아지면 실패가 쌓여 두 적률 모두 빠르게 커집니다.
다양한 r 및 p 값에 따른 음이항분포의 평균과 분산
이 표는 \(X\) = \(r\)번째 성공 이전까지의 실패 횟수라는 매개변수화를 사용하며, 평균은 \(\mu = r(1-p)/p\), 분산은 \(\sigma^2 = r(1-p)/p^2\)입니다. 분산 대 평균 비율은 \(1/p\)로 간단히 정리됩니다.
| r | p | 평균 r(1-p)/p | 분산 r(1-p)/p² | 표준편차 | 분산 대 평균 비율 1/p |
|---|---|---|---|---|---|
| 1 | 0.5 | 1 | 2 | 1.4142 | 2 |
| 5 | 0.5 | 5 | 10 | 3.1623 | 2 |
| 5 | 0.2 | 20 | 100 | 10 | 5 |
| 10 | 0.8 | 2.5 | 3.125 | 1.7678 | 1.25 |
| 3 | 0.1 | 27 | 270 | 16.4317 | 10 |
r = 5, p = 0.2인 경우의 검산: \(\mu = 5(0.8)/0.2 = 4/0.2 = 20\), \(\sigma^2 = 5(0.8)/0.2^2 = 4/0.04 = 100\), \(\sigma = \sqrt{100} = 10\), 그리고 \(1/p = 5 = 100/20\)입니다.
정의 및 용어집
- r: 목표 성공 횟수로, r번째 성공 시 과정이 멈춥니다. 고전적 형태에서는 양의 정수이며(이 분포는 양의 실수 값으로 확장될 수 있습니다).
- p: 각 独立 시행에서 성공할 확률로, 0 < p ≤ 1입니다.
- X: r번째 성공 이전에 관찰된 실패 횟수이며, 0, 1, 2, …의 값을 가집니다.
- 평균: X의 기댓값으로, \(E[X] = r(1-p)/p\)입니다.
- 분산: 평균으로부터의 편차 제곱의 기댓값으로, \(\operatorname{Var}(X) = r(1-p)/p^2\)입니다.
- 표준편차: 분산의 제곱근으로, \(\sqrt{r(1-p)}/p\)입니다.
- 과대산포: 분산이 평균보다 큰 경우를 말합니다. 0 < p < 1이면 음이항분포는 항상 과대산포 상태입니다.
- 기하분포: r = 1인 특수한 경우로, 첫 번째 성공 이전의 실패 횟수를 셉니다. 평균은 \((1-p)/p\), 분산은 \((1-p)/p^2\)입니다.
- 총 시행 횟수 매개변수화: Y = X + r이 r번째 성공까지의 모든 시행 횟수(해당 성공 포함)를 센다면, 평균은 \(r/p\)이고 분산은 \(r(1-p)/p^2\)로 그대로 유지됩니다. 상수 r을 더하면 평균은 이동하지만 퍼짐 정도는 변하지 않기 때문입니다.