Công cụ này làm gì?
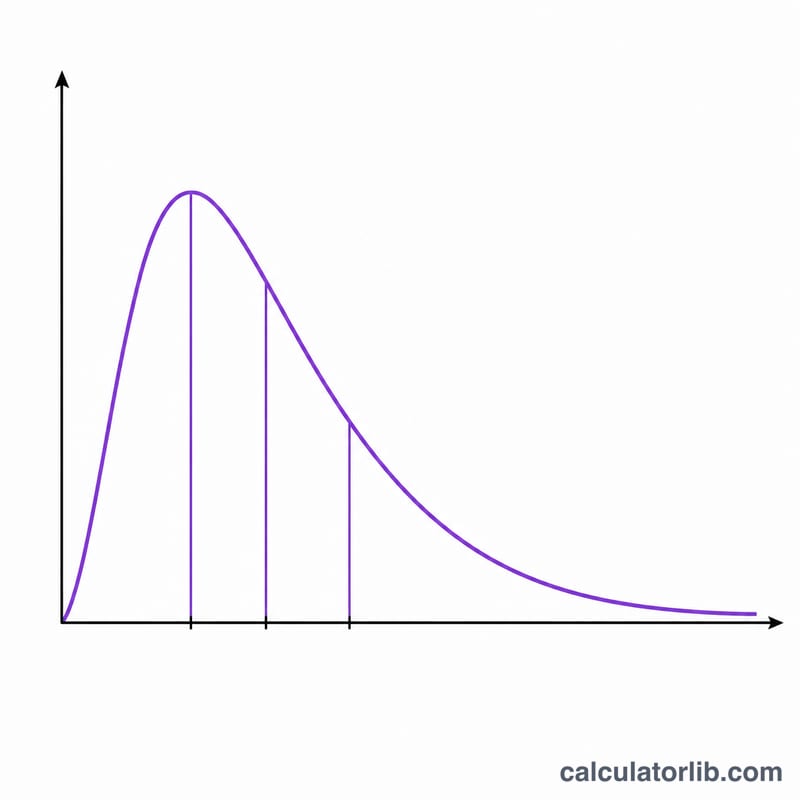
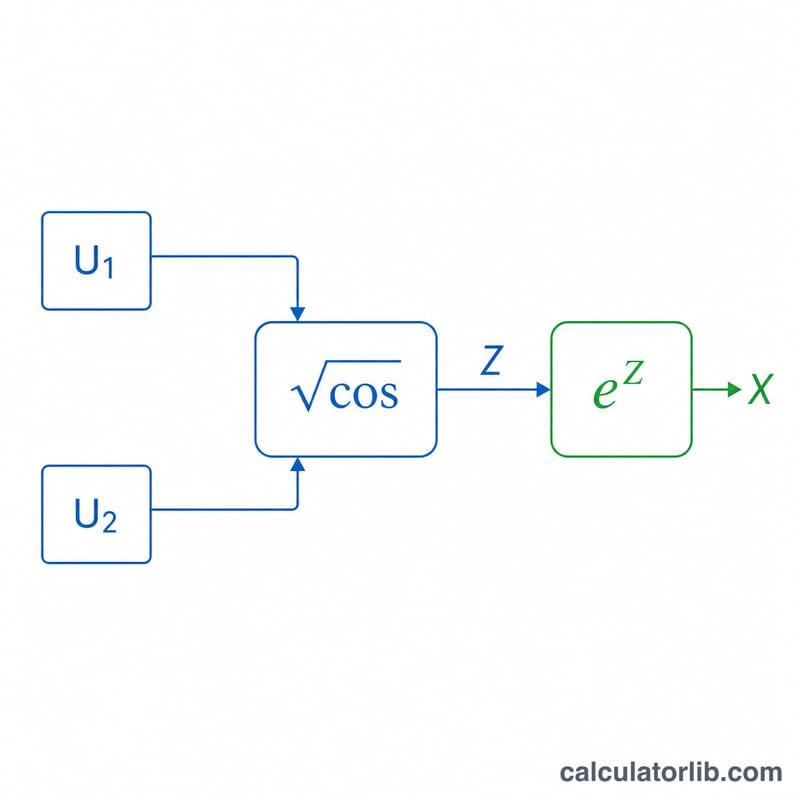
Công cụ tạo ra một danh sách các số giả ngẫu nhiên tuân theo phân phối log-chuẩn. Một biến ngẫu nhiên X được gọi là log-chuẩn khi logarit tự nhiên của nó, \(\ln(X)\), tuân theo phân phối chuẩn. Trước tiên, trình tạo sinh ra các biến chuẩn tắc bằng phép biến đổi Box-Muller kinh điển, sau đó co giãn chúng về phân phối chuẩn mục tiêu \(N(\mu, \sigma^2)\), rồi lấy lũy thừa cơ số e để thu được các giá trị log-chuẩn luôn dương.
Lưu ý quan trọng: mu và sigma có ý nghĩa gì?
Hai tham số \(\mu\) và \(\sigma\) mô tả phân phối chuẩn nền của \(\ln(X)\) — chúng không phải là giá trị trung bình và độ lệch chuẩn của chính X. Trung bình thực sự của X là \(\exp(\mu + \sigma^2/2)\), trung vị là \(\exp(\mu)\), và phương sai là \((\exp(\sigma^2) - 1)\cdot\exp(2\mu + \sigma^2)\). Các giá trị tham chiếu này được hiển thị ngay bên cạnh mẫu kết quả để bạn dễ dàng đối chiếu, kiểm tra tính hợp lý của đầu ra.
Cách sử dụng
Nhập \(\mu\) (số thực bất kỳ), \(\sigma\) (bằng 0 hoặc dương), và số lượng số bạn muốn tạo (từ 1 đến 1000). Chọn số chữ số có nghĩa muốn hiển thị. Mỗi lần chạy, công cụ rút ra các số ngẫu nhiên đều mới, vì vậy kết quả sẽ thay đổi liên tục. Do phương pháp Box-Muller cho ra hai biến chuẩn từ mỗi cặp số đều, nên nếu bạn nhập số lượng lẻ thì một biến dư sẽ đơn giản bị loại bỏ.
Giải thích công thức
Với các số đều \(U_1, U_2\) trong khoảng \((0,1]\):
$$Z = \sqrt{-2\ln U_1}\,\cos(2\pi U_2)$$cho ta \(Z \sim N(0,1)\). Tiếp theo, \(Y = \mu + \sigma\, Z\) tuân theo \(N(\mu, \sigma^2)\), và \(X = \exp(Y)\) chính là số log-chuẩn. Để tránh trường hợp \(\ln(0)\), chúng tôi giới hạn \(U_1\) ở một giá trị epsilon cực nhỏ.
Ví dụ minh họa
Với \(\mu = 1\), \(\sigma = 2\), lấy \(U_1 = 0.5\), \(U_2 = 0.25\). Khi đó \(R = \sqrt{-2\ln 0.5} = 1.17741\). \(Z_1 = R\cdot\cos(\pi/2) = 0\) và \(Z_2 = R\cdot\sin(\pi/2) = 1.17741\). Vậy
$$X_1 = \exp(1) = 2.71828$$và
$$X_2 = \exp(1 + 2\cdot 1.17741) = \exp(3.35482) \approx 28.64$$Trung bình lý thuyết \(\exp(3) = 20.0855\) và trung vị \(\exp(1) = 2.71828\) đều khớp với kết quả này.
Cách μ và σ làm thay đổi phân phối
Các tham số \(\mu\) và \(\sigma\) lần lượt là trung bình và độ lệch chuẩn của \(\ln X\), không phải của chính \(X\). Các giá trị lý thuyết mà máy tính báo cáo tuân theo các công thức sau:
- Trung vị: \(e^{\mu}\)
- Trung bình: \(e^{\mu+\sigma^2/2}\)
- Phương sai: \((e^{\sigma^2}-1)\,e^{2\mu+\sigma^2}\)
| \(\mu\) | \(\sigma\) | Trung vị \(e^{\mu}\) | Trung bình | Phương sai | Trung bình/trung vị \(e^{\sigma^2/2}\) |
|---|---|---|---|---|---|
| 0 | 0.25 | 1.0000 | 1.0317 | 0.0687 | 1.0317 |
| 0 | 0.5 | 1.0000 | 1.1331 | 0.3647 | 1.1331 |
| 0 | 1 | 1.0000 | 1.6487 | 4.6708 | 1.6487 |
| 1 | 0.5 | 2.7183 | 3.0802 | 2.6948 | 1.1331 |
| 1 | 2 | 2.7183 | 20.0855 | 21,623.04 | 7.3891 |
Kiểm tra mẫu với (1, 2): trung bình là \(e^{1+4/2}=e^{3}\approx 20.0855\). Phương sai là \((e^{4}-1)\,e^{2+4}=e^{10}-e^{6}\approx 22026.47-403.43=21623.04\).
Ghi chú về tỷ số: trung bình chia cho trung vị luôn bằng \(e^{\sigma^2/2}\), nên nó chỉ phụ thuộc vào \(\sigma\). Thay đổi \(\mu\) sẽ co giãn toàn bộ phân phối (trung vị được nhân với \(e^{\Delta\mu}\)) mà không làm thay đổi hình dạng của nó. Tăng \(\sigma\) làm đuôi phải dày hơn, và trung bình kéo lên cao hơn nhiều so với trung vị.
Thuật ngữ chính
- Phân phối log-chuẩn
- Phân phối của một biến dương \(X\) mà logarit tự nhiên \(\ln X\) có phân phối chuẩn.
- Mu (\(\mu\))
- Trung bình của \(\ln X\). Nó xác định tỷ lệ: trung vị của \(X\) là \(e^{\mu}\).
- Sigma (\(\sigma\))
- Độ lệch chuẩn của \(\ln X\). Giá trị này phải dương và kiểm soát độ trải rộng và độ lệch.
- Chuẩn tắc Z
- Một biến chuẩn có trung bình 0 và phương sai 1. Ở đây \(X=e^{\mu+\sigma Z}\).
- Biến ngẫu nhiên đều U
- Một số ngẫu nhiên phân bố đều giữa 0 và 1. Phép biến đổi Box-Muller sử dụng hai giá trị \(U_1\) và \(U_2\), và \(U_1\) phải lớn hơn 0.
- Phép biến đổi Box-Muller
- Phương pháp biến đổi hai biến ngẫu nhiên đều độc lập thành các biến chuẩn tắc, ví dụ \(Z=\sqrt{-2\ln U_1}\cos(2\pi U_2)\).
- Số giả ngẫu nhiên
- Một số được tạo ra bởi thuật toán xác định, có hành vi thống kê giống như số ngẫu nhiên, nhưng không thực sự ngẫu nhiên.
- Trung bình, trung vị, yếu vị
- Trung bình cộng, giá trị ở giữa, và giá trị xuất hiện thường xuyên nhất (đỉnh của mật độ). Với phân phối log-chuẩn: trung bình \(e^{\mu+\sigma^2/2}\), trung vị \(e^{\mu}\), yếu vị \(e^{\mu-\sigma^2}\). Yếu vị < trung vị < trung bình.
- Phương sai
- Bình phương trung bình của độ lệch so với trung bình. Với phân phối log-chuẩn, phương sai là \((e^{\sigma^2}-1)e^{2\mu+\sigma^2}\).
- Lệch phải
- Sự bất đối xứng với đuôi dài về phía giá trị lớn, kéo trung bình lên cao hơn trung vị.
Câu hỏi thường gặp
Vì sao mỗi lần chạy lại cho giá trị khác nhau? Đây là trình tạo ngẫu nhiên dựa trên Math.random(); vì không cố định hạt giống (seed) nên mỗi lần chạy đều cho kết quả khác.
Nếu sigma = 0 thì sao? Phân phối trở nên suy biến và mọi giá trị đều bằng \(\exp(\mu)\).
Giá trị có thể âm không? Không — miền giá trị của phân phối log-chuẩn là \((0, \infty)\), nên tất cả kết quả đều dương tuyệt đối.