Tương quan hạng Spearman là gì?
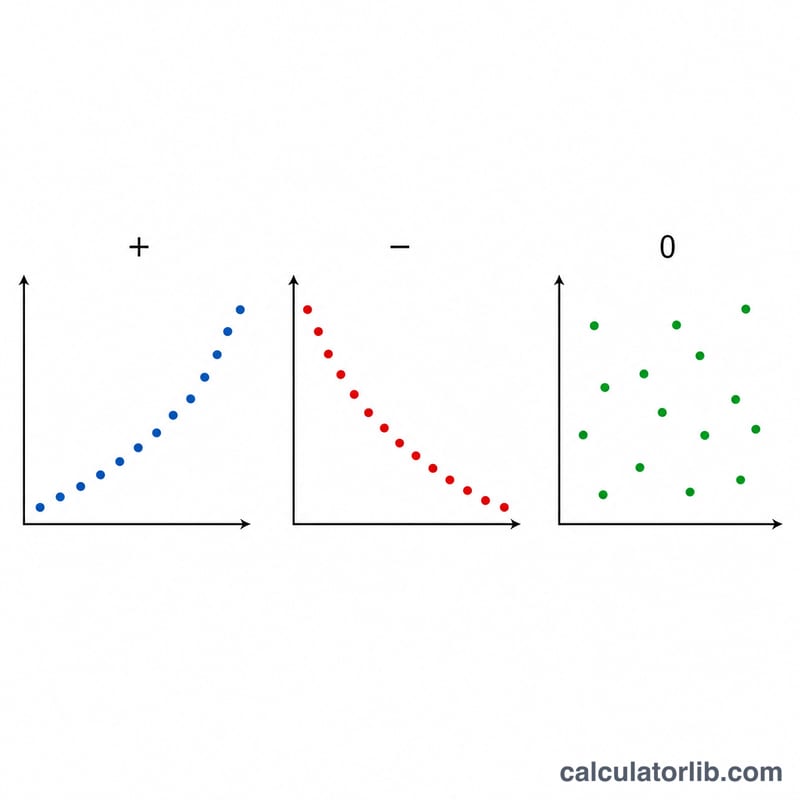
Hệ số tương quan hạng Spearman (ρ, đọc là "rô") đo lường độ mạnh và chiều hướng của mối quan hệ đơn điệu giữa hai biến số. Khác với tương quan Pearson, Spearman làm việc trên hạng của dữ liệu thay vì giá trị gốc, nên không giả định mối quan hệ phải tuyến tính hay dữ liệu phải tuân theo phân phối chuẩn. Giá trị ρ dao động từ −1 (sắp xếp nghịch hoàn hảo), qua 0 (không có liên hệ đơn điệu), đến +1 (đồng thuận hoàn hảo).
Cách sử dụng máy tính
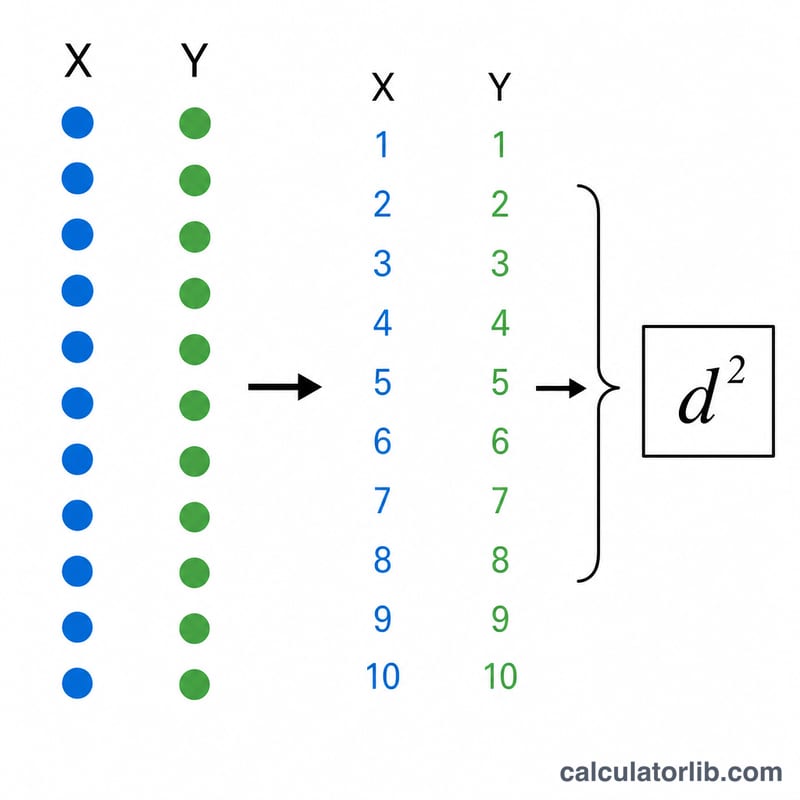
Nhập hai chuỗi dữ liệu của bạn vào ô X và Y, dùng dấu phẩy hoặc khoảng trắng để ngăn cách các giá trị. Hai danh sách phải có cùng số lượng phần tử (những giá trị dư trong danh sách dài hơn sẽ bị bỏ qua). Bấm "Tính toán" để nhận ρ, số cặp (\(n\)) và Σd² — tổng bình phương chênh lệch hạng.
Giải thích công thức
Với dữ liệu không có hạng đồng nhau, ρ được tính như sau:
$$\rho = 1 - \frac{6 \sum d_i^{2}}{n\,(n^{2}-1)} \qquad d_i = R\!\left(\text{X}_i\right) - R\!\left(\text{Y}_i\right)$$
Đầu tiên, mỗi biến được xếp hạng riêng (giá trị nhỏ nhất = hạng 1). Với mỗi cặp, \(d\) là chênh lệch giữa hạng X và hạng Y. Bình phương từng \(d\), cộng tất cả lại, rồi thay vào công thức. Khi có các giá trị đồng hạng, công thức rút gọn này bị lệch, nên máy tính sẽ tự động chuyển sang tính tương quan Pearson tương đương trên các hạng, sử dụng hạng trung bình cho những giá trị bằng nhau.
Ví dụ minh họa
Lấy X = 10, 20, 30, 40, 50 và Y = 12, 24, 33, 44, 55. Cả hai chuỗi cùng tăng, nên mỗi chuỗi đều có hạng 1, 2, 3, 4, 5. Mọi \(d\) đều bằng 0, vậy \(\sum d_i^{2} = 0\) và \(\rho = 1 - \frac{6\times 0}{5\times 24} =\) 1 — một mối quan hệ đơn điệu thuận hoàn hảo.
Diễn giải kết quả ρ của Spearman
ρ của Spearman đo mức độ mối quan hệ giữa hai biến có thể được mô tả bằng một hàm đơn điệu, tức là hàm luôn tăng hoặc luôn giảm. Giá trị của nó nằm trong khoảng từ −1 đến +1.
Dấu so với độ lớn. Dấu cho biết chiều hướng. ρ dương nghĩa là các thứ hạng cao hơn của X có xu hướng đi kèm với các thứ hạng cao hơn của Y. ρ âm nghĩa là các thứ hạng cao hơn của X có xu hướng đi kèm với các thứ hạng thấp hơn của Y. Độ lớn \(|\rho|\) cho biết cường độ của mối liên hệ đơn điệu, bất kể chiều hướng. ρ = −0.80 mạnh như ρ = +0.80.
Các khoảng tham khảo theo kinh nghiệm cho |ρ| (chỉ mang tính quy ước; chúng khác nhau tùy lĩnh vực, và một số ngành dùng ngưỡng nghiêm ngặt hơn hoặc lỏng hơn):
| |ρ| | Nhãn thường gặp |
|---|---|
| 0.00–0.19 | Rất yếu |
| 0.20–0.39 | Yếu |
| 0.40–0.59 | Trung bình |
| 0.60–0.79 | Mạnh |
| 0.80–1.00 | Rất mạnh |
- Tương quan không phải là nhân quả. ρ cao cho thấy hai biến cùng biến đổi theo thứ hạng. Điều đó không chứng minh biến này gây ra biến kia. Một biến thứ ba hoặc sự trùng hợp ngẫu nhiên có thể giải thích mẫu này.
- Cỡ mẫu có ý nghĩa. Với n nhỏ, một ρ trông lớn có thể xuất hiện chỉ do ngẫu nhiên. Với n lớn, ngay cả ρ rất nhỏ cũng có thể có ý nghĩa thống kê. Để đánh giá ý nghĩa cần một kiểm định riêng, ví dụ bảng giá trị tới hạn bên dưới hoặc p-value.
- ρ = 0 không có nghĩa là không có mối quan hệ. Nó chỉ có nghĩa là không có xu hướng đơn điệu. Một mối quan hệ hình chữ U hoặc không đơn điệu khác vẫn có thể tạo ra ρ gần 0, vì vậy hãy vẽ biểu đồ dữ liệu của bạn.
Giá trị tới hạn của ρ Spearman
Bảng này trình bày một số giá trị tới hạn hai phía chuẩn của ρ Spearman lấy từ các bảng thường được công bố, ứng với mức ý nghĩa α = 0.05 và α = 0.01. Dấu gạch ngang nghĩa là không có giá trị nào đạt được mức đó với cỡ mẫu này.
| n (cặp) | α = 0.05 | α = 0.01 |
|---|---|---|
| 5 | 1.000 | — |
| 6 | 0.886 | 1.000 |
| 7 | 0.786 | 0.929 |
| 8 | 0.738 | 0.881 |
| 9 | 0.700 | 0.833 |
| 10 | 0.648 | 0.794 |
| 12 | 0.591 | 0.777 |
| 15 | 0.521 | 0.654 |
| 20 | 0.447 | 0.570 |
| 30 | 0.362 | 0.467 |
Cách sử dụng: tìm n của bạn, rồi so sánh \(|\rho|\) với giá trị tới hạn. Nếu \(|\rho|\) lớn hơn hoặc bằng giá trị đó, hãy bác bỏ giả thuyết không có liên hệ ở mức đó. Nếu nhỏ hơn, bạn không thể bác bỏ giả thuyết không.
Mẫu lớn hơn: với n vượt quá bảng, thường dùng phép xấp xỉ t:
$$t = \rho\,\sqrt{\frac{n-2}{1-\rho^{2}}}$$
So sánh t với phân phối t Student có \(n-2\) bậc tự do. Các bảng chính xác được ưu tiên hơn khi n rất nhỏ, và các thứ hạng bị trùng khiến mọi kiểm định này chỉ mang tính xấp xỉ.
Từng bước: Xếp hạng dữ liệu có giá trị trùng bằng tay
- Sắp xếp riêng từng biến từ nhỏ nhất đến lớn nhất. Làm với X và Y một cách độc lập.
- Gán vị trí từ 1 đến n theo thứ tự đã sắp xếp. Giá trị nhỏ nhất nhận vị trí 1.
- Lấy trung bình vị trí cho các giá trị trùng. Mỗi giá trị trùng nhận trung bình của các vị trí mà chúng chiếm. Ví dụ, hai giá trị trùng nhau ở vị trí thứ 2 và thứ 3 đều nhận \((2+3)/2 = 2.5\). Giá trị kế tiếp khi đó nhận thứ hạng 4.
- Ghép các thứ hạng để mỗi quan sát có thứ hạng X và thứ hạng Y của nó.
- Tính ρ. Khi không có giá trị trùng, tìm \(d_i = R(X_i) - R(Y_i)\), bình phương và cộng lại để có \(\sum d_i^2\), rồi dùng \(\rho = 1 - \dfrac{6\sum d_i^{2}}{n(n^{2}-1)}\). Khi có giá trị trùng, công thức rút gọn chỉ mang tính xấp xỉ, nên hãy tính hệ số r Pearson trên các cặp thứ hạng.
Ví dụ ngắn có giá trị trùng. Lấy X = 5, 8, 8, 12 và Y = 2, 4, 3, 9.
- Thứ hạng X: 5 → 1; hai số 8 chia nhau vị trí 2 và 3, nên mỗi số nhận 2.5; 12 → 4. Thứ hạng: 1, 2.5, 2.5, 4.
- Thứ hạng Y (không trùng): 2 → 1, 4 → 3, 3 → 2, 9 → 4. Thứ hạng: 1, 3, 2, 4.
- Trung bình thứ hạng của cả hai đều là 2.5. Độ lệch của X: −1.5, 0, 0, 1.5. Độ lệch của Y: −1.5, 0.5, −0.5, 1.5.
- \(\sum xy = 2.25 + 0 + 0 + 2.25 = 4.5\), \(S_{xx} = 2.25+0+0+2.25 = 4.5\), \(S_{yy} = 2.25+0.25+0.25+2.25 = 5\).
- $$\rho = \frac{4.5}{\sqrt{4.5 \times 5}} = \frac{4.5}{\sqrt{22.5}} \approx$$ 0.9487
Điều này cho thấy một mối liên hệ đơn điệu thuận rất mạnh. Tuy nhiên, với n = 4, mẫu quá nhỏ để đạt ý nghĩa thống kê ở các mức thông thường.
Câu hỏi thường gặp
ρ = 0 nghĩa là gì? Không có xu hướng đơn điệu nào; khi X tăng, Y không tăng hay giảm một cách nhất quán.
Spearman khác Pearson r ở điểm nào? Pearson đo liên hệ tuyến tính trên giá trị gốc; Spearman đo liên hệ đơn điệu trên hạng, nhờ vậy ít bị ảnh hưởng bởi giá trị ngoại lai và phù hợp với các mối quan hệ phi tuyến (nhưng có thứ tự).
Tôi cần bao nhiêu điểm dữ liệu? Cần tối thiểu 2 cặp để tính được ρ, nhưng càng nhiều cặp thì ước lượng mức độ liên hệ càng đáng tin cậy.