Studentized range dağılımı nedir?
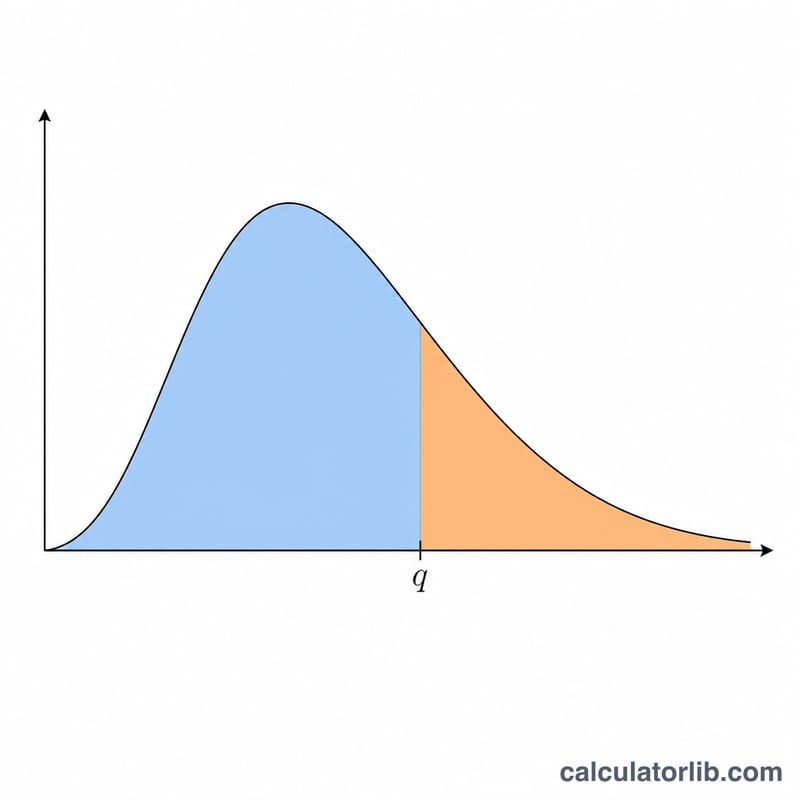
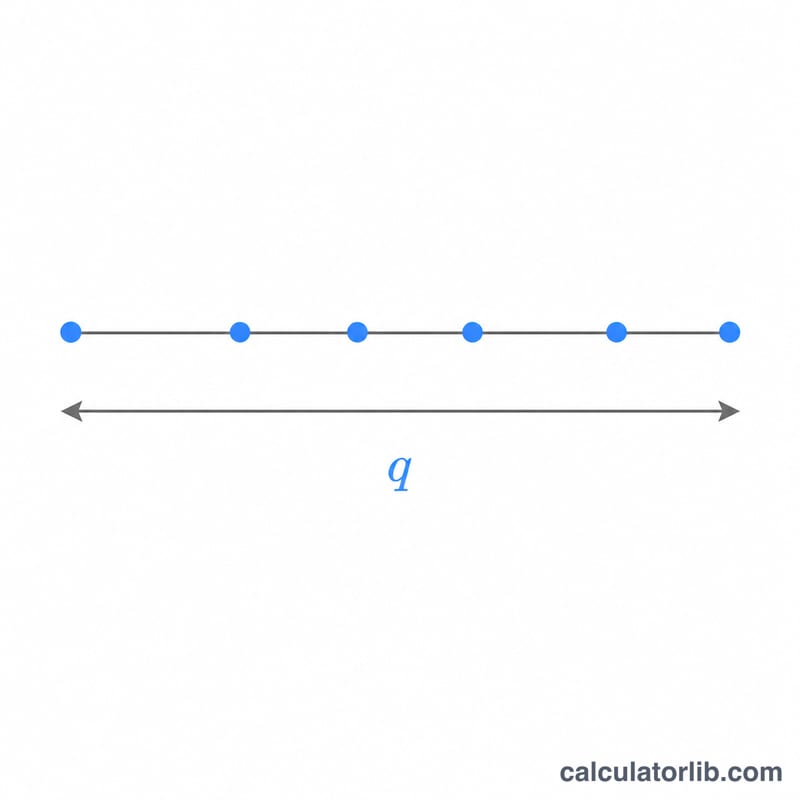
Studentized range istatistiği q, r adet örneklem ortalamasının en büyüğü ile en küçüğü arasındaki açıklığı ölçer ve bu açıklık nu serbestlik derecesiyle bağımsız olarak tahmin edilmiş bir standart hataya bölünür. Bu dağılım, Tukey'nin Dürüst Anlamlı Fark (HSD) testinin ve diğer çoklu karşılaştırma (post-hoc) yöntemlerinin temelini oluşturur. Bu hesaplayıcı, alt kümülatif olasılık \(P(Q \le q) = F(q, r, \nu)\) ile üst kuyruk \(P(Q > q) = 1 - F\) değerini verir. Bu, tamamen istatistiksel bir fonksiyondur ve herhangi bir ülkeye özgü kural içermez; her yerde aynı şekilde geçerlidir.
Nasıl kullanılır?
Dört sayı girin: CDF'nin hesaplanacağı \(q\) kantili, açıklığa giren işlem (treatment) ortalamalarının sayısı olan \(r\) örneklem büyüklüğü (en az 2), hata serbestlik derecesi \(\nu\) ve maksimum açıklığı alınan bağımsız grup sayısı \(c\) (\(c = 1\) sıradan studentized range'tir; \(c > 1\) ise tek bir kritik değeri paylaşan c bağımsız deneyin maksimumunu modeller). Araç, her iki kuyruk olasılığını da raporlar.
Formülün açıklaması
Sabit bir x açıklığı için \(H(x, r)\), r adet bağımsız standart normal değerin açıklığının x'in altında kalma olasılığıdır; bu değer, standart normal yoğunluğun \([\Phi(y) - \Phi(y - x)]\) ifadesinin r-1'inci kuvvetiyle çarpımının integraliyle hesaplanır. Tahmin edilen varyansı hesaba katmak için \(H(q\sqrt{u}, r)\), u'nun ki-kare/nu ölçekleme yoğunluğuna göre (nu serbestlik derecesiyle) ortalaması alınır ve c'inci kuvvete yükseltilir. nu son derece büyük olduğunda varyans bilinir kabul edilir, ölçekleme \(u = 1\)'e indirgenir ve $$F = [H(q, r)]^{c}$$ olur.
Çözümlü örnek
\(q = 5.673\), \(r = 5\), \(\nu = 5\), \(c = 1\) değerleriyle hesaplayıcı yaklaşık 0,95 alt kümülatif olasılık verir; dolayısıyla üst kuyruk yaklaşık 0,05 olur. Bu sonuç, beş grup ve beş hata serbestlik derecesi için \(\alpha = 0{,}05\)'te klasik Tukey q-tablosundaki yaklaşık 5,67 kritik değeriyle örtüşür.
Sıkça Sorulan Sorular
Sonucum basılı tablodan neden biraz farklı çıkıyor? Olasılık sayısal integrasyonla bulunur; kaynak yöntemde de belirtildiği gibi r büyük ve nu küçük olduğunda doğruluk azalır.
c ne işe yarar? \(c > 1\), c bağımsız studentized range değerinin maksimumunun dağılımını verir; bu, aynı kritik değerin c bağımsız deneyde yeniden kullanıldığı durumlarda işe yarar.
q sıfır veya negatifse ne olur? Bir açıklık negatif olamayacağından \(F = 0\) olur ve üst olasılık 1'dir.