這款樣本數計算器能幫你做什麼
這個計算器會告訴你,針對某個母體進行調查時,需要訪問多少人(或多少項目)才能得到具統計可靠度的結果。它採用標準的「有限母體校正」公式,因此算出的數字會依據你的目標族群規模量身調整,而不是假設母體無限大。無論是問卷調查、民意調查、市場研究或學術研究,全球都通用——統計原理放諸四海皆準,並不限於特定國家。
三項輸入欄位說明
- 母體大小(N):你想做出推論的整個族群總人數,例如 50,000 名註冊客戶。預設值為 1,000,000。
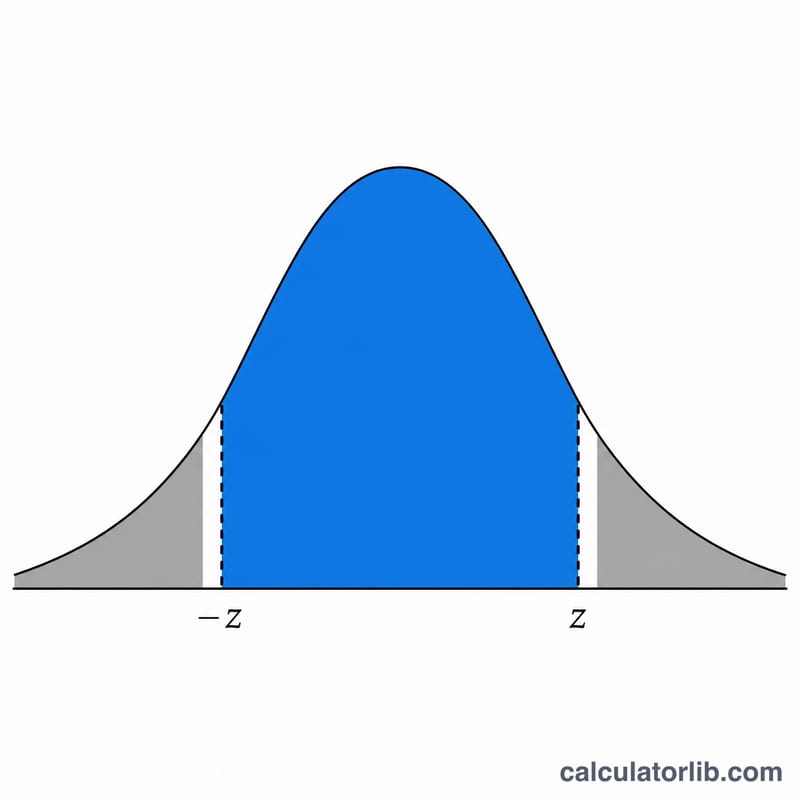
- 信心水準(%):你希望有多大把握確定真實數值落在你的誤差範圍內。常見選項為 90%、95% 與 99%。計算器會依常態分布把它轉換為 z 值(95% → \(z \approx 1.96\))。
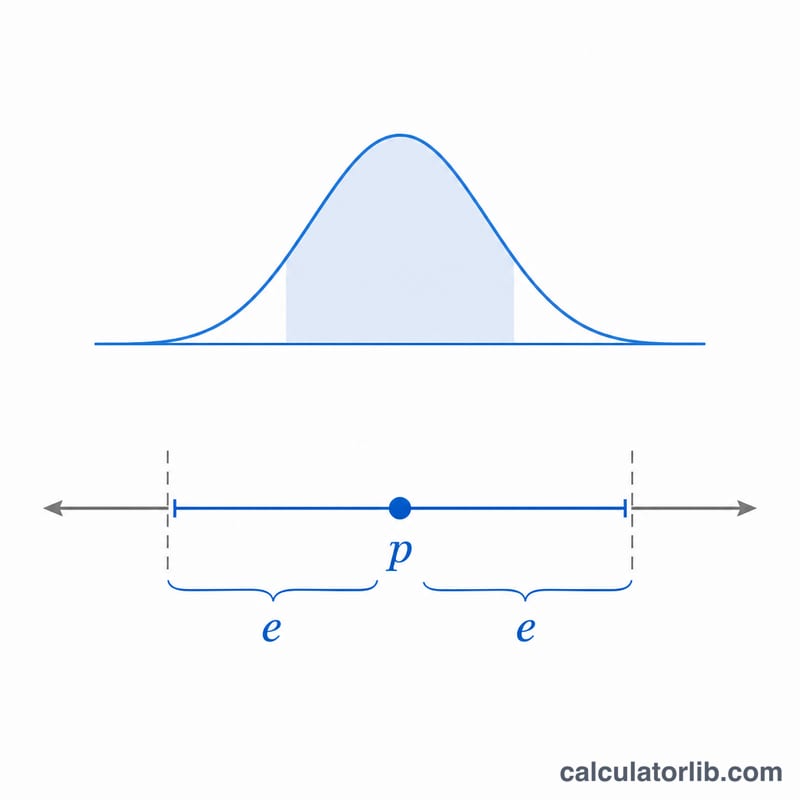
- 誤差範圍(%):結果可接受的誤差幅度,例如 ±5%。誤差範圍越小,所需樣本數就越大。
計算公式
本計算器套用「有限母體校正」後的樣本數公式:
$$n = \dfrac{\dfrac{z^{2}\,p\,(1-p)}{e^{2}}}{1 + \dfrac{z^{2}\,p\,(1-p)}{e^{2}\,N}}$$
其中 \(z\) 是由信心水準換算而來的 z 值,\(p\) 是假設的回應比例(固定為 0.5,因為這會讓所需樣本數達到最大,也是最保守、最安全的估計),\(e\) 是以小數表示的誤差範圍,\(N\) 則是母體大小。最終結果會無條件進位,確保你絕不會抽樣不足。
實際範例
假設你的母體有 50,000 人,希望達到 95% 信心水準與 5% 誤差範圍。
- \(z = 1.96\)、\(p = 0.5\)、\(e = 0.05\)、\(N = 50{,}000\)
- 分子:$$\frac{1.96^{2} \times 0.5 \times 0.5}{0.05^{2}} = \frac{0.9604}{0.0025} = 384.16$$
- 分母:$$1 + \frac{384.16}{50{,}000} = 1.00768$$
- $$n = \frac{384.16}{1.00768} \approx 381.2 \rightarrow \text{無條件進位為 } \mathbf{382}$$
因此,你需要訪問 382 人。
常見信賴水準的 Z 分數
計算機會將你的信賴水準轉換為雙尾 z 分數 \(z = \Phi^{-1}\left(1 - \alpha/2\right)\),其中 \(\alpha = 1 - \text{信賴水準}\)。信賴水準越高,z 分數越大,因此所需的樣本數也越大。
| 信賴水準 | 顯著水準 α(1 − 信賴水準) | 雙尾 z 分數 |
|---|---|---|
| 80% | 0.20 | 1.282 |
| 85% | 0.15 | 1.440 |
| 90% | 0.10 | 1.645 |
| 95% | 0.05 | 1.960 |
| 98% | 0.02 | 2.326 |
| 99% | 0.01 | 2.576 |
| 99.9% | 0.001 | 3.291 |
如何解讀你的樣本數
- 計算的是完成的有效回覆,而非邀請數。結果是你所需的完成且有效回覆數。若你預期回覆率為 20%,則必須聯絡約五倍的人數。
- 假設採用隨機抽樣。只有在受訪者是從母體中隨機選出時,樣本數才能支持所述的誤差範圍與信賴水準。便利抽樣或大量未回覆的情況,無論 n 多大,都可能使結果產生偏差。
- 次群體的誤差範圍較大。誤差範圍適用於整體樣本。若你分析某個次群體,其誤差範圍是根據該次群體自身的樣本數計算。例如,在 p = 0.5 且 95% 信賴水準下,一個包含 100 人的次群體,其誤差範圍約為 \(1.96\sqrt{0.25/100} \approx 0.098\),即 ±9.8%。
- 收益遞減。由於 \(n \propto 1/e^{2}\),將誤差範圍減半,所需樣本數大約會增加為四倍。在 95% 信賴水準且母體很大的情況下,±5% 約需 385 份回覆,而 ±2.5% 則約需 1,537 份。
- 有限母體校正。公式中的校正因子 \(1 + \dfrac{n_0}{N}\) 主要在樣本數超過母體約 5% 時才有影響。若母體非常大,結果幾乎不會隨 N 改變。
範例:當 N = 10,000、95% 信賴水準且誤差範圍為 5% 時,首先計算 \(n_0 = \dfrac{1.96^{2}\cdot 0.5\cdot 0.5}{0.05^{2}} = 384.16\)。接著 \(n = \dfrac{384.16}{1 + 384.16/10000} = \dfrac{384.16}{1.038416} \approx 369.97\),無條件進位後為 370 份完成的有效回覆。
計算機假設 p = 0.5,這是最保守的比例,會得出最大的樣本數。若你對該比例有可靠的事前估計,所需樣本數可能較少,但 0.5 是一個安全的預設值。本內容僅為一般統計資訊,不構成財務或醫療建議。
相關工具
正在規劃 A/B 測試?A/B 測試樣本數與檢定力計算器可以算出每個版本需要多少訪客,並提供 B 勝過 A 的精確貝氏機率。
測試已經結束?A/B 測試顯著性計算機會以 Z 值和 p 值檢定兩個轉換率的差異是否具有統計顯著性。
常見問題
為什麼 p 要設為 0.5?當真實比例未知時,0.5 會算出最大的樣本數,確保不論實際結果如何,你的調查都能維持足夠的精準度。
如果我的母體非常龐大怎麼辦?對於超大母體而言,校正項會變得微乎其微,因此樣本數會趨近於較簡單的公式 \(n = z^{2}p(1-p)/e^{2}\)(在 95%/5% 條件下約為 385)。
該怎麼減少所需的樣本數?接受較大的誤差範圍或較低的信心水準即可。反之,只要把任一條件收得更緊,所需樣本數都會大幅增加。