सैंपल माध्य की सैंपलिंग वितरण क्या है?
जब आप किसी जनसंख्या (population) से बार-बार n आकार के यादृच्छिक सैंपल निकालते हैं और हर सैंपल का माध्य (mean) निकालते हैं, तो ये सभी माध्य मिलकर अपनी एक अलग वितरण बनाते हैं — इसी को सैंपल माध्य की सैंपलिंग वितरण कहते हैं। यह कैलकुलेटर तीन इनपुट से इस वितरण का केंद्र (माध्य) और फैलाव (मानक त्रुटि) निकालता है: जनसंख्या माध्य μ, जनसंख्या मानक विचलन σ, और सैंपल साइज़ n।
इस कैलकुलेटर का उपयोग कैसे करें
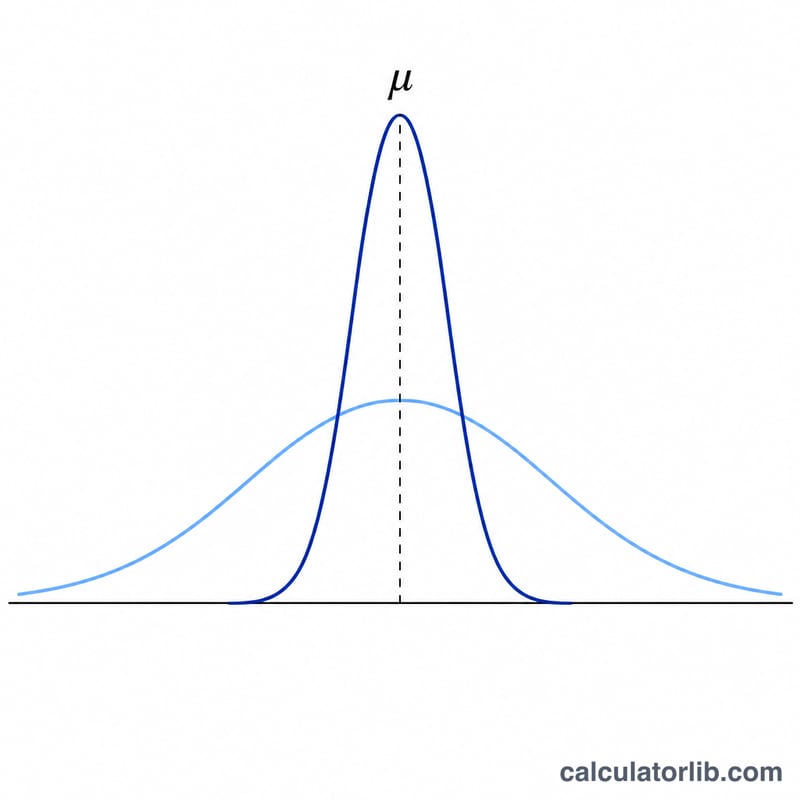
जनसंख्या माध्य (μ), जनसंख्या मानक विचलन (σ) और अपना सैंपल साइज़ (n) दर्ज करें। यह टूल सैंपलिंग वितरण का माध्य (μx̄), मानक त्रुटि (σx̄) और सैंपल माध्य का प्रसरण (σx̄²) बता देता है। मानक त्रुटि यह दर्शाती है कि सैंपल के माध्य आमतौर पर असली जनसंख्या माध्य से कितना अलग होते हैं।
फ़ॉर्मूला को समझें
सैंपलिंग वितरण का माध्य हमेशा जनसंख्या माध्य के बराबर होता है: \(\mu_{\bar{x}} = \mu\)। सैंपल जितने बड़े होते हैं, फैलाव उतना ही कम होता जाता है:
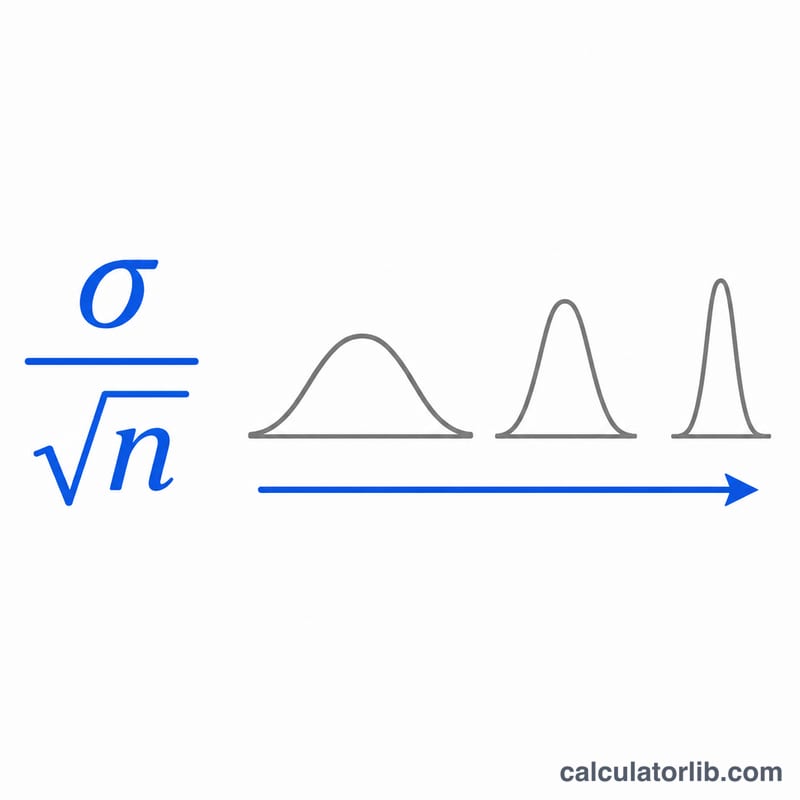
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$चूँकि हम \(n\) के वर्गमूल से भाग देते हैं, इसलिए सैंपल साइज़ दोगुना करने से मानक त्रुटि आधी नहीं होती — मानक त्रुटि को आधा करने के लिए आपको \(n\) को चार गुना करना पड़ेगा। केंद्रीय सीमा प्रमेय (Central Limit Theorem) के अनुसार, बड़े \(n\) के लिए यह वितरण लगभग सामान्य (normal) होती है, चाहे जनसंख्या का आकार कैसा भी हो।
हल किया गया उदाहरण
मान लीजिए \(\mu = 100\), \(\sigma = 15\), और \(n = 25\)। तब \(\mu_{\bar{x}} = 100\), और
$$\sigma_{\bar{x}} = \frac{15}{\sqrt{25}} = \frac{15}{5} = 3$$प्रसरण होगा \(\sigma_{\bar{x}}^{2} = 3^{2} = 9\)। यानी 25 अवलोकनों वाले सैंपल के माध्य 100 के आसपास इकट्ठे रहते हैं, जिनकी मानक त्रुटि 3 है।
नमूना आकार मानक त्रुटि को कैसे बदलता है
तालिका जनसंख्या माध्य को \(\mu = 100\) और जनसंख्या मानक विचलन को \(\sigma = 15\) पर स्थिर रखती है, फिर नमूना आकार \(n\) को बदलती है। नमूनाकरण बंटन का माध्य हर पंक्ति में 100 पर बना रहता है। केवल प्रसार बदलता है।
| नमूना आकार n | मानक त्रुटि \(\sigma/\sqrt{n}\) | प्रसरण \(\sigma^2/n\) | σ के अनुपात के रूप में SE |
|---|---|---|---|
| 1 | 15 | 225 | 1 |
| 4 | 7.5 | 56.25 | 0.5 |
| 9 | 5 | 25 | 0.3333 |
| 25 | 3 | 9 | 0.2 |
| 100 | 1.5 | 2.25 | 0.1 |
| 400 | 0.75 | 0.5625 | 0.05 |
मानक त्रुटि और σ का अनुपात \(1/\sqrt{n}\) के बराबर होता है। वर्गमूल के कारण, नमूना आकार को चार गुना करने से मानक त्रुटि आधी हो जाती है: n = 1 से 4, 4 से 16 (या 25 से 100, 100 से 400) तक जाने पर हर बार मानक त्रुटि आधी हो जाती है। इसे दसवें हिस्से तक लाने के लिए 100 गुना अधिक प्रेक्षणों की आवश्यकता होती है, इसलिए अधिक डेटा एकत्र करने से लाभ घटता जाता है।
मानक त्रुटि की व्याख्या
मानक त्रुटि \(\sigma_{\bar{x}} = \sigma/\sqrt{n}\) मापती है कि नमूना माध्य एक नमूने से दूसरे नमूने में कितना बदलते हैं। यदि \(\bar{x}\) का नमूनाकरण बंटन लगभग सामान्य है (केंद्रीय सीमा प्रमेय के कारण, या इसलिए कि जनसंख्या स्वयं सामान्य है), तो लगभग:
- 68% नमूना माध्य μ के 1 मानक त्रुटि के भीतर आते हैं,
- 95% 2 मानक त्रुटियों के भीतर आते हैं (अधिक सटीक रूप से, 1.96),
- 99.7% 3 मानक त्रुटियों के भीतर आते हैं।
उदाहरण: \(\mu = 100\) और \(\sigma_{\bar{x}} = 3\) के साथ (उदाहरण के लिए σ = 15 और n = 25):
| कवरेज | अंतराल | नमूना माध्यों की सीमा |
|---|---|---|
| ≈ 68% | \(100 \pm 1(3)\) | 97 से 103 |
| ≈ 95% | \(100 \pm 2(3)\) | 94 से 106 |
| ≈ 99.7% | \(100 \pm 3(3)\) | 91 से 109 |
मानक त्रुटि बनाम मानक विचलन। जनसंख्या मानक विचलन σ बताता है कि व्यक्तिगत मान μ के चारों ओर कितने बदलते हैं। मानक त्रुटि बताती है कि नमूना माध्य μ के चारों ओर कितने बदलते हैं। जब n > 1 हो, तो यह सदैव σ से छोटी होती है, और n बढ़ने पर घटती जाती है।
सामान्यता और नमूना आकार। एक सामान्य नियम कहता है कि n ≥ 30 पर्याप्त है ताकि माध्य का नमूनाकरण बंटन लगभग सामान्य हो। यह केवल एक मार्गदर्शक है: लगभग सममित जनसंख्या के लिए छोटा n पर्याप्त हो सकता है, जबकि अत्यधिक तिरछी या भारी-पूंछ वाली जनसंख्या के लिए काफ़ी अधिक की आवश्यकता पड़ सकती है।
परिमित जनसंख्या। सूत्र σ/√n प्रतिस्थापन सहित नमूनाकरण या बहुत बड़ी जनसंख्या मानता है। जब बिना प्रतिस्थापन नमूनाकरण हो और नमूना आकार N की जनसंख्या के लगभग 5% से अधिक हो, तो मानक त्रुटि को परिमित जनसंख्या सुधार \(\sqrt{\frac{N-n}{N-1}}\) से गुणा किया जाता है, जो इसे छोटा कर देता है। यह कैलकुलेटर यह सुधार लागू नहीं करता।
प्रमुख शब्द और प्रतीक
- जनसंख्या माध्य (μ): जनसंख्या के सभी मानों का औसत।
- जनसंख्या मानक विचलन (σ): जनसंख्या में व्यक्तिगत मानों की μ से विशिष्ट दूरी।
- नमूना आकार (n): प्रत्येक नमूने में प्रेक्षणों की संख्या।
- नमूना माध्य (x̄): एक नमूने के n प्रेक्षणों का औसत; यह नमूने-दर-नमूने बदलता रहता है।
- नमूनाकरण बंटन: जनसंख्या से आकार n के सभी संभावित नमूनों पर एक सांख्यिकी (यहाँ x̄) का प्रायिकता बंटन।
- नमूनाकरण बंटन का माध्य (\(\mu_{\bar{x}}\)): x̄ का अपेक्षित मान, जो μ के बराबर है, इसलिए नमूना माध्य μ का एक अनभिनत आकलनकर्ता है।
- मानक त्रुटि (\(\sigma_{\bar{x}}\)): x̄ के नमूनाकरण बंटन का मानक विचलन, जो \(\sigma/\sqrt{n}\) के बराबर है।
- नमूना माध्य का प्रसरण (\(\sigma_{\bar{x}}^2\)): मानक त्रुटि का वर्ग, \(\sigma^2/n\)।
- केंद्रीय सीमा प्रमेय: परिमित प्रसरण वाली जनसंख्या के स्वतंत्र प्रेक्षणों के लिए, n बढ़ने पर x̄ का नमूनाकरण बंटन सामान्य बंटन की ओर अग्रसर होता है, चाहे जनसंख्या का आकार कुछ भी हो।
अक्सर पूछे जाने वाले सवाल
सैंपल बड़े होने पर मानक त्रुटि कम क्यों हो जाती है? बड़े सैंपल में यादृच्छिक उतार-चढ़ाव आपस में संतुलित हो जाते हैं, इसलिए उनके माध्य असली माध्य के और भी करीब, सघन रूप से जमा रहते हैं।
क्या जनसंख्या का सामान्य (normal) होना ज़रूरी है? यहाँ दिए गए फ़ॉर्मूलों के लिए नहीं। माध्य और मानक त्रुटि किसी भी जनसंख्या के लिए सटीक रहते हैं। सैंपलिंग वितरण का सामान्य होना केंद्रीय सीमा प्रमेय के ज़रिए बड़े \(n\) पर लगभग लागू होता है।
अगर मेरे पास सिर्फ़ सैंपल मानक विचलन हो तो? अगर \(\sigma\) पता न हो, तो उसके अनुमान के रूप में सैंपल मानक विचलन \(s\) का उपयोग करें; तब मानक त्रुटि \(s/\sqrt{n}\) हो जाती है, जिसे अक्सर t-वितरण के साथ इस्तेमाल किया जाता है।