표본평균의 표집분포란?
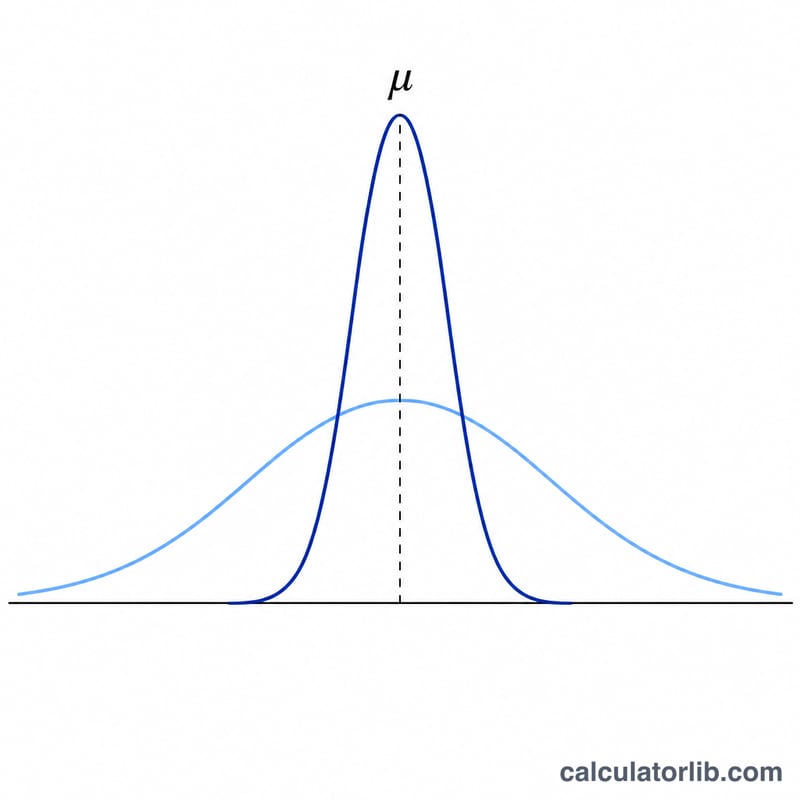
크기가 n인 무작위 표본을 모집단에서 반복해서 뽑고 각 표본의 평균을 계산하면, 이 평균값들이 모여 또 하나의 분포를 이룹니다. 이것이 바로 표본평균의 표집분포입니다. 이 계산기는 세 가지 값, 즉 모집단 평균 \(\mu\), 모집단 표준편차 \(\sigma\), 표본 크기 \(n\)만 입력하면 표집분포의 중심(평균)과 퍼짐(표준오차)을 구해 줍니다.
계산기 사용 방법
모집단 평균(\(\mu\)), 모집단 표준편차(\(\sigma\)), 표본 크기(\(n\))를 입력하세요. 그러면 표집분포의 평균(\(\mu_{\bar{x}}\)), 표준오차(\(\sigma_{\bar{x}}\)), 표본평균의 분산(\(\sigma_{\bar{x}}^{2}\))이 함께 나옵니다. 표준오차는 표본평균들이 실제 모집단 평균에서 보통 얼마나 떨어져 흩어지는지를 알려 주는 값입니다.
공식 풀이
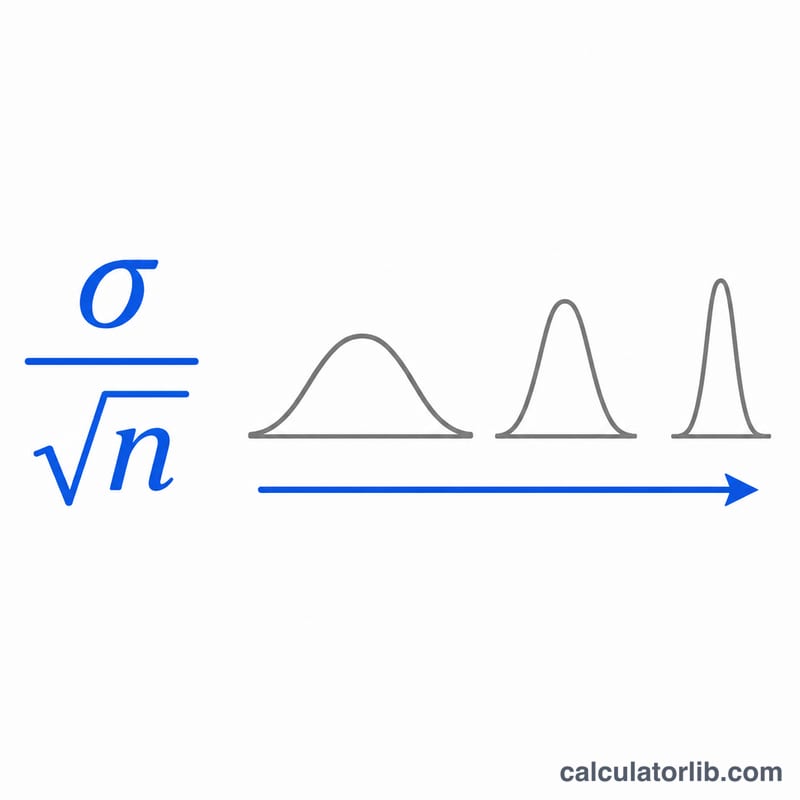
표집분포의 평균은 언제나 모집단 평균과 같습니다. 즉 \(\mu_{\bar{x}} = \mu\)입니다. 반면 퍼짐은 표본이 커질수록 줄어듭니다:
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$\(n\)의 제곱근으로 나누기 때문에, 표본 크기를 두 배로 늘려도 표준오차는 절반이 되지 않습니다. 표준오차를 절반으로 줄이려면 \(n\)을 4배로 늘려야 합니다. 또한 중심극한정리에 따르면, \(n\)이 충분히 크면 모집단의 모양과 상관없이 이 분포는 근사적으로 정규분포를 따릅니다.
예제로 풀어 보기
\(\mu = 100\), \(\sigma = 15\), \(n = 25\)라고 해 봅시다. 그러면 \(\mu_{\bar{x}} = 100\)이고,
$$\sigma_{\bar{x}} = \frac{15}{\sqrt{25}} = \frac{15}{5} = 3$$입니다. 분산은 \(\sigma_{\bar{x}}^{2} = 3^{2} = 9\)이 됩니다. 즉 관측값 25개로 이루어진 표본평균들은 표준오차 3을 갖고 100 주변에 몰려 분포하게 됩니다.
표본 크기가 표준오차에 미치는 영향
이 표는 모평균을 \(\mu = 100\), 모표준편차를 \(\sigma = 15\)로 고정하고 표본 크기 \(n\)을 변화시킵니다. 표본분포의 평균은 모든 행에서 100으로 유지됩니다. 변하는 것은 퍼짐 정도뿐입니다.
| 표본 크기 n | 표준오차 \(\sigma/\sqrt{n}\) | 분산 \(\sigma^2/n\) | σ에 대한 SE 비율 |
|---|---|---|---|
| 1 | 15 | 225 | 1 |
| 4 | 7.5 | 56.25 | 0.5 |
| 9 | 5 | 25 | 0.3333 |
| 25 | 3 | 9 | 0.2 |
| 100 | 1.5 | 2.25 | 0.1 |
| 400 | 0.75 | 0.5625 | 0.05 |
표준오차와 σ의 비율은 \(1/\sqrt{n}\)과 같습니다. 제곱근 때문에 표본 크기를 4배로 늘리면 표준오차는 절반이 됩니다. 즉 n = 1에서 4, 4에서 16(또는 25에서 100, 100에서 400)으로 늘릴 때마다 표준오차는 매번 절반으로 줄어듭니다. 표준오차를 10분의 1로 줄이려면 관측값이 100배 필요하므로, 데이터를 더 모을수록 효과는 점점 줄어듭니다.
표준오차 해석하기
표준오차 \(\sigma_{\bar{x}} = \sigma/\sqrt{n}\)은 표본평균이 표본마다 얼마나 변하는지를 나타냅니다. \(\bar{x}\)의 표본분포가 대략 정규분포를 따른다면(중심극한정리에 의해, 또는 모집단 자체가 정규분포이기 때문에) 대략 다음과 같습니다:
- 표본평균의 약 68%가 μ로부터 표준오차 1배 이내에 있습니다,
- 95%가 표준오차 2배 이내에 있습니다(정확히는 1.96배),
- 99.7%가 표준오차 3배 이내에 있습니다.
예시: \(\mu = 100\)이고 \(\sigma_{\bar{x}} = 3\)인 경우(예를 들어 σ = 15, n = 25):
| 포함 비율 | 구간 | 표본평균의 범위 |
|---|---|---|
| ≈ 68% | \(100 \pm 1(3)\) | 97 ~ 103 |
| ≈ 95% | \(100 \pm 2(3)\) | 94 ~ 106 |
| ≈ 99.7% | \(100 \pm 3(3)\) | 91 ~ 109 |
표준오차와 표준편차의 차이. 모표준편차 σ는 개별 값들이 μ 주변에서 얼마나 흩어져 있는지를 나타냅니다. 표준오차는 표본평균들이 μ 주변에서 얼마나 흩어져 있는지를 나타냅니다. n > 1일 때 표준오차는 항상 σ보다 작으며, n이 커질수록 줄어듭니다.
정규성과 표본 크기. 흔히 쓰이는 경험 법칙에 따르면, 평균의 표본분포가 대략 정규분포를 따르려면 n ≥ 30이면 충분하다고 합니다. 이는 어디까지나 지침일 뿐입니다. 대칭에 가까운 모집단에서는 더 작은 n으로도 충분할 수 있지만, 심하게 치우쳐 있거나 꼬리가 두꺼운 모집단에서는 훨씬 더 많은 표본이 필요할 수 있습니다.
유한 모집단. σ/√n 공식은 복원추출을 하거나 모집단이 매우 큰 경우를 가정합니다. 비복원추출을 하면서 표본이 크기 N인 모집단의 약 5%를 넘는 경우, 표준오차에 유한모집단 수정계수 \(\sqrt{\frac{N-n}{N-1}}\)를 곱하게 되며, 이로 인해 표준오차는 더 작아집니다. 이 계산기는 이 수정을 적용하지 않습니다.
주요 용어와 기호
- 모평균 (μ): 모집단에 있는 모든 값의 평균입니다.
- 모표준편차 (σ): 모집단에서 개별 값들이 μ로부터 떨어진 전형적인 거리입니다.
- 표본 크기 (n): 각 표본에 포함된 관측값의 개수입니다.
- 표본평균 (x̄): 한 표본에 있는 n개 관측값의 평균이며, 표본마다 값이 달라집니다.
- 표본분포: 크기 n인 모든 가능한 표본에 대해 통계량(여기서는 x̄)이 가지는 확률분포입니다.
- 표본분포의 평균 (\(\mu_{\bar{x}}\)): x̄의 기댓값으로, μ와 같습니다. 따라서 표본평균은 μ의 불편추정량입니다.
- 표준오차 (\(\sigma_{\bar{x}}\)): x̄의 표본분포의 표준편차로, \(\sigma/\sqrt{n}\)과 같습니다.
- 표본평균의 분산 (\(\sigma_{\bar{x}}^2\)): 표준오차의 제곱, 즉 \(\sigma^2/n\)입니다.
- 중심극한정리: 유한한 분산을 가진 모집단에서 독립적으로 관측한 경우, 모집단의 모양과 관계없이 표본 크기 n이 커질수록 x̄의 표본분포는 정규분포에 가까워집니다.
자주 묻는 질문
표본이 커지면 왜 표준오차가 작아지나요? 표본이 클수록 우연한 변동이 서로 상쇄되어 평균값이 실제 평균 주위에 더 촘촘하게 모이기 때문입니다.
모집단이 반드시 정규분포여야 하나요? 여기서 쓰는 공식에는 그럴 필요가 없습니다. 평균과 표준오차는 어떤 모집단에서도 정확하게 성립합니다. 다만 표집분포가 정규분포에 가까워지는 것은 중심극한정리에 따라 \(n\)이 클 때 근사적으로 나타나는 성질입니다.
표본 표준편차밖에 모를 때는요? \(\sigma\)를 모를 때는 표본 표준편차 \(s\)를 추정값으로 사용하면 됩니다. 이때 표준오차는 \(s/\sqrt{n}\)이 되며, 보통 t-분포와 함께 사용합니다.