什麼是樣本平均數的抽樣分配?
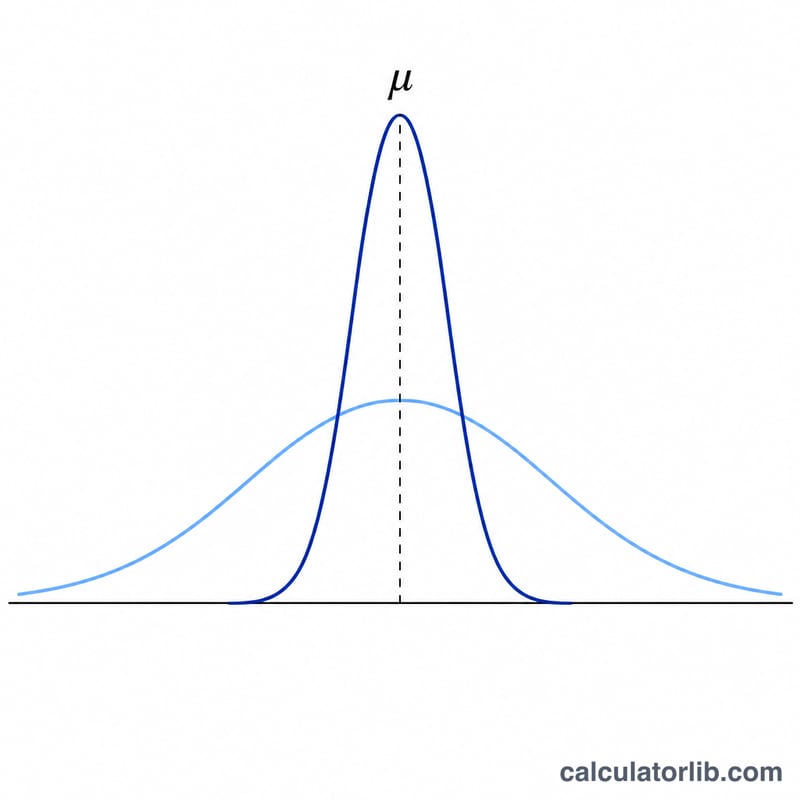
如果你從一個母體中反覆抽取大小為 \(n\) 的隨機樣本,並計算每一組樣本的平均數,這些平均數本身也會形成一個分配,這就是樣本平均數的抽樣分配。本計算器只要三個數值,就能算出這個分配的中心(平均數)與離散程度(標準誤):母體平均數 \(\mu\)、母體標準差 \(\sigma\),以及樣本數 \(n\)。
如何使用本計算器
輸入母體平均數(\(\mu\))、母體標準差(\(\sigma\))與你的樣本數(\(n\)),工具會回傳抽樣分配的平均數(\(\mu_{\bar{x}}\))、標準誤(\(\sigma_{\bar{x}}\))以及樣本平均數的變異數(\(\sigma_{\bar{x}}^{2}\))。標準誤代表的是:各組樣本平均數與真正母體平均數之間,通常會有多大的偏離程度。
公式解析
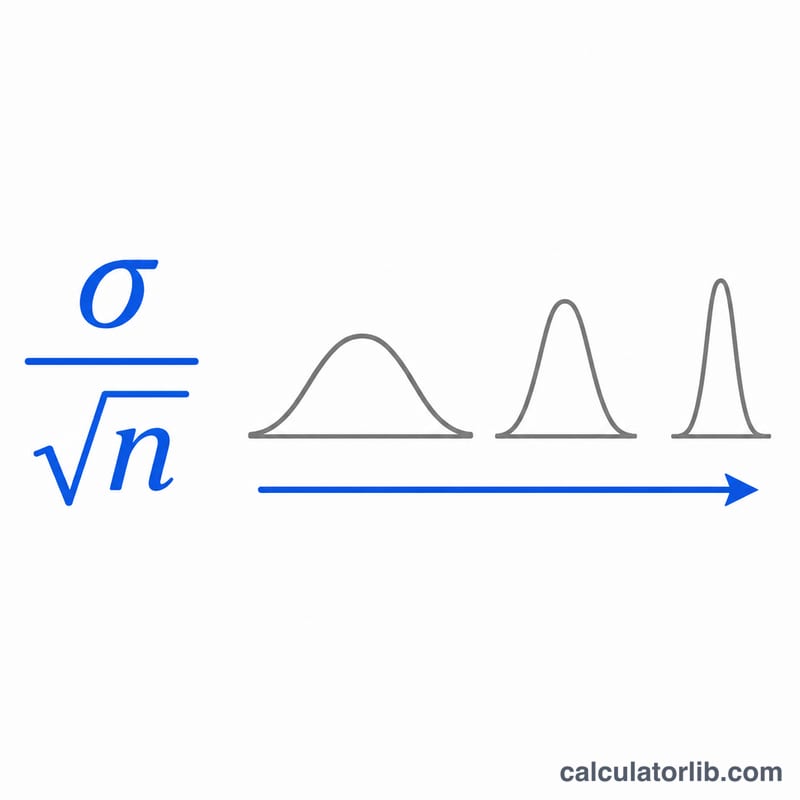
抽樣分配的平均數永遠等於母體平均數:\(\mu_{\bar{x}} = \mu\)。而離散程度則會隨著樣本變大而縮小:\(\sigma_{\bar{x}} = \sigma/\sqrt{n}\)。
$$\mu_{\bar{x}} = \mu \qquad \sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$由於分母是 \(n\) 的平方根,所以樣本數加倍並不會讓標準誤減半——想把標準誤砍掉一半,必須把 \(n\) 變成四倍。根據中央極限定理,當 \(n\) 夠大時,不論母體原本的形狀如何,這個抽樣分配都會近似常態分配。
範例演練
假設 \(\mu = 100\)、\(\sigma = 15\)、\(n = 25\)。那麼 \(\mu_{\bar{x}} = 100\),
$$\sigma_{\bar{x}} = \frac{15}{\sqrt{25}} = \frac{15}{5} = 3$$變異數為 \(\sigma_{\bar{x}}^{2} = 3^{2} = 9\)。換句話說,由 25 筆觀測值算出的樣本平均數,會集中在 100 附近,標準誤為 3。
樣本數如何改變標準誤
此表將母體平均數固定為 \(\mu = 100\)、母體標準差固定為 \(\sigma = 15\),再改變樣本數 \(n\)。抽樣分配的平均數在每一列都維持為 100,只有離散程度會改變。
| 樣本數 n | 標準誤 \(\sigma/\sqrt{n}\) | 變異數 \(\sigma^2/n\) | 標準誤與 σ 的比值 |
|---|---|---|---|
| 1 | 15 | 225 | 1 |
| 4 | 7.5 | 56.25 | 0.5 |
| 9 | 5 | 25 | 0.3333 |
| 25 | 3 | 9 | 0.2 |
| 100 | 1.5 | 2.25 | 0.1 |
| 400 | 0.75 | 0.5625 | 0.05 |
標準誤與 σ 的比值等於 \(1/\sqrt{n}\)。由於有平方根的關係,樣本數變為四倍時,標準誤會減半:從 n = 1 增至 4、從 4 增至 16(或從 25 增至 100、從 100 增至 400),標準誤每次都會減為一半。若要將標準誤降為十分之一,則需要 100 倍的觀測數,因此多蒐集資料的效益會遞減。
解讀標準誤
標準誤 \(\sigma_{\bar{x}} = \sigma/\sqrt{n}\) 衡量樣本平均數在不同樣本之間的變化幅度。若 \(\bar{x}\) 的抽樣分配近似為常態(依據中央極限定理,或因母體本身即為常態),則大約會有:
- 68% 的樣本平均數落在 μ 的 1 個標準誤範圍內,
- 95% 落在 2 個標準誤範圍內(更精確地說為 1.96),
- 99.7% 落在 3 個標準誤範圍內。
範例:當 \(\mu = 100\) 且 \(\sigma_{\bar{x}} = 3\)(例如 σ = 15、n = 25)時:
| 涵蓋機率 | 區間 | 樣本平均數範圍 |
|---|---|---|
| ≈ 68% | \(100 \pm 1(3)\) | 97 至 103 |
| ≈ 95% | \(100 \pm 2(3)\) | 94 至 106 |
| ≈ 99.7% | \(100 \pm 3(3)\) | 91 至 109 |
標準誤與標準差的差異。母體標準差 σ 描述個別數值圍繞 μ 的變化程度。標準誤則描述樣本平均數圍繞 μ 的變化程度。當 n > 1 時,標準誤一定小於 σ,且會隨 n 增加而縮小。
常態性與樣本數。一般經驗法則認為 n ≥ 30 即足以讓平均數的抽樣分配近似為常態。這僅是一項指引:對於近似對稱的母體,較小的 n 可能已足夠;但對於嚴重偏態或厚尾的母體,則可能需要多得多的樣本。
有限母體。公式 σ/√n 假設為放回抽樣或母體非常大。若為不放回抽樣,且樣本超過母體大小 N 的約 5%,則標準誤需乘上有限母體校正因子 \(\sqrt{\frac{N-n}{N-1}}\),使其變小。本計算機未套用此校正。
關鍵名詞與符號
- 母體平均數 (μ):母體中所有數值的平均值。
- 母體標準差 (σ):母體中個別數值與 μ 的典型距離。
- 樣本數 (n):每個樣本中的觀測值個數。
- 樣本平均數 (x̄):一個樣本中 n 個觀測值的平均值;它會因樣本不同而變動。
- 抽樣分配:統計量(此處為 x̄)在母體中所有大小為 n 的可能樣本上的機率分配。
- 抽樣分配的平均數 (\(\mu_{\bar{x}}\)):x̄ 的期望值,等於 μ,因此樣本平均數是 μ 的不偏估計量。
- 標準誤 (\(\sigma_{\bar{x}}\)):x̄ 抽樣分配的標準差,等於 \(\sigma/\sqrt{n}\)。
- 樣本平均數的變異數 (\(\sigma_{\bar{x}}^2\)):標準誤的平方,即 \(\sigma^2/n\)。
- 中央極限定理:對於來自具有有限變異數之母體的獨立觀測值,隨著 n 增加,x̄ 的抽樣分配會趨近於常態分配,與母體的形狀無關。
常見問題
為什麼樣本越大,標準誤就越小?樣本越大,隨機波動越容易被平均掉,因此各組樣本平均數會更緊密地圍繞在真正的平均數附近。
母體一定要呈常態分配嗎?就這裡的公式而言並不需要。無論母體為何種分配,平均數與標準誤的計算都是精確的。至於抽樣分配本身要近似常態,則需透過中央極限定理,在 \(n\) 夠大時成立。
如果我只有樣本標準差怎麼辦?當 \(\sigma\) 未知時,可改用樣本標準差 \(s\) 作為估計值,此時標準誤變成 \(s/\sqrt{n}\),通常會搭配 \(t\) 分配一起使用。