¿Qué es la distribución muestral de la media?
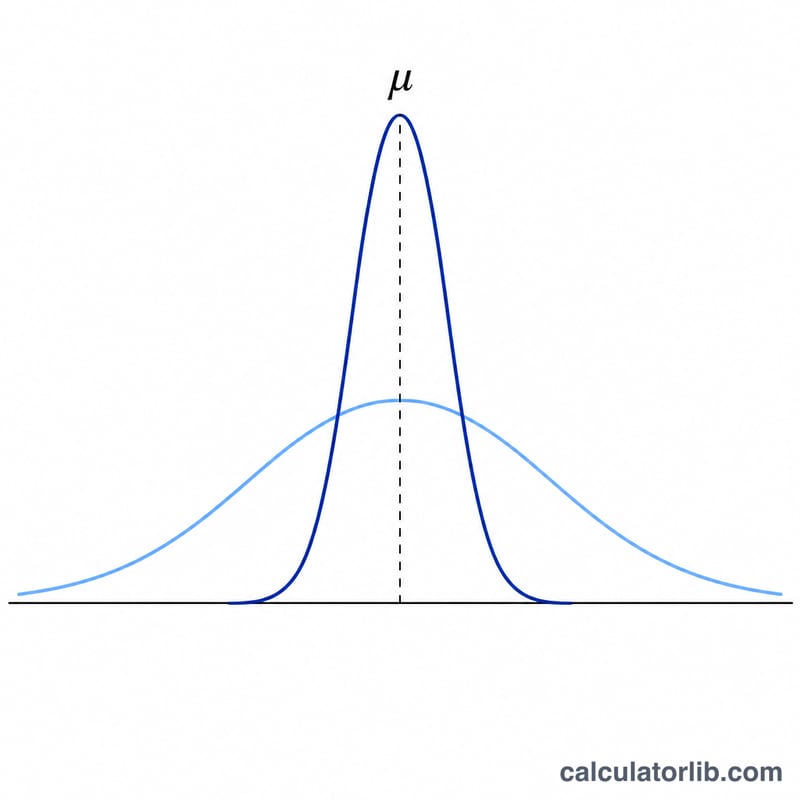
Cuando extraes de forma repetida muestras aleatorias de tamaño n de una población y calculas la media de cada muestra, esas medias forman su propia distribución: la distribución muestral de la media. Esta calculadora determina su centro (la media) y su dispersión (el error estándar) a partir de tres datos: la media poblacional \(\mu\), la desviación típica poblacional \(\sigma\) y el tamaño de la muestra \(n\).
Cómo usar esta calculadora
Introduce la media poblacional (\(\mu\)), la desviación típica poblacional (\(\sigma\)) y el tamaño de tu muestra (\(n\)). La herramienta te devuelve la media de la distribución muestral (\(\mu_{\bar{x}}\)), el error estándar (\(\sigma_{\bar{x}}\)) y la varianza de la media muestral (\(\sigma_{\bar{x}}^{2}\)). El error estándar indica cuánto suelen variar las medias muestrales respecto a la verdadera media poblacional.
La fórmula, paso a paso
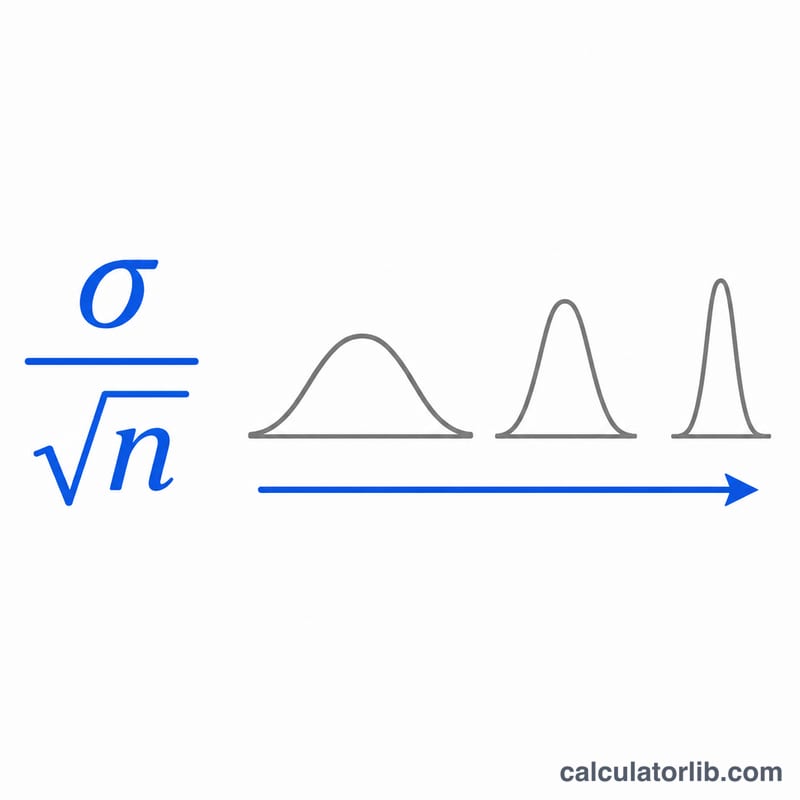
La media de la distribución muestral siempre coincide con la media poblacional: \(\mu_{\bar{x}} = \mu\). La dispersión se reduce a medida que las muestras son más grandes:
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$Como dividimos entre la raíz cuadrada de \(n\), duplicar el tamaño de la muestra no reduce a la mitad el error estándar: hay que cuadruplicar \(n\) para dividir el error estándar entre dos. Según el teorema central del límite, para valores grandes de \(n\) esta distribución es aproximadamente normal, sea cual sea la forma de la población.
Ejemplo resuelto
Supongamos que \(\mu = 100\), \(\sigma = 15\) y \(n = 25\). Entonces \(\mu_{\bar{x}} = 100\) y
$$\sigma_{\bar{x}} = \frac{15}{\sqrt{25}} = \frac{15}{5} = 3$$La varianza es \(\sigma_{\bar{x}}^{2} = 3^{2} = 9\). Así, las medias de muestras de 25 observaciones se agrupan en torno a 100 con un error estándar de 3.
Cómo el tamaño de la muestra cambia el error estándar
La tabla fija la media poblacional en \(\mu = 100\) y la desviación estándar poblacional en \(\sigma = 15\), y luego varía el tamaño de la muestra \(n\). La media de la distribución muestral se mantiene en 100 en cada fila. Solo cambia la dispersión.
| Tamaño de muestra n | Error estándar \(\sigma/\sqrt{n}\) | Varianza \(\sigma^2/n\) | Error estándar como razón de σ |
|---|---|---|---|
| 1 | 15 | 225 | 1 |
| 4 | 7.5 | 56.25 | 0.5 |
| 9 | 5 | 25 | 0.3333 |
| 25 | 3 | 9 | 0.2 |
| 100 | 1.5 | 2.25 | 0.1 |
| 400 | 0.75 | 0.5625 | 0.05 |
La razón entre el error estándar y σ es igual a \(1/\sqrt{n}\). Debido a la raíz cuadrada, cuadruplicar el tamaño de la muestra reduce a la mitad el error estándar: al pasar de n = 1 a 4, de 4 a 16 (o de 25 a 100, de 100 a 400), el error estándar se reduce a la mitad en cada caso. Reducirlo a una décima parte requiere 100 veces más observaciones, por lo que recopilar más datos tiene rendimientos decrecientes.
Interpretación del error estándar
El error estándar \(\sigma_{\bar{x}} = \sigma/\sqrt{n}\) mide cuánto varían las medias muestrales de una muestra a otra. Si la distribución muestral de \(\bar{x}\) es aproximadamente normal (por el Teorema Central del Límite, o porque la población en sí es normal), entonces aproximadamente:
- 68% de las medias muestrales caen dentro de 1 error estándar de μ,
- 95% caen dentro de 2 errores estándar (más precisamente, 1.96),
- 99.7% caen dentro de 3 errores estándar.
Ejemplo: con \(\mu = 100\) y \(\sigma_{\bar{x}} = 3\) (por ejemplo, σ = 15 y n = 25):
| Cobertura | Intervalo | Rango de medias muestrales |
|---|---|---|
| ≈ 68% | \(100 \pm 1(3)\) | 97 a 103 |
| ≈ 95% | \(100 \pm 2(3)\) | 94 a 106 |
| ≈ 99.7% | \(100 \pm 3(3)\) | 91 a 109 |
Error estándar vs. desviación estándar. La desviación estándar poblacional σ describe cómo varían los valores individuales alrededor de μ. El error estándar describe cómo varían las medias muestrales alrededor de μ. Siempre es menor que σ cuando n > 1, y disminuye a medida que n aumenta.
Normalidad y tamaño de la muestra. Una regla práctica común dice que n ≥ 30 es suficiente para que la distribución muestral de la media sea aproximadamente normal. Esto es solo una guía: para poblaciones aproximadamente simétricas puede bastar un n menor, mientras que para poblaciones muy asimétricas o de colas pesadas puede necesitarse considerablemente más.
Poblaciones finitas. La fórmula σ/√n supone muestreo con reemplazo o una población muy grande. Cuando se muestrea sin reemplazo y la muestra supera aproximadamente el 5% de una población de tamaño N, el error estándar se multiplica por el factor de corrección para poblaciones finitas \(\sqrt{\frac{N-n}{N-1}}\), que lo hace más pequeño. Esta calculadora no aplica esa corrección.
Términos y símbolos clave
- Media poblacional (μ): el promedio de todos los valores de la población.
- Desviación estándar poblacional (σ): la distancia típica de los valores individuales respecto a μ en la población.
- Tamaño de la muestra (n): el número de observaciones en cada muestra.
- Media muestral (x̄): el promedio de las n observaciones de una muestra; varía de una muestra a otra.
- Distribución muestral: la distribución de probabilidad de un estadístico (aquí x̄) sobre todas las muestras posibles de tamaño n de la población.
- Media de la distribución muestral (\(\mu_{\bar{x}}\)): el valor esperado de x̄, que es igual a μ, por lo que la media muestral es un estimador insesgado de μ.
- Error estándar (\(\sigma_{\bar{x}}\)): la desviación estándar de la distribución muestral de x̄, igual a \(\sigma/\sqrt{n}\).
- Varianza de la media muestral (\(\sigma_{\bar{x}}^2\)): el cuadrado del error estándar, \(\sigma^2/n\).
- Teorema Central del Límite: para observaciones independientes de una población con varianza finita, la distribución muestral de x̄ se aproxima a una distribución normal a medida que n aumenta, sin importar la forma de la población.
Preguntas frecuentes
¿Por qué el error estándar disminuye con muestras más grandes? Las muestras más grandes promedian las fluctuaciones aleatorias, de modo que sus medias se concentran más cerca de la media verdadera.
¿La población tiene que ser normal? No para las fórmulas que aquí usamos. La media y el error estándar son exactos para cualquier población. La normalidad de la distribución muestral se cumple de forma aproximada cuando \(n\) es grande, gracias al teorema central del límite.
¿Y si solo conozco la desviación típica de la muestra? Si \(\sigma\) es desconocida, utiliza la desviación típica muestral \(s\) como estimación; el error estándar pasa a ser \(s/\sqrt{n}\), que suele emplearse junto con la distribución t.