LLM VRAM必要量 計算ツールとは?
このツールは、大規模言語モデル(LLM)を推論用に読み込んで動かすために、GPUのビデオメモリ(VRAM)がどれくらい必要かを見積もるためのものです。必要なメモリ量は、主にモデルのパラメータ数と、各重みを格納する際の数値精度によって決まります。さらにオーバーヘッド(安全係数)を掛けることで、生の重み以外に消費されるKVキャッシュ・アクティベーション・CUDAコンテキストなどの分も考慮できます。
使い方
まず、モデルサイズを「10億(B)単位」のパラメータ数で入力します(例:7Bモデルなら「7」、Llama-3 70Bなら「70」)。次に精度を選びます。FP32は重み1つあたり4バイト、FP16/BF16は2バイト、INT8は1バイト、INT4量子化は0.5バイトです。最後にオーバーヘッド係数を設定します。短いコンテキストの推論なら1.2(20%のバッファ)が手頃な初期値で、長いコンテキストやバッチ処理を行う場合は値を大きくしてください。
計算式の解説
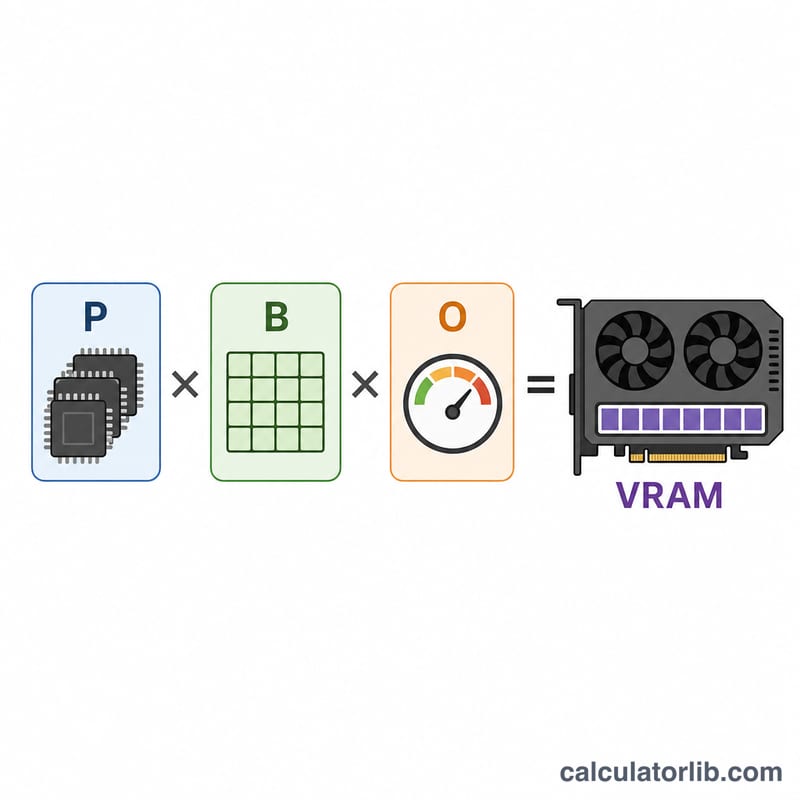
$$\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times \text{Overhead}$$10億バイト ≒ 1GB であるため、10億単位のパラメータ数に1パラメータあたりのバイト数を掛けると、そのままギガバイト(GB)の値が得られます。さらにオーバーヘッド係数を掛けることで、実行時に必要なメモリ分まで上乗せして見積もれます。
計算例
7BモデルをFP16で、オーバーヘッド係数1.2として計算すると、$$7 \times 2 \times 1.2 = 16.8\,\text{GB}$$となります。これなら24GBのカードに余裕を持って収まります。同じモデルをINT4にすると、$$7 \times 0.5 \times 1.2 = 4.2\,\text{GB}$$となり、8GBのGPUでも楽に動かせます。
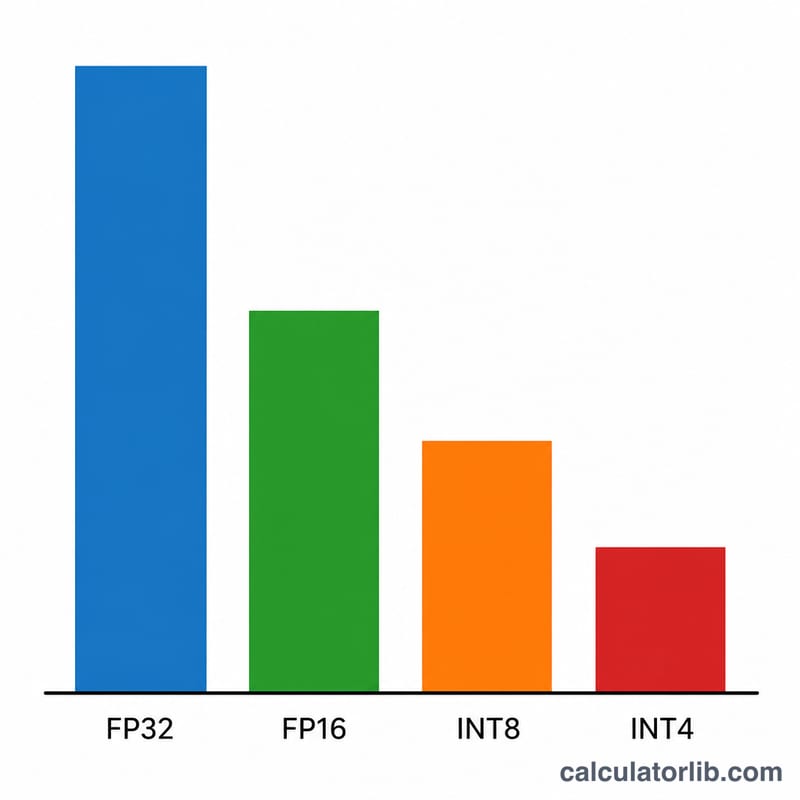
共通モデルサイズと精度別のVRAM見積もり
この表は、計算ツールの式を既定のオーバーヘッド係数1.2で使用しています:\(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\)。パラメータあたりのバイト数は、FP16が2、INT8が1、INT4が0.5です。「収まるGPU」の注記は、各結果を単一GPUの公称容量と比較したものであり、実際に使用可能な容量はそれより少し少なくなります。
| モデルサイズ | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
各見積もりに対応できるGPUクラス
- 7B:FP16には24GBのカードが必要です(16.8GBは16GBには多すぎます)。INT8は16GBに収まります。INT4は8GBに収まります。
- 13B:FP16には48GBが必要です。INT8(15.6GB)は16GBにかろうじて収まるため、24GBのほうが余裕があります。INT4(7.8GB)は8GBではかなりギリギリなので、実用的には16GBを選ぶことになります。
- 34B:FP16(81.6GB)は単一の80GBカードを超えるため、複数のGPUが必要です。INT8は48GBに収まります。INT4は24GBに収まります。
- 70B:FP16(168GB)には少なくとも3枚の80GB GPUが必要です。INT8(84GB)は1枚の80GBカードを超えるため、2枚のGPUが必要です(例:2×48GBまたは2×80GB)。INT4(42GB)は48GBに収まります。
- 405B:すべての精度で複数のGPUが必要です。FP16には少なくとも13枚の80GBカードが、INT8には少なくとも7枚、INT4には少なくとも4枚が必要です。
見積もりが1枚のカードのメモリを超える場合、モデルは複数のGPUに分割する必要があります(テンソル並列またはパイプライン並列)。その場合、相互接続の速度やGPUごとのオーバーヘッドが影響するため、単純な割り算以上に余裕を見込んでください。
フォーマット別のパラメータあたりのバイト数
| フォーマット | パラメータあたりのバイト数 | 一般的な用途 |
|---|---|---|
| FP32 | 4 | 学習の基準値、研究、数値的に繊細な作業。LLMの提供にはほとんど使われません。 |
| FP16 / BF16 | 2 | 標準的な高品質推論、および公開されたチェックポイントで一般的に使われる保存形式 |
| FP8 / INT8 | 1 | 対応するハードウェアとソフトウェアでの効率的な提供。品質低下はわずか。 |
| INT4 | 0.5 | ローカル推論や消費者向けGPU向けの積極的な量子化。ある程度の品質低下あり。 |
実用的な4ビット形式に関する注記:GGUF Q4_K_M、GPTQ、AWQなどの実用的な4ビット方式は、グループごとのスケールやその他のメタデータを保存します。そのため、重み1つあたり0.5バイトよりわずかに多く、おおよそ0.55~0.65バイトを使用します。これらの形式では、オーバーヘッド係数を少し上げるか、INT4の結果がわずかに過小評価されていると考えてください。
用途別の典型的なオーバーヘッド係数
| 用途 | オーバーヘッド係数 |
|---|---|
| 短いコンテキスト、単一ユーザー | 約1.2 |
| 長いコンテキストまたは中程度のバッチ処理 | 約1.5~2.0 |
| 大量のバッチ処理または非常に長いコンテキストの提供 | 2.0以上 |
これらは経験則であり、固定された標準ではありません。推論エンジン、コンテキスト長、同時接続数によって実際の値が決まります。
VRAM見積もりの解釈
結果は、推論用の近似的な下限寄りの見積もりです。重みのメモリを計算し、KVキャッシュ、アクティベーション、CUDAコンテキスト、フレームワークのバッファ用に一律の割合を加えています。これは正確な測定値ではなく、学習は対象外です。学習では勾配やオプティマイザの状態も保存するため、数倍のメモリが必要になることがあります。
KVキャッシュのスケール
KVキャッシュは、コンテキスト長、バッチサイズ、レイヤー数、キー/値投影の隠れ次元に比例して線形に増加します:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
ここで\(L\)はレイヤー数、\(d_{kv}\)はキー/値の幅、\(T\)はトークン単位のコンテキスト長、\(B\)はバッチサイズ(同時実行シーケンス数)、\(b\)はキャッシュ要素あたりのバイト数です。係数2はキーと値の両方を表します。例として、標準のマルチヘッドアテンション、32レイヤー、隠れサイズ4096、4096トークンのFP16キャッシュを持つモデルでは、\(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\)バイト、つまりシーケンスあたり約2.1GBが必要です。グループ化クエリアテンションを使うモデルは\(d_{kv}\)が小さいため、キャッシュははるかに小さくなります。長いコンテキストや多数の同時ユーザーの場合、キャッシュは重みと同程度か、それを超えることもあるため、その場合はオーバーヘッド係数を上げてください。
使用可能メモリとの比較
見積もりは公称値ではなく、GPUの使用可能メモリと比較してください。ドライバ、CUDAコンテキスト、(GPUがモニターも駆動する場合は)ディスプレイがメモリを一部使用し、推論エンジンは残りの一部を通常予約します。24GBと表示されたカードでも、モデルに使える量は通常かなり少なくなります。見積もりがカードの容量の数パーセント以内であれば、収まらないと想定してください。
複数GPU
テンソル並列では、重みとKVキャッシュがGPU間で分割されるため、各カードはおおよそその分担分を保持します。各GPUは依然として独自のCUDAコンテキストとバッファを持ち、通信バッファがさらに加わるため、すべてのGPUの合計は単一GPUの見積もりよりいくらか多くなります。
Mixture-of-Experts(MoE)モデル
Mixture-of-Experts(MoE)モデルでは、アクティブなパラメータ数ではなく、総パラメータ数を入力してください。トークンごとに一部のエキスパートだけが動作するため計算量は減りますが、ルーターがどのエキスパートも選べるように、通常はすべてのエキスパートの重みをVRAMに常駐させておく必要があります。
これは計画用の一般的な情報です。実際の使用量は、ご自身のソフトウェアとワークロードで確認してください。
よくある質問(FAQ)
なぜ実際の使用量は、生の重みより大きくなるのですか? KVキャッシュはコンテキスト長やバッチサイズに応じて増加し、フレームワークもアクティベーションやバッファ用にメモリを確保します。オーバーヘッド係数は、こうした分をおおまかに見込むためのものです。
これは学習(トレーニング)も含みますか? いいえ。学習ではオプティマイザの状態や勾配のために、おおよそ3〜4倍のメモリが必要になります。この見積もりはあくまで推論を対象としています。
オーバーヘッド係数はどれくらいにすべきですか? 短いプロンプトなら約1.2、長いコンテキストや重いバッチ処理では1.5〜2.0以上を目安にしてください。