この計算ツールでできること
このツールは、サンプルから得られた平均値(μ)と標準偏差(σ)をもとに、「真の値」がどの範囲に収まりやすいかを推定します。対象となる量が正規分布に従うと仮定し、左右対称の両側区間 \(\mu \pm z \cdot \sigma\) を算出します。ここで \(z\) は、選んだ信頼度に対応する標準正規分布の臨界値です。平均値と標準偏差は単なる数値として扱い、区間は入力した単位のまま返されます。
使い方
平均値、標準偏差(0以上)、そして信頼度をパーセントで入力します。信頼度は50<信頼度<100の範囲(一般的には95)で指定してください。ツールはパーセントを確率 \(p\) に変換し、臨界値 \(z = \Phi^{-1}\!\left(\frac{1+p}{2}\right)\) を求めて、下限と上限を返します。信頼度が100%のときは区間が無限に広がってしまうため、100未満に保つ必要があります。
計算式の解説
確率を \(p = \text{信頼度}/100\) とすると、両側の \(z\) 値は \(\frac{1+p}{2}\) における標準正規分布の分位点になります。95%なら \(\Phi^{-1}(0.975) \approx 1.95996\) なので、区間は \(\mu \pm 1.96\sigma\) です。覚えておくと便利な目安として、68.26%は \(\mu \pm 1\sigma\)、95.45%は \(\mu \pm 2\sigma\)、99.73%は \(\mu \pm 3\sigma\) に対応します。逆正規累積分布関数(逆CDF)は有理式による近似(Acklam法)にHalley法の補正を加えて計算しているため、数表を引く必要はありません。
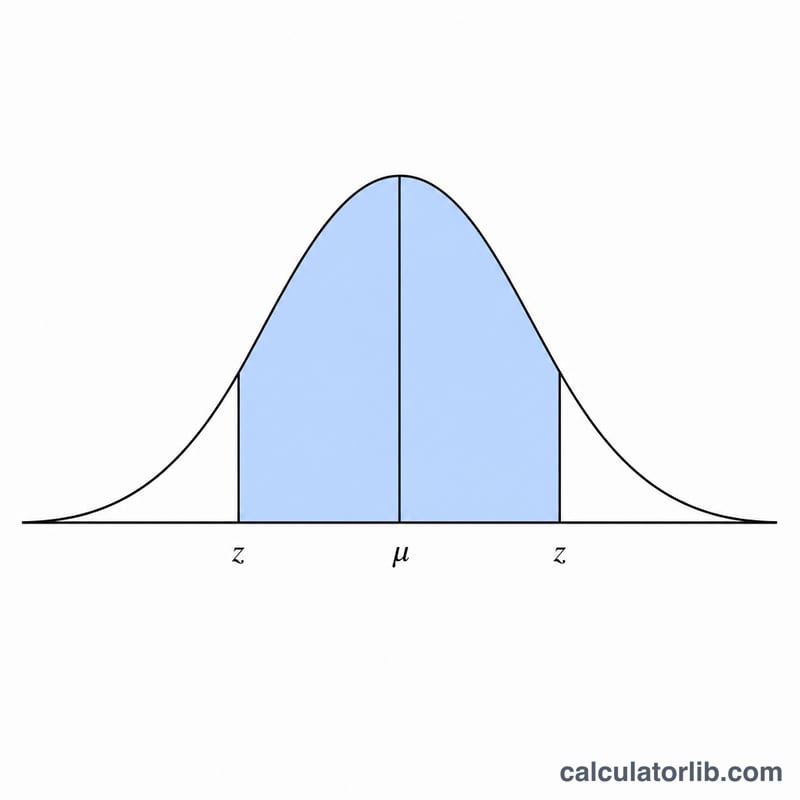
計算例
平均値 = 100、標準偏差 = 5、信頼度 = 99% の場合:\(p = 0.99\)、\(z = \Phi^{-1}(0.995) \approx 2.57583\) となります。 $$\text{下限} = 100 - 2.57583 \cdot 5 = 87.121$$ $$\text{上限} = 100 + 12.879 = 112.879$$ 結果は「87.12 から 112.88 の間」と表示されます。
一般的な信頼水準と Z 値
両側臨界値は \(z = \Phi^{-1}\left(\frac{1+p}{2}\right)\) で求められます。ここで \(p\) は小数で表した信頼水準です。表には、各水準に使われる累積確率 \((1+p)/2\) と、標準正規分布における z 値が示されています。
| 信頼水準 | 片側確率 (1+p)/2 | 両側 z |
|---|---|---|
| 50% | 0.75 | 0.6745 |
| 68.27% | 0.84135 | 1.0000 |
| 80% | 0.90 | 1.2816 |
| 90% | 0.95 | 1.6449 |
| 95% | 0.975 | 1.9600 |
| 95.45% | 0.97725 | 2.0000 |
| 98% | 0.99 | 2.3263 |
| 99% | 0.995 | 2.5758 |
| 99.73% | 0.99865 | 3.0000 |
| 99.9% | 0.9995 | 3.2905 |
68.27%、95.45%、99.73% の各行は、おなじみの 1、2、3 標準偏差のルールに対応しています。
区間の解釈
この計算機は \(\text{平均} \pm z \cdot \text{SD}\) を返します。正規分布の下では、これは指定した割合の個々の値が含まれると予想される範囲です。例えば、平均が 100、SD が 15 で信頼水準 95% の場合、区間は \(100 \pm 1.96 \times 15 = 100 \pm 29.4\)、すなわち 70.6 から 129.4 になります。値のおよそ 95% がこの範囲に入ると予想されます。
母平均に対する信頼区間とは異なります。 母平均の信頼区間は、SD の代わりに標準誤差 \(\text{SD}/\sqrt{n}\) を用います。その区間はずっと狭く、標本サイズ \(n\) が大きくなるほど縮小します。ここでの区間は個々の値のばらつき、つまり1回の測定値が取りうる範囲を表します。平均がどれほど正確に分かっているかを表すものではありません。
- 信頼水準を高めると区間は広がります。 半幅は \(z \cdot \text{SD}\) に等しいため、z に比例して大きくなります。95%(z = 1.9600)から 99%(z = 2.5758)に上げると、区間はおよそ 31% 広くなります。
- 対称性。 区間は平均を中心とし、上下で等距離になります。
- 前提条件。 結果が有効なのは、データがほぼ正規分布に従い、平均と SD が信頼できる(既知とみなせる)場合に限られます。データが歪んでいる、裾が重い、外れ値がある、または標本が小さい場合、実際のカバー率は示された水準から大きくずれることがあります。
主な用語
- 平均 (μ)
- 平均的な値であり、分布と区間の中心となる値です。
- 標準偏差 (σ)
- 値が平均の周りにどの程度広がっているかを示す尺度で、データと同じ単位で表されます。
- 信頼水準
- 区間が含むことを意図している値の割合(または確率)で、例えば 95% などです。
- 臨界値 z
- 選んだ信頼水準を囲むのに必要な、平均からの標準偏差の数です。95% の場合は 1.9600 になります。
- 正規分布
- 平均と標準偏差によって完全に決まる、左右対称で釣り鐘型の分布です。
- 逆累積分布関数 / 分位関数 (Φ⁻¹)
- 累積確率を受け取り、その確率を下回るような z 値を返す関数です。例えば Φ⁻¹(0.975) = 1.9600 です。
- 両側区間と片側区間
- 両側区間は両端に等しい裾を残すため、裾の確率は (1+p)/2 になります。片側の上限・下限は除外される確率をすべて一方の裾に置き、代わりに Φ⁻¹(p) を用います。
- 誤差の余裕 (z·σ)
- 区間の半幅で、平均から両端のいずれかの端点までの距離です。
よくある質問
なぜ95%で1.645ではなく1.96を使うのですか? 左右対称の両側区間では、残りの5%を両側それぞれ2.5%ずつに分けるため、\(\Phi^{-1}(0.975) \approx 1.96\) となります。1.645は片側95%の分位点であり、両側の範囲には適しません。
t分布を使うべきではないですか? 小さなサンプルから \(\sigma\) を推定する場合は、サンプルサイズ \(n\) を用いた t分布(区間 \(\text{平均値} \pm t \cdot s/\sqrt{n}\))の方が適切です。このツールは \(\sigma\) をあらかじめ分かっている母集団の値として扱い、正規分布の \(z\) を使うため、\(n\) を必要としません。
標準偏差が0のときは? 区間は1点 [平均値, 平均値] に縮まります。