À quoi sert ce calculateur
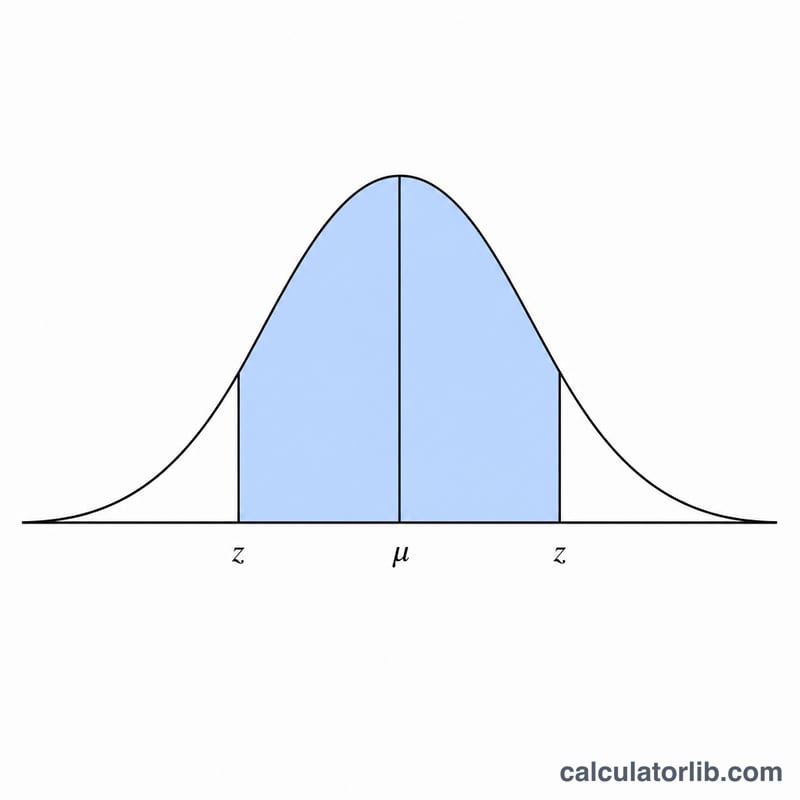
Cet outil estime la plage dans laquelle une « vraie valeur » a de fortes chances de se trouver, à partir d'une moyenne (\(\mu\)) et d'un écart-type (\(\sigma\)) issus d'un échantillon. Il suppose que la grandeur suit une loi normale et renvoie l'intervalle bilatéral symétrique \(\mu \pm z\cdot\sigma\), où \(z\) est la valeur critique de la loi normale centrée réduite associée au niveau de confiance choisi. La moyenne et l'écart-type sont de simples nombres, et l'intervalle est exprimé dans les unités que vous avez saisies.
Comment l'utiliser
Saisissez votre moyenne, votre écart-type (qui doit être supérieur ou égal à 0) et un niveau de confiance en pourcentage tel que 50 < confiance < 100 (le plus souvent 95). Le calculateur convertit ce pourcentage en une probabilité \(p\), détermine la valeur critique $$z = \Phi^{-1}\!\left(\frac{1+p}{2}\right),$$ puis renvoie les bornes inférieure et supérieure. À 100 %, l'intervalle deviendrait infini : la confiance doit donc rester strictement inférieure à 100.
La formule expliquée
Pour une probabilité \(p = \text{confiance}/100\), la valeur \(z\) bilatérale correspond au quantile de la loi normale centrée réduite en \((1+p)/2\). Pour 95 %, on a \(\Phi^{-1}(0{,}975) \approx 1{,}95996\), ce qui donne l'intervalle \(\mu \pm 1{,}96\,\sigma\). Quelques repères utiles : une couverture de 68,26 % équivaut à \(\mu \pm 1\sigma\), 95,45 % à \(\mu \pm 2\sigma\) et 99,73 % à \(\mu \pm 3\sigma\). La fonction de répartition inverse de la loi normale est calculée à l'aide d'une approximation rationnelle (Acklam) suivie d'une étape de raffinement de Halley : aucune table de valeurs n'est donc nécessaire.
Exemple concret
Avec une moyenne = 100, un écart-type = 5 et une confiance = 99 % : \(p = 0{,}99\), \(z = \Phi^{-1}(0{,}995) \approx 2{,}57583\). $$\text{Borne inférieure} = 100 - 2{,}57583\cdot 5 = 87{,}121$$ $$\text{Borne supérieure} = 100 + 12{,}879 = 112{,}879$$ Le résultat affiche « entre 87,12 et 112,88 ».
Niveaux de confiance courants et valeurs z
La valeur critique bilatérale est \(z = \Phi^{-1}\left(\frac{1+p}{2}\right)\), où \(p\) est le niveau de confiance exprimé sous forme de proportion. Le tableau indique la probabilité cumulée \((1+p)/2\) utilisée pour chaque niveau, ainsi que le z correspondant pour une loi normale centrée réduite.
| Niveau de confiance | Probabilité de queue (1+p)/2 | z bilatéral |
|---|---|---|
| 50% | 0,75 | 0,6745 |
| 68,27% | 0,84135 | 1,0000 |
| 80% | 0,90 | 1,2816 |
| 90% | 0,95 | 1,6449 |
| 95% | 0,975 | 1,9600 |
| 95,45% | 0,97725 | 2,0000 |
| 98% | 0,99 | 2,3263 |
| 99% | 0,995 | 2,5758 |
| 99,73% | 0,99865 | 3,0000 |
| 99,9% | 0,9995 | 3,2905 |
Les lignes 68,27%, 95,45% et 99,73% correspondent à la règle familière des 1, 2 et 3 écarts-types.
Interpréter l'intervalle
Cette calculatrice renvoie \(\text{Moyenne} \pm z \cdot \text{ET}\). Sous une loi normale, il s'agit de la plage censée contenir la proportion indiquée des valeurs individuelles. Par exemple, avec une moyenne de 100 et un ET de 15 à 95 % de confiance, l'intervalle est \(100 \pm 1,96 \times 15 = 100 \pm 29,4\), soit de 70,6 à 129,4. Environ 95 % des valeurs devraient se situer dans cette plage.
Ne pas confondre avec un intervalle de confiance pour la moyenne. Un intervalle de confiance pour une moyenne de population utilise l'erreur type, \(\text{ET}/\sqrt{n}\), à la place de l'ET. Cet intervalle est beaucoup plus étroit et se réduit lorsque la taille d'échantillon \(n\) augmente. L'intervalle présenté ici décrit la dispersion des valeurs individuelles, c'est-à-dire la plage probable d'une mesure unique. Il ne décrit pas la précision avec laquelle la moyenne est connue.
- Élargir la confiance élargit l'intervalle. La demi-largeur est égale à \(z \cdot \text{ET}\), elle croît donc proportionnellement à z. Passer de 95 % (z = 1,9600) à 99 % (z = 2,5758) rend l'intervalle environ 31 % plus large.
- Symétrie. L'intervalle est centré sur la moyenne, avec une distance égale au-dessus et au-dessous.
- Hypothèses. Le résultat n'est valide que si les données suivent approximativement une loi normale et si la moyenne et l'ET sont fiables (considérés comme connus). Avec des données asymétriques, des queues lourdes, des valeurs aberrantes ou un petit échantillon, le taux de couverture réel peut différer sensiblement du niveau annoncé.
Termes clés
- Moyenne (μ)
- La valeur moyenne, qui est le centre de la distribution et de l'intervalle.
- Écart-type (σ)
- Une mesure de la dispersion des valeurs autour de la moyenne, exprimée dans la même unité que les données.
- Niveau de confiance
- La proportion de valeurs (ou la probabilité) que l'intervalle est censé couvrir, par exemple 95 %.
- Valeur critique z
- Le nombre d'écarts-types par rapport à la moyenne nécessaire pour englober le niveau de confiance choisi ; pour 95 %, il vaut 1,9600.
- Loi normale
- La distribution symétrique en forme de cloche, entièrement décrite par sa moyenne et son écart-type.
- Fonction quantile / inverse de la FDC (Φ⁻¹)
- La fonction qui prend une probabilité cumulée et renvoie la valeur z en dessous de laquelle se situe cette probabilité. Par exemple, Φ⁻¹(0,975) = 1,9600.
- Intervalle bilatéral ou unilatéral
- Un intervalle bilatéral laisse des queues égales aux deux extrémités, ce qui explique que la probabilité de queue soit (1+p)/2. Une borne unilatérale place toute la probabilité exclue dans une seule queue et utilise Φ⁻¹(p) à la place.
- Marge d'erreur (z·σ)
- La demi-largeur de l'intervalle, c'est-à-dire la distance entre la moyenne et l'une ou l'autre des extrémités.
FAQ
Pourquoi utilise-t-on 1,96 pour 95 %, et non 1,645 ? Un intervalle bilatéral symétrique répartit les 5 % restants en deux queues de 2,5 % chacune, ce qui donne \(\Phi^{-1}(0{,}975) \approx 1{,}96\). La valeur 1,645 correspond au quantile unilatéral à 95 % et n'est pas adaptée à une plage bilatérale.
Faut-il plutôt utiliser la loi de Student (t) ? Lorsque \(\sigma\) est estimé à partir d'un petit échantillon, une loi de Student à \(n\) degrés de liberté (intervalle \(\text{moyenne} \pm t\cdot s/\sqrt{n}\)) est plus appropriée. Cet outil traite délibérément \(\sigma\) comme une valeur connue de la population et utilise le \(z\) normal : il n'a donc pas besoin de \(n\).
Et si l'écart-type vaut 0 ? L'intervalle se réduit à un point unique \([\text{moyenne}, \text{moyenne}]\).