यह कैलकुलेटर क्या करता है
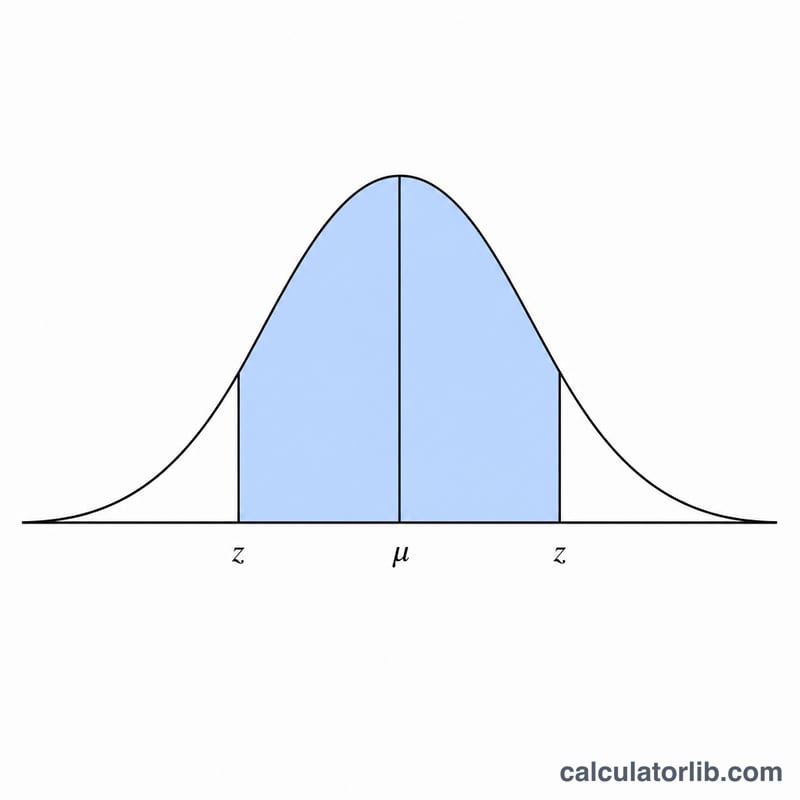
यह टूल किसी सैंपल के माध्य (μ) और मानक विचलन (σ) के आधार पर उस रेंज का अनुमान लगाता है जिसमें "वास्तविक मान" के होने की सबसे अधिक संभावना है। यह मानकर चलता है कि संबंधित राशि सामान्य वितरण (normal distribution) का पालन करती है, और सममित दोतरफा अंतराल \(\mu \pm z\cdot\sigma\) देता है, जहाँ \(z\) आपके चुने हुए विश्वास स्तर के लिए मानक-सामान्य क्रांतिक मान (critical value) होता है। माध्य और मानक विचलन सामान्य संख्याएँ हैं, और अंतराल उन्हीं इकाइयों में मिलता है जो आपने दी थीं।
इसका उपयोग कैसे करें
अपना माध्य, अपना मानक विचलन (जो 0 या उससे अधिक होना चाहिए), और विश्वास स्तर प्रतिशत में दर्ज करें, जहाँ 50 < विश्वास < 100 हो (आमतौर पर 95)। कैलकुलेटर प्रतिशत को प्रायिकता \(p\) में बदलता है, क्रांतिक मान \(z = \Phi^{-1}\!\left(\frac{1+p}{2}\right)\) निकालता है, और निचली व ऊपरी सीमा लौटाता है। 100% पर अंतराल अनंत हो जाएगा, इसलिए विश्वास स्तर 100 से कम ही रहना चाहिए।
सूत्र की व्याख्या
प्रायिकता \(p = \text{विश्वास}/100\) के लिए, दोतरफा \(z\) मान \((1+p)/2\) पर मानक सामान्य क्वांटाइल होता है। 95% के लिए यह \(\Phi^{-1}(0.975) \approx 1.95996\) है, इसलिए अंतराल \(\mu \pm 1.96\sigma\) बनता है। याद रखने योग्य कुछ मुख्य बिंदु: 68.26% कवरेज का मतलब \(\mu \pm 1\sigma\), 95.45% का मतलब \(\mu \pm 2\sigma\), और 99.73% का मतलब \(\mu \pm 3\sigma\) होता है। व्युत्क्रम सामान्य CDF की गणना एक रैशनल (Acklam) सन्निकटन और उसके बाद Halley परिशोधन चरण से की जाती है, इसलिए किसी लुकअप टेबल की ज़रूरत नहीं पड़ती।
हल किया हुआ उदाहरण
मान लीजिए माध्य = 100, sd = 5 और विश्वास = 99%: तब \(p = 0.99\), \(z = \Phi^{-1}(0.995) \approx 2.57583\)। $$\text{निचली सीमा} = 100 - 2.57583\cdot 5 = 87.121$$ $$\text{ऊपरी सीमा} = 100 + 12.879 = 112.879$$ परिणाम दिखेगा "87.12 और 112.88 के बीच"।
सामान्य विश्वास स्तर और Z-मान
दो-पक्षीय क्रिटिकल मान \(z = \Phi^{-1}\left(\frac{1+p}{2}\right)\) है, जहाँ \(p\) अनुपात के रूप में लिखा गया विश्वास स्तर है। तालिका हर स्तर के लिए उपयोग किया गया संचयी प्रायिकता \((1+p)/2\) और मानक सामान्य वितरण के लिए परिणामी z दिखाती है।
| विश्वास स्तर | पूंछ प्रायिकता (1+p)/2 | दो-पक्षीय z |
|---|---|---|
| 50% | 0.75 | 0.6745 |
| 68.27% | 0.84135 | 1.0000 |
| 80% | 0.90 | 1.2816 |
| 90% | 0.95 | 1.6449 |
| 95% | 0.975 | 1.9600 |
| 95.45% | 0.97725 | 2.0000 |
| 98% | 0.99 | 2.3263 |
| 99% | 0.995 | 2.5758 |
| 99.73% | 0.99865 | 3.0000 |
| 99.9% | 0.9995 | 3.2905 |
68.27%, 95.45% और 99.73% पंक्तियाँ परिचित 1, 2 और 3 मानक-विचलन नियम से मेल खाती हैं।
अंतराल की व्याख्या
यह कैलकुलेटर \(\text{माध्य} \pm z \cdot \text{SD}\) लौटाता है। सामान्य वितरण के तहत, यह वह सीमा है जिसमें व्यक्तिगत मानों का बताया गया अनुपात होने की अपेक्षा है। उदाहरण के लिए, माध्य 100 और SD 15 के साथ 95% विश्वास पर, अंतराल \(100 \pm 1.96 \times 15 = 100 \pm 29.4\) है, या 70.6 से 129.4। लगभग 95% मान उस सीमा में आने की अपेक्षा है।
माध्य के विश्वास अंतराल के समान नहीं। जनसंख्या माध्य के लिए विश्वास अंतराल SD की जगह मानक त्रुटि \(\text{SD}/\sqrt{n}\) का उपयोग करता है। वह अंतराल कहीं अधिक संकीर्ण होता है और नमूना आकार \(n\) बढ़ने पर सिकुड़ता है। यहाँ का अंतराल व्यक्तिगत मानों के प्रसार, या एक एकल माप की संभावित सीमा का वर्णन करता है। यह नहीं बताता कि माध्य कितनी सटीकता से ज्ञात है।
- विश्वास बढ़ाने से अंतराल चौड़ा होता है। अर्ध-चौड़ाई \(z \cdot \text{SD}\) के बराबर है, इसलिए यह z के अनुपात में बढ़ती है। 95% (z = 1.9600) से 99% (z = 2.5758) पर जाने से अंतराल लगभग 31% चौड़ा हो जाता है।
- समरूपता। अंतराल माध्य पर केंद्रित है, ऊपर और नीचे समान दूरी के साथ।
- मान्यताएँ। परिणाम तभी मान्य है जब डेटा लगभग सामान्य रूप से वितरित हो और माध्य व SD विश्वसनीय हों (ज्ञात माने गए हों)। विषम डेटा, भारी पूंछों, बाहरी मानों या छोटे नमूने के साथ, वास्तविक कवरेज बताए गए स्तर से काफी भिन्न हो सकता है।
मुख्य शब्द
- माध्य (μ)
- औसत मान, जो वितरण और अंतराल का केंद्र है।
- मानक विचलन (σ)
- मान माध्य के चारों ओर कितने व्यापक रूप से फैले हैं, इसका माप, डेटा की उसी इकाई में।
- विश्वास स्तर
- मानों (या प्रायिकता) का अनुपात जिसे अंतराल कवर करने के लिए है, जैसे 95%।
- क्रिटिकल मान z
- चुने हुए विश्वास स्तर को घेरने के लिए माध्य से आवश्यक मानक विचलनों की संख्या; 95% के लिए यह 1.9600 है।
- सामान्य वितरण
- सममित, घंटी-आकार का वितरण जिसका पूर्ण वर्णन इसके माध्य और मानक विचलन से होता है।
- व्युत्क्रम CDF / क्वांटाइल (Φ⁻¹)
- वह फलन जो संचयी प्रायिकता लेता है और वह z-मान लौटाता है जिसके नीचे वह प्रायिकता होती है। उदाहरण के लिए, Φ⁻¹(0.975) = 1.9600।
- दो-पक्षीय बनाम एक-पक्षीय अंतराल
- दो-पक्षीय अंतराल दोनों सिरों पर समान पूंछें छोड़ता है, इसीलिए पूंछ प्रायिकता (1+p)/2 है। एक-पक्षीय सीमा बहिष्कृत प्रायिकता को एक ही पूंछ में रखती है और इसके बजाय Φ⁻¹(p) का उपयोग करती है।
- त्रुटि की सीमा (z·σ)
- अंतराल की अर्ध-चौड़ाई, यानी माध्य से किसी भी अंतिम बिंदु तक की दूरी।
अक्सर पूछे जाने वाले सवाल
95% के लिए 1.96 क्यों, 1.645 क्यों नहीं? एक सममित दोतरफा अंतराल बचे हुए 5% को 2.5% की दो पूँछों में बाँटता है, जिससे \(\Phi^{-1}(0.975) \approx 1.96\) मिलता है। 1.645 तो एकतरफा 95% क्वांटाइल है और दोतरफा रेंज के लिए सही नहीं है।
क्या मुझे इसके बजाय t-वितरण इस्तेमाल करना चाहिए? जब \(\sigma\) का अनुमान किसी छोटे सैंपल से लगाया गया हो, तो सैंपल आकार \(n\) वाला t-वितरण (अंतराल \(\mu \pm t\cdot s/\sqrt{n}\)) अधिक उपयुक्त होता है। यह टूल जानबूझकर \(\sigma\) को एक ज्ञात जनसंख्या मान मानता है और सामान्य \(z\) का उपयोग करता है, इसलिए इसमें \(n\) की ज़रूरत नहीं पड़ती।
अगर sd = 0 हो तो क्या होगा? तब अंतराल सिकुड़कर एक ही बिंदु \([\text{माध्य}, \text{माध्य}]\) रह जाता है।