這個計算器能做什麼
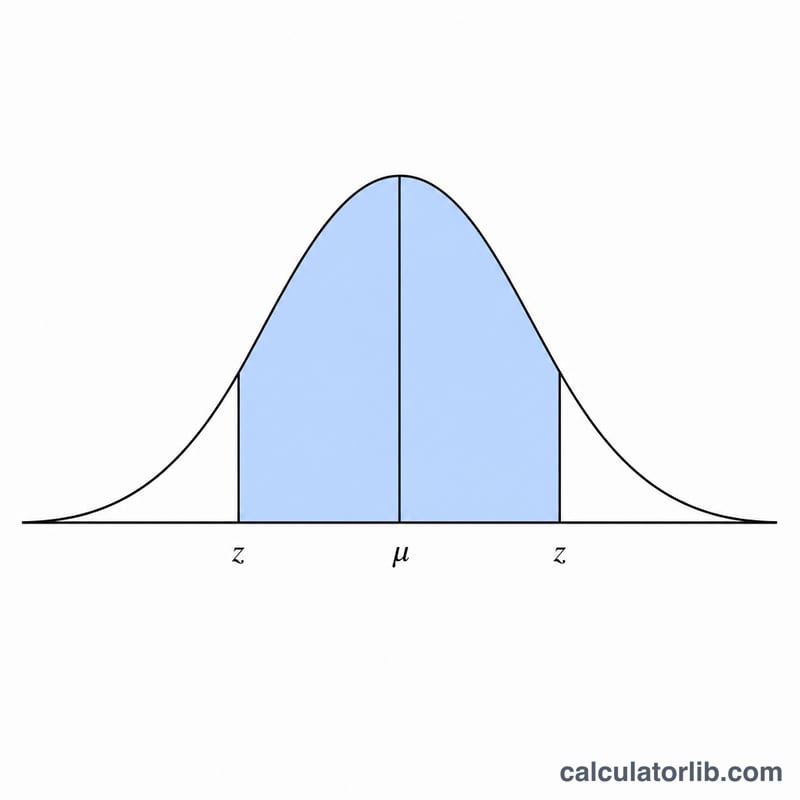
本工具會在已知樣本平均數(\(\mu\))與標準差(\(\sigma\))的情況下,估計「真值」可能落在的範圍。它假設該數值服從常態分布(normal distribution),並回傳對稱的雙尾區間 \(\mu \pm z\cdot\sigma\),其中 \(z\) 是你所選信賴水準對應的標準常態臨界值。平均數與標準差皆為一般數字,計算出的區間也會以你輸入的相同單位呈現。
使用方式
請輸入平均數、標準差(必須大於或等於 0),以及以百分比表示的信賴水準,範圍須符合 50 < 信賴水準 < 100(最常用的是 95)。計算器會先把百分比換算成機率 \(p\),求出臨界值 \(z = \Phi^{-1}\!\left(\frac{1+p}{2}\right)\),再回傳區間的下限與上限。當信賴水準為 100% 時區間會變成無限大,因此數值必須維持在 100 以下。
公式說明
令機率 \(p = \text{信賴水準}/100\),雙尾的 \(z\) 值即為標準常態分布在 \((1+p)/2\) 處的分位數。$$\text{CI} = \text{Mean }\mu \pm z \cdot \text{SD }\sigma$$ $$\text{where}\quad z = \Phi^{-1}\!\left(\frac{1 + \frac{\text{Confidence }\%}{100}}{2}\right)$$ 以 95% 為例,\(\Phi^{-1}(0.975) \approx 1.95996\),因此區間為 \(\mu \pm 1.96\sigma\)。幾個實用的對照點:68.26% 的覆蓋率相當於 \(\mu \pm 1\sigma\)、95.45% 相當於 \(\mu \pm 2\sigma\)、99.73% 則相當於 \(\mu \pm 3\sigma\)。反常態累積分布函數採用有理式(Acklam)近似法,再加上一次 Halley 修正步驟計算,因此完全不需要查表。
實例演算
假設平均數 = 100、標準差 = 5、信賴水準 = 99%:\(p = 0.99\),\(z = \Phi^{-1}(0.995) \approx 2.57583\)。$$\text{下限} = 100 - 2.57583\cdot 5 = 87.121$$ $$\text{上限} = 100 + 12.879 = 112.879$$ 結果即顯示為「介於 87.12 與 112.88 之間」。
常見信賴水準與 Z 值
雙尾臨界值為 \(z = \Phi^{-1}\left(\frac{1+p}{2}\right)\),其中 \(p\) 為以比例表示的信賴水準。下表列出各水準所用的累積機率 \((1+p)/2\),以及標準常態分布對應的 z 值。
| 信賴水準 | 尾部機率 (1+p)/2 | 雙尾 z |
|---|---|---|
| 50% | 0.75 | 0.6745 |
| 68.27% | 0.84135 | 1.0000 |
| 80% | 0.90 | 1.2816 |
| 90% | 0.95 | 1.6449 |
| 95% | 0.975 | 1.9600 |
| 95.45% | 0.97725 | 2.0000 |
| 98% | 0.99 | 2.3263 |
| 99% | 0.995 | 2.5758 |
| 99.73% | 0.99865 | 3.0000 |
| 99.9% | 0.9995 | 3.2905 |
68.27%、95.45% 和 99.73% 這三列分別對應常見的 1、2、3 個標準差法則。
區間的解讀
本計算機回傳 \(\text{平均值} \pm z \cdot \text{標準差}\)。在常態分布下,這是預期能涵蓋指定比例個別數值的範圍。例如,平均值為 100、標準差為 15、信賴水準為 95% 時,區間為 \(100 \pm 1.96 \times 15 = 100 \pm 29.4\),即 70.6 到 129.4。預期約 95% 的數值會落在此範圍內。
與平均值的信賴區間不同。母體平均值的信賴區間是以標準誤 \(\text{標準差}/\sqrt{n}\) 取代標準差。該區間窄得多,且會隨樣本數 \(n\) 增加而縮小。這裡的區間描述的是個別數值的分散程度,或單一測量值可能的範圍,並不描述平均值被掌握得多精確。
- 信賴水準提高,區間變寬。半寬等於 \(z \cdot \text{標準差}\),因此與 z 成正比增長。從 95%(z = 1.9600)提高到 99%(z = 2.5758),區間約寬 31%。
- 對稱性。區間以平均值為中心,上下距離相等。
- 假設條件。只有當資料近似服從常態分布,且平均值與標準差可靠(視為已知)時,結果才有效。若資料偏斜、尾部厚重、有離群值或樣本數小,實際涵蓋率可能與所述水準明顯不同。
關鍵術語
- 平均值 (μ)
- 平均數值,是分布與區間的中心。
- 標準差 (σ)
- 衡量數值圍繞平均值分散程度的指標,與資料使用相同單位。
- 信賴水準
- 區間預期涵蓋的數值比例(或機率),例如 95%。
- 臨界值 z
- 從平均值起算、需要多少個標準差才能涵蓋所選信賴水準的數字;若為 95%,則為 1.9600。
- 常態分布
- 對稱、呈鐘形的分布,完全由其平均值與標準差所決定。
- 反累積分布函數/分位數 (Φ⁻¹)
- 輸入累積機率、回傳使該機率位於其下方之 z 值的函數。例如 Φ⁻¹(0.975) = 1.9600。
- 雙尾區間與單尾區間
- 雙尾區間在兩端各留相等的尾部,因此尾部機率為 (1+p)/2。單尾界限則將所有被排除的機率放在同一側尾部,改用 Φ⁻¹(p)。
- 誤差範圍 (z·σ)
- 區間的半寬,即從平均值到任一端點的距離。
常見問題
為什麼 95% 用的是 1.96,而不是 1.645?對稱的雙尾區間會把剩下的 5% 平分成兩條各 2.5% 的尾端,因此取 \(\Phi^{-1}(0.975) \approx 1.96\)。而 1.645 是單尾 95% 的分位數,用在雙尾範圍上並不正確。
我是不是該改用 t 分布?當 \(\sigma\) 是由小樣本估計而來時,使用自由度與樣本數 \(n\) 相關的 t 分布(區間為 \(\text{平均數} \pm t\cdot s/\sqrt{n}\))會更恰當。本工具刻意將 \(\sigma\) 視為已知的母體參數,並採用常態分布的 \(z\) 值,因此不需要輸入 \(n\)。
如果標準差 = 0 呢?此時區間會收縮成單一一點 \([\text{平均數}, \text{平均數}]\)。