이 계산기는 무엇을 하나요
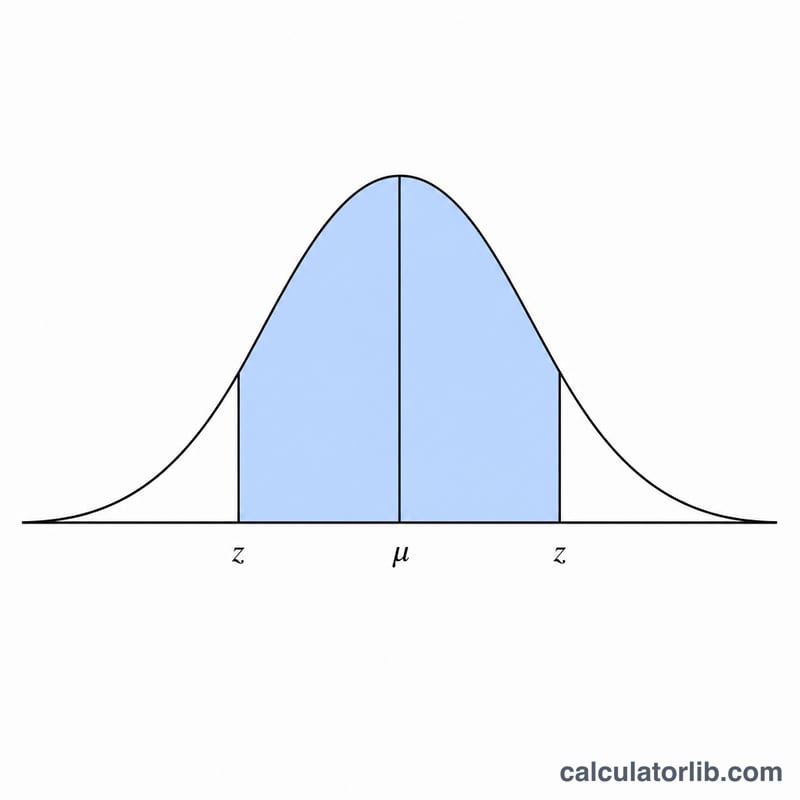
이 도구는 표본 평균(μ)과 표준편차(σ)를 바탕으로 '참값'이 위치할 가능성이 높은 범위를 추정합니다. 측정 대상이 정규분포를 따른다고 가정하며, 대칭형 양측 구간인 \(\mu \pm z \cdot \sigma\)를 계산해 줍니다. 여기서 \(z\)는 선택한 신뢰수준에 대응하는 표준정규분포 임곗값입니다. 평균과 표준편차는 단순한 숫자로 입력하면 되고, 결과 구간은 입력한 단위 그대로 표시됩니다.
사용 방법
평균, 표준편차(0 이상이어야 함), 그리고 신뢰수준을 백분율로 입력하세요. 신뢰수준은 50 < 신뢰수준 < 100 범위여야 하며 보통 95를 많이 씁니다. 계산기는 입력한 백분율을 확률 \(p\)로 변환한 뒤 임곗값 \(z = \Phi^{-1}\!\left(\frac{1+p}{2}\right)\)를 구하고, 하한과 상한을 돌려줍니다. 신뢰수준이 100%면 구간이 무한대로 발산하므로, 반드시 100 미만이어야 합니다.
공식 풀이
확률 \(p = \text{신뢰수준}/100\)일 때, 양측 \(z\) 값은 \((1+p)/2\) 지점의 표준정규분위수입니다. 95%의 경우 \(\Phi^{-1}(0.975) \approx 1.95996\)이므로 구간은 \(\mu \pm 1.96\sigma\)가 됩니다. 알아두면 편리한 기준점으로는 68.26% 포함 범위가 \(\mu \pm 1\sigma\), 95.45%가 \(\mu \pm 2\sigma\), 99.73%가 \(\mu \pm 3\sigma\)에 해당합니다. 역정규누적분포함수는 유리함수 기반의 Acklam 근사식에 Halley 보정 단계를 더해 계산하므로, 별도의 분포표(z 테이블)가 필요 없습니다.
계산 예시
평균 = 100, 표준편차 = 5, 신뢰수준 = 99%인 경우를 봅시다. \(p = 0.99\)이고 \(z = \Phi^{-1}(0.995) \approx 2.57583\)입니다.
$$\text{하한} = 100 - 2.57583 \cdot 5 = 87.121$$$$\text{상한} = 100 + 12.879 = 112.879$$결과는 "87.12에서 112.88 사이"로 표시됩니다.
일반적인 신뢰 수준과 Z 값
양측 임계값은 \(z = \Phi^{-1}\left(\frac{1+p}{2}\right)\)이며, 여기서 \(p\)는 비율로 표시한 신뢰 수준입니다. 표는 각 수준에 사용되는 누적 확률 \((1+p)/2\)와 표준 정규분포에서의 결과 z 값을 보여 줍니다.
| 신뢰 수준 | 꼬리 확률 (1+p)/2 | 양측 z |
|---|---|---|
| 50% | 0.75 | 0.6745 |
| 68.27% | 0.84135 | 1.0000 |
| 80% | 0.90 | 1.2816 |
| 90% | 0.95 | 1.6449 |
| 95% | 0.975 | 1.9600 |
| 95.45% | 0.97725 | 2.0000 |
| 98% | 0.99 | 2.3263 |
| 99% | 0.995 | 2.5758 |
| 99.73% | 0.99865 | 3.0000 |
| 99.9% | 0.9995 | 3.2905 |
68.27%, 95.45%, 99.73% 행은 익숙한 1, 2, 3 표준편차 규칙에 해당합니다.
구간 해석하기
이 계산기는 \(\text{평균} \pm z \cdot \text{SD}\)를 계산합니다. 정규분포에서 이 값은 개별 값들의 지정된 비율이 포함될 것으로 예상되는 범위입니다. 예를 들어 평균이 100이고 SD가 15이며 신뢰 수준이 95%인 경우, 구간은 \(100 \pm 1.96 \times 15 = 100 \pm 29.4\), 즉 70.6에서 129.4까지입니다. 값의 약 95%가 이 범위에 속할 것으로 예상됩니다.
평균에 대한 신뢰 구간과는 다릅니다. 모평균에 대한 신뢰 구간은 SD 대신 표준오차 \(\text{SD}/\sqrt{n}\)를 사용합니다. 그 구간은 훨씬 좁으며 표본 크기 \(n\)이 커질수록 줄어듭니다. 여기서의 구간은 개별 값의 퍼짐 정도, 즉 단일 측정값이 있을 법한 범위를 나타냅니다. 평균이 얼마나 정밀하게 알려졌는지는 나타내지 않습니다.
- 신뢰 수준을 높이면 구간이 넓어집니다. 반폭은 \(z \cdot \text{SD}\)와 같으므로 z에 비례하여 커집니다. 95%(z = 1.9600)에서 99%(z = 2.5758)로 올리면 구간이 약 31% 넓어집니다.
- 대칭성. 구간은 평균을 중심으로 하며, 위와 아래의 거리가 같습니다.
- 가정. 결과는 데이터가 대략 정규분포를 따르고 평균과 SD가 신뢰할 만한 경우(알려진 값으로 취급)에만 유효합니다. 데이터가 비대칭이거나 꼬리가 두껍거나 이상값이 있거나 표본이 작으면, 실제 포함 비율이 명시된 수준과 상당히 다를 수 있습니다.
주요 용어
- 평균 (μ)
- 분포와 구간의 중심이 되는 평균값입니다.
- 표준편차 (σ)
- 값들이 평균 주위에 얼마나 넓게 퍼져 있는지를 나타내며, 데이터와 같은 단위를 사용합니다.
- 신뢰 수준
- 구간이 포함하도록 의도된 값의 비율(또는 확률)이며, 예를 들어 95%입니다.
- 임계 z 값
- 선택한 신뢰 수준을 포함하는 데 필요한, 평균으로부터의 표준편차 개수이며, 95%의 경우 1.9600입니다.
- 정규분포
- 평균과 표준편차만으로 완전히 설명되는, 대칭이고 종 모양인 분포입니다.
- 역누적분포함수 / 분위수 (Φ⁻¹)
- 누적 확률을 입력받아, 그 확률이 놓이는 z 값을 반환하는 함수입니다. 예를 들어 Φ⁻¹(0.975) = 1.9600입니다.
- 양측 구간 대 단측 구간
- 양측 구간은 양 끝에 같은 크기의 꼬리를 남기며, 그래서 꼬리 확률이 (1+p)/2입니다. 단측 상한/하한은 제외되는 확률을 한쪽 꼬리에 모두 두며, 대신 Φ⁻¹(p)를 사용합니다.
- 오차 한계 (z·σ)
- 구간의 반폭으로, 평균에서 양 끝점 중 어느 한쪽까지의 거리입니다.
자주 묻는 질문
왜 95%에서 1.645가 아니라 1.96을 쓰나요? 대칭형 양측 구간은 남은 5%를 양쪽 꼬리에 2.5%씩 나눠 배분합니다. 따라서 \(\Phi^{-1}(0.975) \approx 1.96\)이 됩니다. 1.645는 단측(한쪽) 95% 분위수로, 양측 범위에는 적합하지 않습니다.
t 분포를 써야 하지 않나요? 작은 표본에서 \(\sigma\)를 추정해 사용할 때는 표본 크기 \(n\)을 반영한 t 분포(구간은 \(\text{평균} \pm t \cdot s/\sqrt{n}\))가 더 적절합니다. 이 도구는 의도적으로 \(\sigma\)를 알려진 모집단 값으로 보고 정규분포 \(z\)를 사용하므로 \(n\)이 필요하지 않습니다.
표준편차가 0이면 어떻게 되나요? 구간은 하나의 점 [평균, 평균]으로 수렴합니다.