십분위수란?
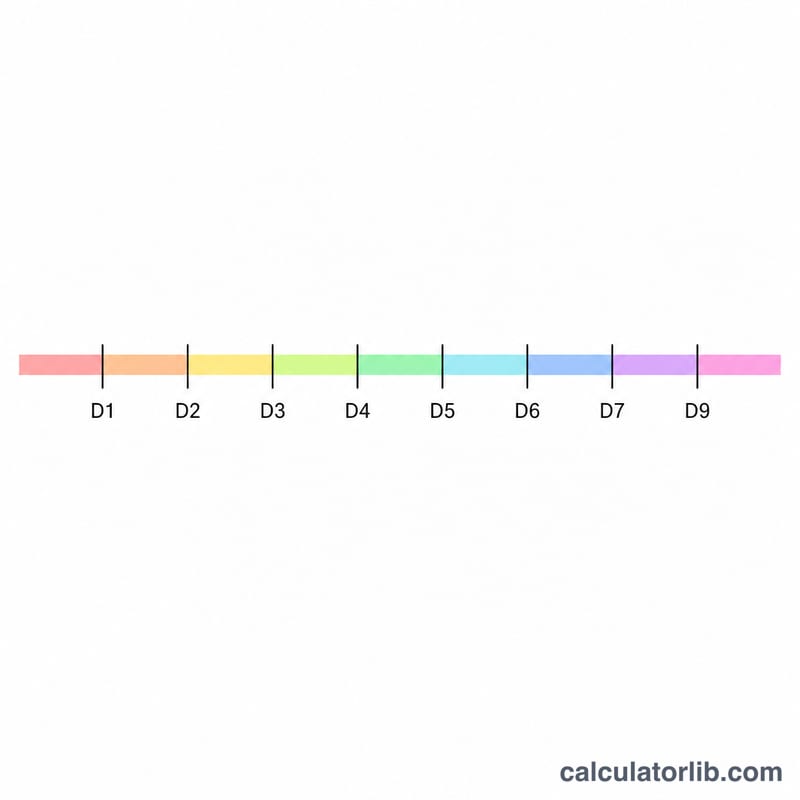
십분위수(decile)는 크기 순으로 정렬한 데이터를 10등분하는 값입니다. 모두 아홉 개가 있으며 D1부터 D9까지로 표기합니다. 첫 번째 십분위수(D1)는 전체 데이터의 하위 10%를 가르는 값이고, D5는 중앙값(50%), D9는 상위 10%(즉 90% 지점)를 나타냅니다. 십분위수는 통계학을 비롯해 교육 분야(시험 점수 구간 나누기), 경제학(소득 분포), 금융 등에서 특정 값이 전체 집단 안에서 어느 위치에 있는지를 보여줄 때 널리 쓰입니다.
계산기 사용 방법
숫자를 쉼표 또는 공백으로 구분해 입력한 뒤, 원하는 십분위수(k는 1부터 9까지)를 선택하세요. 계산기가 값을 자동으로 정렬하고 \(L = k(n+1)/10\) 공식으로 순위 위치를 구한 다음 십분위수 값을 돌려줍니다. 위치가 정수가 아닐 때는 인접한 두 데이터 사이를 보간(interpolation)하여 계산합니다.
공식 자세히 보기
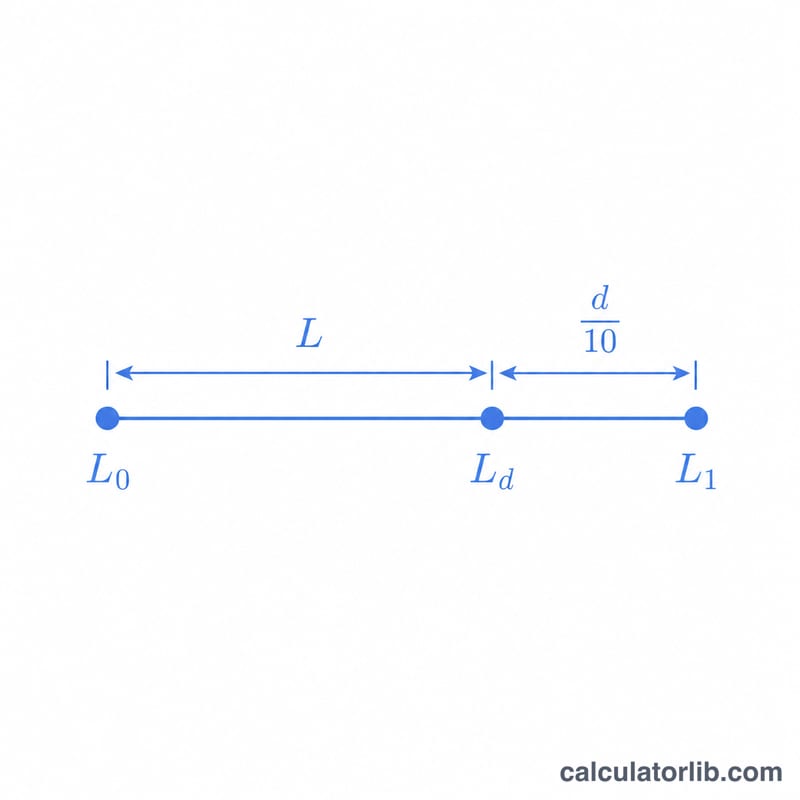
정렬된 \(n\)개의 값에서 k번째 십분위수의 위치는 \(L = k(n+1)/10\) 입니다. L이 정수이면 십분위수는 그 순위에 해당하는 값 그대로입니다. 만약 L이 두 순위 사이(예: 3.4)에 떨어지면, 십분위수는 3번째 값에서 4번째 값으로 가는 거리의 40% 지점에 위치합니다:
$$D = x_3 + 0.4(x_4 - x_3).$$위치가 1 이하이면 가장 작은 값을, \(n\) 이상이면 가장 큰 값을 사용합니다.
예제로 풀어보기
데이터 2, 4, 6, 8, 10, 12, 14, 16, 18, 20 (\(n = 10\))에서 D3을 구해 봅시다. 위치는 다음과 같습니다:
$$L = 3 \times (10 + 1) / 10 = 3.3.$$따라서 D3은 3번째 값(6)에서 4번째 값(8)으로 가는 거리의 30% 지점에 있습니다:
$$D_3 = 6 + 0.3 \times (8 - 6) = 6.6.$$더 많은 작업 예제
아래의 각 예제는 동일한 세 단계를 따릅니다: 데이터를 정렬하고, 순위 위치 \(P = \dfrac{k\,(n+1)}{10}\)를 계산한 다음, 정수 부분 \(L = \lfloor P \rfloor\)과 분수 부분 \(f = P - L\)로 나누고, \(L\)번째와 \((L+1)\)번째 정렬된 값 사이를 보간합니다.
예제 1 — 정수 순위 (n = 19, k = 5)
원본 입력: 2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32
정렬된 목록 (이미 오름차순), 순위 1–19:
2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32 → \(n = 19\)
순위 위치:
$$P = \frac{5\,(19+1)}{10} = \frac{5 \times 20}{10} = \frac{100}{10} = 10$$보간: \(L = \lfloor 10 \rfloor = 10\) 이고 \(f = 10 - 10 = 0\) 이므로, 분수 항이 사라집니다:
$$D_5 = x_{(10)} + 0 \times \bigl(x_{(11)} - x_{(10)}\bigr) = 16 + 0 \times (18 - 16) = 16$$최종 값: \(D_5 = \) 16. \(P\)가 정확히 정수 위치에 떨어졌으므로 보간이 필요하지 않았고, \(D_5\)는 단순히 10번째 정렬된 관찰값입니다 — \(n = 19\)의 경우 중앙값이기도 합니다.
예제 2 — 반복된 값이 있는 작은 정렬되지 않은 n (n = 7)
원본 입력: 12, 5, 9, 5, 20, 9, 14
정렬 단계: 5, 5, 9, 9, 12, 14, 20 → \(n = 7\), 따라서 순위는 1부터 7까지 실행되고 \(n + 1 = 8\)입니다. 반복된 5는 순위 1과 2를 차지하고, 반복된 9는 순위 3과 4를 차지합니다. 동일한 값들은 별도의 관찰값으로 유지됩니다 — 병합되지 않습니다.
D1:
$$P = \frac{1 \times 8}{10} = 0.8, \qquad L = \lfloor 0.8 \rfloor = 0, \qquad f = 0.8$$순위 0은 존재하지 않습니다 (가장 작은 값 아래에 \(x_{(0)}\)가 없습니다), 따라서 목표 위치가 데이터 범위를 벗어나고 결과는 최솟값으로 제한됩니다:
$$D_1 = x_{(1)} = 5$$D9:
$$P = \frac{9 \times 8}{10} = 7.2, \qquad L = \lfloor 7.2 \rfloor = 7, \qquad f = 0.2$$보간은 \(x_{(8)}\)이 필요하지만, 목록이 순위 7에서 끝나므로 결과는 최댓값으로 제한됩니다:
$$D_9 = x_{(7)} = 20$$같은 데이터에 대한 D5 는 목록 내에 깔끔하게 떨어집니다:
$$P = \frac{5 \times 8}{10} = 4, \qquad L = 4,\; f = 0 \quad\Rightarrow\quad D_5 = x_{(4)} = 9$$최종 값: \(D_1 = 5\), \(D_5 = \) 9, \(D_9 = 20\). 관찰값이 7개뿐이므로, \(D_1\) 과 \(D_9\) 는 가장 작은 값과 가장 큰 값으로 축소됩니다. \(k = 1\)일 때 \(P\)가 순위 1에 있거나 그 안에 떨어지려면 \(n \ge 9\)가 필요하고, \(k = 9\)일 때도 마찬가지로 \(n \ge 9\)가 필요합니다.
예제 3 — 25개의 시험 점수, D8 찾기
원본 입력 (기록된 순서의 점수):
72, 85, 58, 90, 66, 41, 78, 93, 62, 70, 99, 55, 80, 68, 48, 96, 74, 60, 82, 52, 91, 63, 76, 65, 71
정렬된 목록 (순위 1–25):
41, 48, 52, 55, 58, 60, 62, 63, 65, 66, 68, 70, 71, 72, 74, 76, 78, 80, 82, 85, 90, 91, 93, 96, 99 → \(n = 25\)
8번째 십분위의 순위 위치:
$$P = \frac{8\,(25+1)}{10} = \frac{8 \times 26}{10} = \frac{208}{10} = 20.8$$\(L = \lfloor 20.8 \rfloor = 20\) 이고 \(f = 20.8 - 20 = 0.8\) 입니다. 20번째 정렬된 점수는 \(x_{(20)} = 85\) 이고 21번째는 \(x_{(21)} = 90\) 입니다.
보간:
$$D_8 = x_{(20)} + 0.8\,\bigl(x_{(21)} - x_{(20)}\bigr) = 85 + 0.8\,(90 - 85) = 85 + 0.8 \times 5 = 85 + 4 = 89$$최종 값: \(D_8 = \) 89 점. 이 도구의 규칙에 따르면, 89 점은 기록된 25개 점수의 약 80%가 이 점수 이하에 떨어지는 컷오프를 표시합니다. 89는 관찰된 점수 중 하나가 아님을 주의하십시오 — 보간은 20번째와 21번째 관찰값 사이의 값을 생성하며, 이는 \(f \neq 0\) 인 경우 정상이고 예상됩니다.
십분위, 백분위 및 사분위 동등값
십분위, 백분위 및 분위 분수는 동일한 컷포인트의 세 가지 표기법입니다: \(D_k\)는 \(10k\)번째 백분위, 즉 분수 \(k/10\)의 분위입니다. 마지막 열은 표본 \(n = 20\)(\(n + 1 = 21\))에 대해 이 도구의 순위 공식 \(L = \dfrac{k(n+1)}{10}\)을 계산하여 정렬된 목록의 구체적인 위치를 보여줍니다.
| 십분위 | 동등 백분위 | 분위 분수 | 사분위 동등값 | 순위 \(P = k(n+1)/10\) (n = 20일 때) | 보간이 필요한가? |
|---|---|---|---|---|---|
| D1 | 10번째 백분위 | 0.1 | — | \(1 \times 21/10 = 2.1\) | 예: \(x_{(2)} + 0.1\,(x_{(3)} - x_{(2)})\) |
| D2 | 20번째 백분위 | 0.2 | — | \(2 \times 21/10 = 4.2\) | 예: \(x_{(4)} + 0.2\,(x_{(5)} - x_{(4)})\) |
| D3 | 30번째 백분위 | 0.3 | — | \(3 \times 21/10 = 6.3\) | 예: \(x_{(6)} + 0.3\,(x_{(7)} - x_{(6)})\) |
| D4 | 40번째 백분위 | 0.4 | — | \(4 \times 21/10 = 8.4\) | 예: \(x_{(8)} + 0.4\,(x_{(9)} - x_{(8)})\) |
| D5 | 50번째 백분위 | 0.5 | \(Q_2\) = 중앙값 (정확함, 모든 \(n\)에 대해) | \(5 \times 21/10 = 10.5\) | 예: \(x_{(10)} + 0.5\,(x_{(11)} - x_{(10)})\) — 보통의 짝수-\(n\) 중앙값 |
| D6 | 60번째 백분위 | 0.6 | — | \(6 \times 21/10 = 12.6\) | 예: \(x_{(12)} + 0.6\,(x_{(13)} - x_{(12)})\) |
| D7 | 70번째 백분위 | 0.7 | — | \(7 \times 21/10 = 14.7\) | 예: \(x_{(14)} + 0.7\,(x_{(15)} - x_{(14)})\) |
| D8 | 80번째 백분위 | 0.8 | — | \(8 \times 21/10 = 16.8\) | 예: \(x_{(16)} + 0.8\,(x_{(17)} - x_{(16)})\) |
| D9 | 90번째 백분위 | 0.9 | — | \(9 \times 21/10 = 18.9\) | 예: \(x_{(18)} + 0.9\,(x_{(19)} - x_{(18)})\) |
사분위에 대한 참고: 두 시스템 간에 공유되는 것은 중간 컷포인트뿐입니다 — \(D_5 = P_{50} = Q_2\) = 중앙값. 십분위 중 \(Q_1\) 또는 \(Q_3\)과 일치하는 것은 없습니다. 첫 번째 사분위는 25번째 백분위에 위치하며, 이는 "\(D_{2.5}\)"일 것입니다. 세 번째 사분위는 75번째 백분위에 위치하며, 즉 "\(D_{7.5}\)"입니다 — 그리고 \(k = 2.5\) 및 \(k = 7.5\)는 십분위가 아닙니다. \(k\)는 1부터 9까지의 정수 값만 가지기 때문입니다. 따라서 \(Q_1\)은 \(D_2\)와 \(D_3\) 사이에 떨어지고, \(Q_3\)은 \(D_7\)과 \(D_8\) 사이에 떨어집니다. 같은 \((n+1)\) 규칙으로 \(Q_1\) 또는 \(Q_3\)을 얻으려면 대신 순위 \(P = \dfrac{j(n+1)}{4}\)를 \(j = 1, 3\)에 대해 사용하십시오.
경계에 대한 참고: \(k = 0\) 및 \(k = 10\)도 십분위가 아닙니다 — 이들은 0번째 및 100번째 백분위, 즉 데이터 세트의 최솟값과 최댓값에 해당합니다. 9개의 십분위는 10개의 간격을 만들므로, \(n\)개의 관찰값으로 각 십분위 간 간격에는 약 \(n/10\)개가 포함됩니다.
자주 묻는 질문
십분위수와 백분위수는 어떻게 다른가요? 십분위수는 데이터를 10등분하고, 백분위수는 100등분합니다. \(D_k\)는 \((10k)\)번째 백분위수와 같으므로, D3은 곧 30번째 백분위수입니다.
내 데이터에 없는 소수값이 나오는 이유는 무엇인가요? 계산된 순위 위치가 정수가 아니면 계산기가 가장 가까운 두 값 사이를 보간하기 때문에, 원래 입력 목록에 없던 숫자가 결과로 나올 수 있습니다.
입력 순서가 결과에 영향을 주나요? 아니요. 계산기가 데이터를 알아서 정렬하므로 어떤 순서로 붙여 넣어도 괜찮습니다.