Что такое дециль?
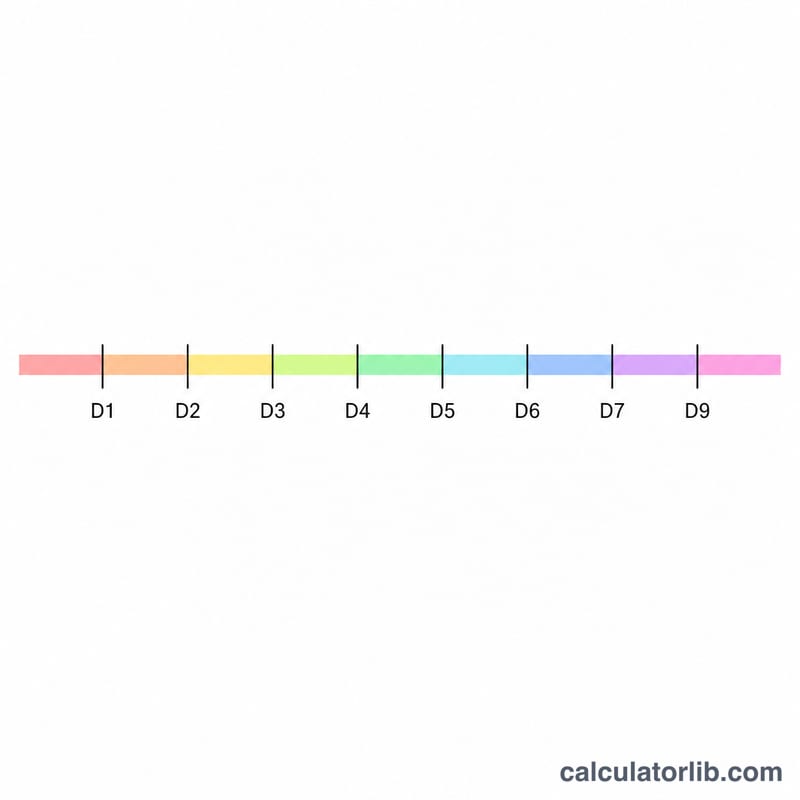
Децили делят упорядоченный набор данных на десять равных частей. Всего децилей девять — от D1 до D9. Первый дециль (D1) — это значение, ниже которого находится 10% данных; D5 совпадает с медианой (50%), а D9 отмечает уровень 90%. Децили широко применяются в статистике, образовании (распределение тестовых баллов по группам), экономике (распределение доходов) и финансах, чтобы показать, какое место занимает то или иное значение внутри всей совокупности.
Как пользоваться калькулятором
Введите числа через запятую или пробел, а затем выберите нужный дециль (k от 1 до 9). Калькулятор отсортирует значения, рассчитает позицию по формуле \(L = \frac{k(n+1)}{10}\) и выдаст значение дециля — при этом, если позиция не целая, он интерполирует результат между двумя соседними точками данных.
Разбор формулы
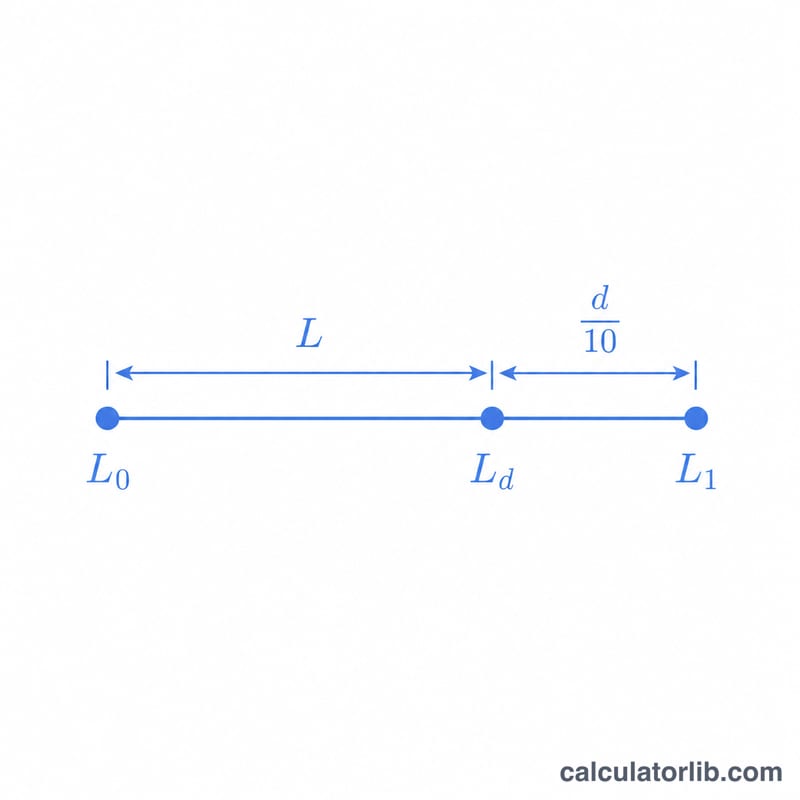
Для n отсортированных значений позиция k-го дециля равна \(L = \frac{k(n+1)}{10}\). Если L — целое число, дециль просто равен значению на этой позиции. Если L попадает между рангами (например, 3,4), дециль располагается на 40% пути от 3-го значения к 4-му:
$$D = x_3 + 0{,}4 \cdot (x_4 - x_3)$$Если позиция меньше либо равна 1, берётся наименьшее значение; если позиция больше либо равна n — наибольшее.
Пример расчёта
Возьмём данные 2, 4, 6, 8, 10, 12, 14, 16, 18, 20 (n = 10) и найдём D3. Позиция равна
$$L = \frac{3 \times (10 + 1)}{10} = 3{,}3$$Значит, D3 находится на 30% пути от 3-го значения (6) к 4-му (8):
$$D_3 = 6 + 0{,}3 \times (8 - 6) = 6{,}6$$Частые вопросы
Чем дециль отличается от процентиля? Децили делят данные на 10 частей, а процентили — на 100. Dk соответствует (10k)-му процентилю, поэтому D3 — это 30-й процентиль.
Почему в ответе появляется дробное число, которого нет в моих данных? Когда рассчитанная позиция не является целым числом, калькулятор интерполирует значение между двумя ближайшими точками, поэтому результат может не совпадать ни с одним числом из исходного списка.
Важен ли порядок ввода чисел? Нет — калькулятор сам сортирует данные, так что числа можно вводить в любом порядке.
Дополнительные примеры
Каждый пример ниже следует одним и тем же трём шагам: отсортировать данные, вычислить позицию ранга \(P = \dfrac{k\,(n+1)}{10}\), затем разделить её на целую часть \(L = \lfloor P \rfloor\) и дробь \(f = P - L\) и интерполировать между \(L\)-м и \((L+1)\)-м отсортированными значениями.
Пример 1 — целочисленный ранг (n = 19, k = 5)
Исходные данные: 2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32
Отсортированный список (уже в возрастающем порядке), с рангами 1–19:
2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32 → \(n = 19\)
Позиция ранга:
$$P = \frac{5\,(19+1)}{10} = \frac{5 \times 20}{10} = \frac{100}{10} = 10$$Интерполяция: \(L = \lfloor 10 \rfloor = 10\) и \(f = 10 - 10 = 0\), так что дробный член обнуляется:
$$D_5 = x_{(10)} + 0 \times \bigl(x_{(11)} - x_{(10)}\bigr) = 16 + 0 \times (18 - 16) = 16$$Итоговое значение: \(D_5 = \) 16. Поскольку \(P\) точно попала на целое число, интерполяция не потребовалась, и \(D_5\) — просто 10-е отсортированное наблюдение — которое при \(n = 19\) является также медианой.
Пример 2 — малое неотсортированное n с повторяющимися значениями (n = 7)
Исходные данные: 12, 5, 9, 5, 20, 9, 14
Шаг сортировки: 5, 5, 9, 9, 12, 14, 20 → \(n = 7\), так что ранги идут от 1 до 7 и \(n + 1 = 8\). Повторяющиеся 5 занимают ранги 1 и 2; повторяющиеся 9 занимают ранги 3 и 4. Совпадения сохраняются как отдельные наблюдения — они не объединяются.
D1:
$$P = \frac{1 \times 8}{10} = 0.8, \qquad L = \lfloor 0.8 \rfloor = 0, \qquad f = 0.8$$Ранг 0 не существует (нет \(x_{(0)}\) ниже наименьшего значения), поэтому целевая позиция находится вне данных и результат ограничен минимумом:
$$D_1 = x_{(1)} = 5$$D9:
$$P = \frac{9 \times 8}{10} = 7.2, \qquad L = \lfloor 7.2 \rfloor = 7, \qquad f = 0.2$$Интерполяция потребовала бы \(x_{(8)}\), но список заканчивается на ранге 7, поэтому результат ограничен максимумом:
$$D_9 = x_{(7)} = 20$$D5 для того же набора данных точно попадает внутрь списка:
$$P = \frac{5 \times 8}{10} = 4, \qquad L = 4,\; f = 0 \quad\Rightarrow\quad D_5 = x_{(4)} = 9$$Итоговые значения: \(D_1 = 5\), \(D_5 = \) 9, \(D_9 = 20\). Всего с 7 наблюдениями \(D_1\) и \(D_9\) свёртываются в наименьшее и наибольшее значения; набору данных требуется \(n \ge 9\), чтобы \(P\) падала на ранг 1 или внутрь него при \(k = 1\), и \(n \ge 9\) аналогично для \(k = 9\).
Пример 3 — 25 результатов экзамена, найти D8
Исходные данные (баллы в порядке их записи):
72, 85, 58, 90, 66, 41, 78, 93, 62, 70, 99, 55, 80, 68, 48, 96, 74, 60, 82, 52, 91, 63, 76, 65, 71
Отсортированный список (ранги 1–25):
41, 48, 52, 55, 58, 60, 62, 63, 65, 66, 68, 70, 71, 72, 74, 76, 78, 80, 82, 85, 90, 91, 93, 96, 99 → \(n = 25\)
Позиция ранга для 8-го дециля:
$$P = \frac{8\,(25+1)}{10} = \frac{8 \times 26}{10} = \frac{208}{10} = 20.8$$Таким образом, \(L = \lfloor 20.8 \rfloor = 20\) и \(f = 20.8 - 20 = 0.8\). 20-й отсортированный балл — это \(x_{(20)} = 85\), а 21-й — \(x_{(21)} = 90\).
Интерполяция:
$$D_8 = x_{(20)} + 0.8\,\bigl(x_{(21)} - x_{(20)}\bigr) = 85 + 0.8\,(90 - 85) = 85 + 0.8 \times 5 = 85 + 4 = 89$$Итоговое значение: \(D_8 = \) 89 баллов. В соответствии с конвенцией этого инструмента, балл 89 отмечает точку отсечения, при которой примерно 80% из 25 записанных баллов попадают на него или ниже. Обратите внимание, что 89 — не один из наблюдаемых баллов — интерполяция даёт значение между 20-м и 21-м наблюдениями, что нормально и ожидаемо всякий раз, когда \(f \neq 0\).
Эквиваленты дециля, процентиля и квартиля
Децили, процентили и доли квантилей — три обозначения одних и тех же точек отсечения: \(D_k\) — это \(10k\)-й процентиль, то есть квантиль с долей \(k/10\). Последний столбец вычисляет формулу ранга этого инструмента \(L = \dfrac{k(n+1)}{10}\) для выборки \(n = 20\) (таким образом, \(n + 1 = 21\)), чтобы показать конкретную позицию в отсортированном списке.
| Дециль | Эквивалентный процентиль | Доля квантиля | Эквивалент квартиля | Ранг \(P = k(n+1)/10\) для \(n = 20\) | Требуется ли интерполяция? |
|---|---|---|---|---|---|
| D1 | 10-й процентиль | 0.1 | — | \(1 \times 21/10 = 2.1\) | Да: \(x_{(2)} + 0.1\,(x_{(3)} - x_{(2)})\) |
| D2 | 20-й процентиль | 0.2 | — | \(2 \times 21/10 = 4.2\) | Да: \(x_{(4)} + 0.2\,(x_{(5)} - x_{(4)})\) |
| D3 | 30-й процентиль | 0.3 | — | \(3 \times 21/10 = 6.3\) | Да: \(x_{(6)} + 0.3\,(x_{(7)} - x_{(6)})\) |
| D4 | 40-й процентиль | 0.4 | — | \(4 \times 21/10 = 8.4\) | Да: \(x_{(8)} + 0.4\,(x_{(9)} - x_{(8)})\) |
| D5 | 50-й процентиль | 0.5 | \(Q_2\) = медиана (точная, для любого \(n\)) | \(5 \times 21/10 = 10.5\) | Да: \(x_{(10)} + 0.5\,(x_{(11)} - x_{(10)})\) — обычная медиана для чётного \(n\) |
| D6 | 60-й процентиль | 0.6 | — | \(6 \times 21/10 = 12.6\) | Да: \(x_{(12)} + 0.6\,(x_{(13)} - x_{(12)})\) |
| D7 | 70-й процентиль | 0.7 | — | \(7 \times 21/10 = 14.7\) | Да: \(x_{(14)} + 0.7\,(x_{(15)} - x_{(14)})\) |
| D8 | 80-й процентиль | 0.8 | — | \(8 \times 21/10 = 16.8\) | Да: \(x_{(16)} + 0.8\,(x_{(17)} - x_{(16)})\) |
| D9 | 90-й процентиль | 0.9 | — | \(9 \times 21/10 = 18.9\) | Да: \(x_{(18)} + 0.9\,(x_{(19)} - x_{(18)})\) |
Примечание о квартилях: только средняя точка отсечения делится между двумя системами — \(D_5 = P_{50} = Q_2\) = медиана. Ни один дециль не совпадает с \(Q_1\) или \(Q_3\). Первый квартиль находится на 25-м процентиле, что было бы "\(D_{2.5}\)", а третий квартиль на 75-м процентиле, то есть "\(D_{7.5}\)" — и \(k = 2.5\) и \(k = 7.5\) — не децили, поскольку \(k\) принимает только целые значения от 1 до 9. \(Q_1\) поэтому находится между \(D_2\) и \(D_3\), а \(Q_3\) — между \(D_7\) и \(D_8\). Чтобы получить \(Q_1\) или \(Q_3\) с той же конвенцией \((n+1)\), используйте ранг \(P = \dfrac{j(n+1)}{4}\) для \(j = 1, 3\) вместо этого.
Примечание о границах: \(k = 0\) и \(k = 10\) — также не децили — они соответствовали бы 0-му и 100-му процентилям, то есть минимуму и максимуму набора данных. Девять децилей создают десять интервалов, поэтому с \(n\) наблюдениями каждый интердецильный интервал содержит примерно \(n/10\) из них.