十分位数とは?
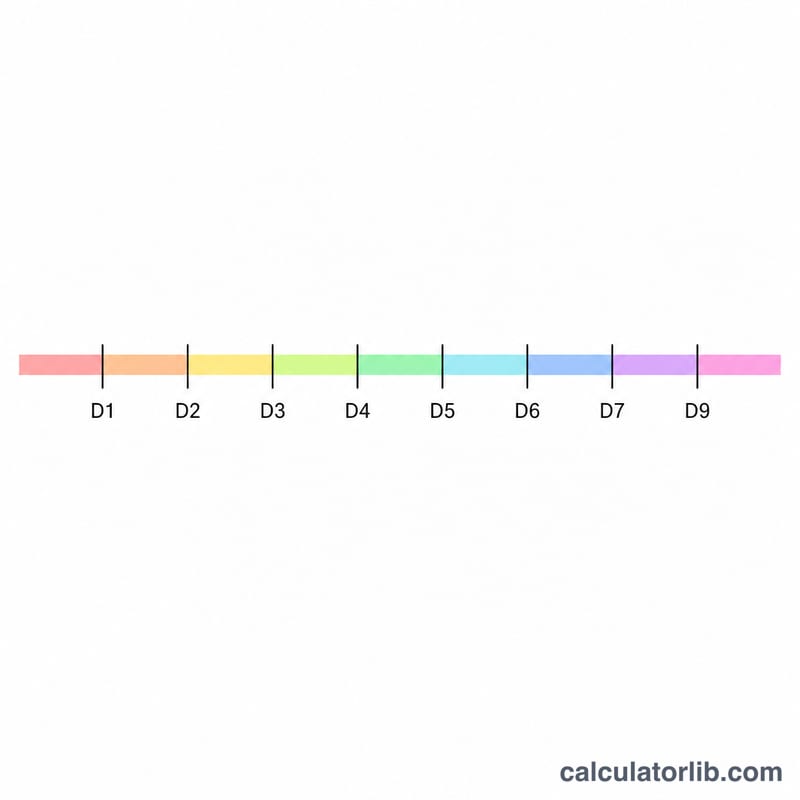
十分位数(デシル)とは、並べ替えたデータを10等分する区切りの値です。区切りは全部で9つあり、D1からD9まで番号が付けられています。第1十分位数(D1)は、それを下回るデータが全体の10%となる値、D5は中央値(50%)、D9は90%地点を示します。十分位数は統計学をはじめ、教育(テストの成績帯の区分)、経済(所得分布)、金融など幅広い分野で、ある値が集団の中でどの位置にあるかを表すために使われています。
このツールの使い方
数値をカンマまたはスペースで区切って入力し、求めたい十分位数(kは1〜9)を選びます。ツールが値を自動で並べ替え、公式\(L = k(n+1)/10\)で順位の位置を計算し、十分位数の値を返します。位置が整数にならない場合は、隣り合う2つのデータ点の間を線形補間して求めます。
計算式の解説
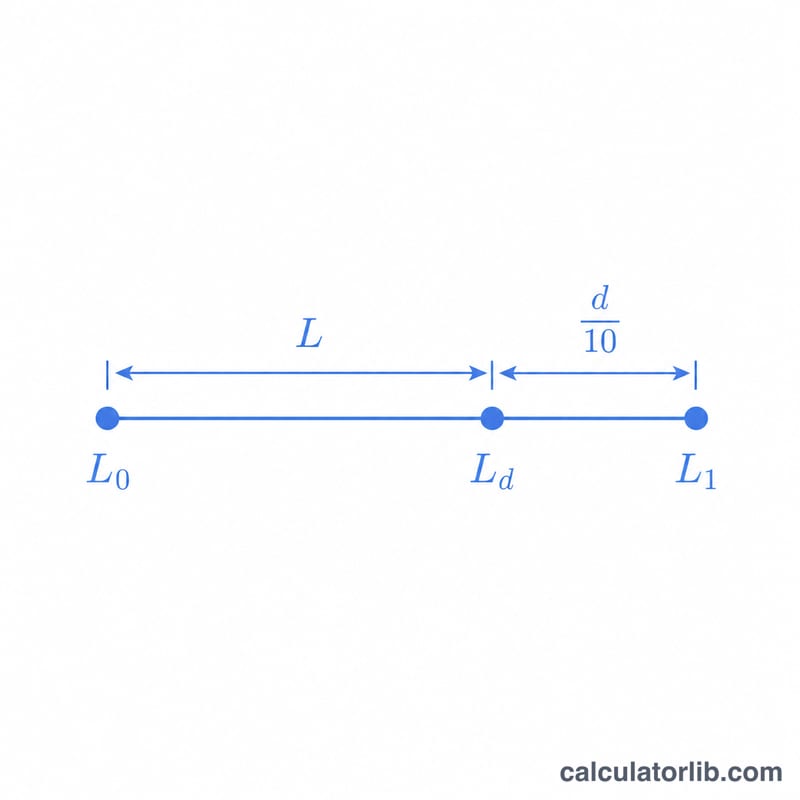
並べ替えたn個の値に対して、第k十分位数の位置は\(L = k(n+1)/10\)で求めます。Lが整数なら、その順位にある値がそのまま十分位数になります。Lが順位の途中(たとえば3.4)に来る場合は、3番目の値から4番目の値に向かって40%進んだ位置に十分位数があると考えます:$$D = x_3 + 0.4\,(x_4 - x_3)$$位置が1以下なら最小値を、n以上なら最大値を用います。
計算例
データ 2, 4, 6, 8, 10, 12, 14, 16, 18, 20(n = 10)でD3を求めてみましょう。位置は$$L = 3 \times \frac{10 + 1}{10} = 3.3$$です。つまりD3は、3番目の値(6)から4番目の値(8)に向かって30%進んだ位置にあります:$$D_3 = 6 + 0.3 \times (8 - 6) = 6.6$$となります。
より多くの実施例
以下の各例は同じ3つのステップに従います:データをソートし、ランク位置 \(P = \dfrac{k\,(n+1)}{10}\) を計算し、整数部 \(L = \lfloor P \rfloor\) と小数部 \(f = P - L\) に分割し、\(L\) 番目と \((L+1)\) 番目のソート値の間で補間します。
例1 — 整数ランク (n = 19, k = 5)
生入力: 2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32
ソート済みリスト(既に昇順)、ランク1~19:
2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32 → \(n = 19\)
ランク位置:
$$P = \frac{5\,(19+1)}{10} = \frac{5 \times 20}{10} = \frac{100}{10} = 10$$補間: \(L = \lfloor 10 \rfloor = 10\) かつ \(f = 10 - 10 = 0\) なので、小数項は消えます:
$$D_5 = x_{(10)} + 0 \times \bigl(x_{(11)} - x_{(10)}\bigr) = 16 + 0 \times (18 - 16) = 16$$最終値: \(D_5 = \) 16。\(P\) がちょうど整数に着地したため、補間は不要で、\(D_5\) は単に10番目のソート観測値です — \(n = 19\) の場合、これは中央値でもあります。
例2 — 繰り返される値を持つ小さい未ソート n (n = 7)
生入力: 12, 5, 9, 5, 20, 9, 14
ソートステップ: 5, 5, 9, 9, 12, 14, 20 → \(n = 7\) なので、ランクは1~7で、n + 1 = 8 です。繰り返される5はランク1と2を占めます。繰り返される9はランク3と4を占めます。同順位は個別の観測値として保持されます — マージされません。
D1:
$$P = \frac{1 \times 8}{10} = 0.8, \qquad L = \lfloor 0.8 \rfloor = 0, \qquad f = 0.8$$ランク0は存在しません(最小値より下に \(x_{(0)}\) はありません)ので、ターゲット位置はデータの外側にあり、結果は最小値にクリップされます:
$$D_1 = x_{(1)} = 5$$D9:
$$P = \frac{9 \times 8}{10} = 7.2, \qquad L = \lfloor 7.2 \rfloor = 7, \qquad f = 0.2$$補間には \(x_{(8)}\) が必要ですが、リストはランク7で停止するため、結果は最大値にクリップされます:
$$D_9 = x_{(7)} = 20$$同じデータの D5 はリストの内部にきちんと着地します:
$$P = \frac{5 \times 8}{10} = 4, \qquad L = 4,\; f = 0 \quad\Rightarrow\quad D_5 = x_{(4)} = 9$$最終値: \(D_1 = 5\)、\(D_5 = \) 9、\(D_9 = 20\)。観測値が7つだけの場合、\(D_1\) と \(D_9\) は最小値と最大値に崩壊します。データセットが \(k = 1\) でランク1以下に \(P\) が落ちるには \(n \ge 9\) が必要であり、\(k = 9\) でも同様に \(n \ge 9\) が必要です。
例3 — 25個の試験スコア、D8を求める
生入力(記録された順序でのスコア):
72, 85, 58, 90, 66, 41, 78, 93, 62, 70, 99, 55, 80, 68, 48, 96, 74, 60, 82, 52, 91, 63, 76, 65, 71
ソート済みリスト(ランク1~25):
41, 48, 52, 55, 58, 60, 62, 63, 65, 66, 68, 70, 71, 72, 74, 76, 78, 80, 82, 85, 90, 91, 93, 96, 99 → \(n = 25\)
8番目の十分位数のランク位置:
$$P = \frac{8\,(25+1)}{10} = \frac{8 \times 26}{10} = \frac{208}{10} = 20.8$$\(L = \lfloor 20.8 \rfloor = 20\) かつ \(f = 20.8 - 20 = 0.8\) です。20番目のソートスコアは \(x_{(20)} = 85\) で、21番目は \(x_{(21)} = 90\) です。
補間:
$$D_8 = x_{(20)} + 0.8\,\bigl(x_{(21)} - x_{(20)}\bigr) = 85 + 0.8\,(90 - 85) = 85 + 0.8 \times 5 = 85 + 4 = 89$$最終値: \(D_8 = \) 89点。このツールの慣例では、スコア89は、記録された25個のスコアの約80%がそれ以下である場合のカットオフを表します。89は観測されたスコアの1つではないことに注意してください — 補間は20番目と21番目の観測値の間の値を生成し、これは \(f \neq 0\) の場合は常に通常で予想されます。
十分位数、パーセンタイル、四分位数の同等値
十分位数、パーセンタイル、分位数分数は同じカットポイントを表す3つの記法です:\(D_k\) は \(10k\) パーセンタイル、つまり分数 \(k/10\) での分位数です。最後の列は、このツールのランク公式 \(L = \dfrac{k(n+1)}{10}\) を \(n = 20\) のサンプル(つまり \(n + 1 = 21\))で評価して、ソート済みリストの具体的な位置を示します。
| 十分位数 | 同等のパーセンタイル | 分位数分数 | 四分位数同等値 | ランク \(P = k(n+1)/10\)(\(n = 20\) の場合) | 補間が必要か? |
|---|---|---|---|---|---|
| D1 | 10パーセンタイル | 0.1 | — | \(1 \times 21/10 = 2.1\) | はい:\(x_{(2)} + 0.1\,(x_{(3)} - x_{(2)})\) |
| D2 | 20パーセンタイル | 0.2 | — | \(2 \times 21/10 = 4.2\) | はい:\(x_{(4)} + 0.2\,(x_{(5)} - x_{(4)})\) |
| D3 | 30パーセンタイル | 0.3 | — | \(3 \times 21/10 = 6.3\) | はい:\(x_{(6)} + 0.3\,(x_{(7)} - x_{(6)})\) |
| D4 | 40パーセンタイル | 0.4 | — | \(4 \times 21/10 = 8.4\) | はい:\(x_{(8)} + 0.4\,(x_{(9)} - x_{(8)})\) |
| D5 | 50パーセンタイル | 0.5 | \(Q_2\) = 中央値(任意の \(n\) に対して正確) | \(5 \times 21/10 = 10.5\) | はい:\(x_{(10)} + 0.5\,(x_{(11)} - x_{(10)})\) — 通常の偶数 \(n\) 中央値 |
| D6 | 60パーセンタイル | 0.6 | — | \(6 \times 21/10 = 12.6\) | はい:\(x_{(12)} + 0.6\,(x_{(13)} - x_{(12)})\) |
| D7 | 70パーセンタイル | 0.7 | — | \(7 \times 21/10 = 14.7\) | はい:\(x_{(14)} + 0.7\,(x_{(15)} - x_{(14)})\) |
| D8 | 80パーセンタイル | 0.8 | — | \(8 \times 21/10 = 16.8\) | はい:\(x_{(16)} + 0.8\,(x_{(17)} - x_{(16)})\) |
| D9 | 90パーセンタイル | 0.9 | — | \(9 \times 21/10 = 18.9\) | はい:\(x_{(18)} + 0.9\,(x_{(19)} - x_{(18)})\) |
四分位数に関する注: 2つのシステム間で共有されるのは中央のカットポイントだけです — \(D_5 = P_{50} = Q_2\) = 中央値。十分位数は \(Q_1\) または \(Q_3\) と一致しません。 第1四分位数は25パーセンタイルにあり、これは「\(D_{2.5}\)」となり、第3四分位数は75パーセンタイル、つまり「\(D_{7.5}\)」にあります — そして \(k = 2.5\) と \(k = 7.5\) は十分位数ではありません。\(k\) が1から9の整数値のみを取るからです。したがって、\(Q_1\) は \(D_2\) と \(D_3\) の間に落ち、\(Q_3\) は \(D_7\) と \(D_8\) の間に落ちます。同じ \((n+1)\) 慣例で \(Q_1\) または \(Q_3\) を取得するには、代わりに \(j = 1, 3\) に対してランク \(P = \dfrac{j(n+1)}{4}\) を使用します。
境界に関する注: \(k = 0\) と \(k = 10\) も十分位数ではありません — それらは0パーセンタイルと100パーセンタイル、つまりデータセットの最小値と最大値に対応します。9つの十分位数は10個の区間を作成するため、\(n\) 個の観測値で各十分位数区間は約 \(n/10\) を含みます。
よくある質問
十分位数とパーセンタイルの違いは? 十分位数はデータを10分割し、パーセンタイルは100分割します。Dkは第(10k)パーセンタイルに相当するため、D3は第30パーセンタイルと同じです。
入力していない小数が結果に出るのはなぜ? 計算した順位の位置が整数にならない場合、ツールが最も近い2つの値の間を補間します。そのため、元のリストに含まれていない数値が結果として出ることがあります。
入力する順番は関係ありますか? いいえ。ツールが自動でデータを並べ替えるので、どんな順番で貼り付けても問題ありません。