डेसाइल क्या होता है?
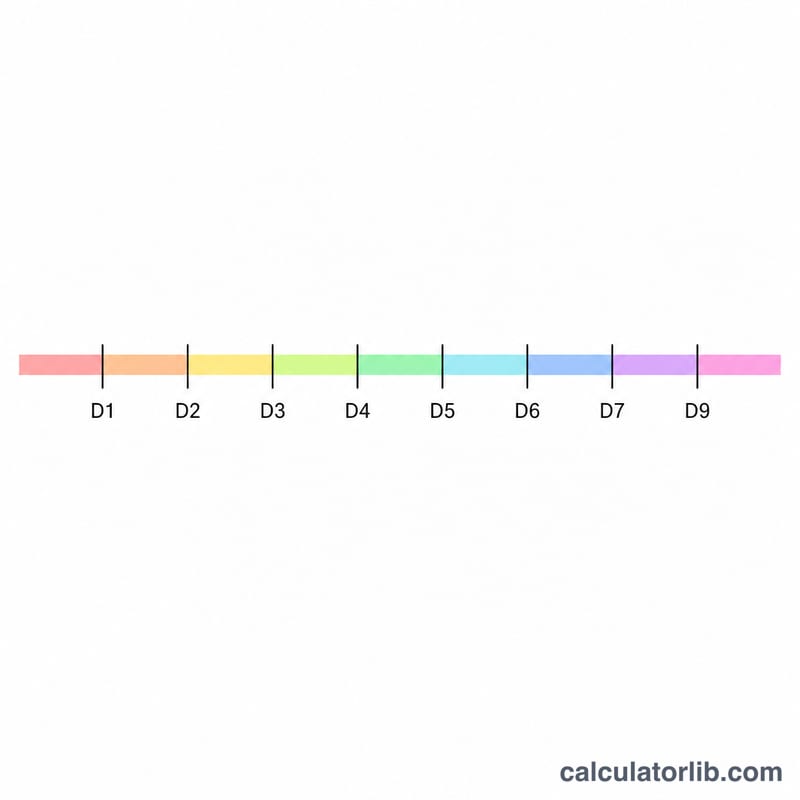
डेसाइल किसी क्रमबद्ध डेटा सेट को दस बराबर हिस्सों में बाँट देते हैं। कुल नौ डेसाइल होते हैं, जिन्हें D1 से लेकर D9 तक नाम दिया जाता है। पहला डेसाइल (D1) वह मान होता है जिसके नीचे डेटा का 10% हिस्सा आता है, D5 माध्यिका (मीडियन यानी 50%) है, और D9 90% बिंदु को दर्शाता है। डेसाइल का इस्तेमाल आँकड़ों, शिक्षा (परीक्षा-अंकों की श्रेणी बनाने), अर्थशास्त्र (आय वितरण) और वित्त में खूब किया जाता है, ताकि यह बताया जा सके कि किसी समूह में कोई मान कहाँ ठहरता है।
इस कैलकुलेटर का उपयोग कैसे करें
अपनी संख्याएँ कॉमा या स्पेस से अलग करके लिखें, फिर चुनें कि आपको कौन-सा डेसाइल चाहिए (k का मान 1 से 9 तक)। कैलकुलेटर इन मानों को क्रम में लगाता है, \(L = k(n+1)/10\) सूत्र से रैंक स्थिति निकालता है, और डेसाइल का मान लौटाता है — जब स्थिति पूर्ण संख्या नहीं होती, तब यह दो डेटा बिंदुओं के बीच इंटरपोलेशन कर देता है।
सूत्र की व्याख्या
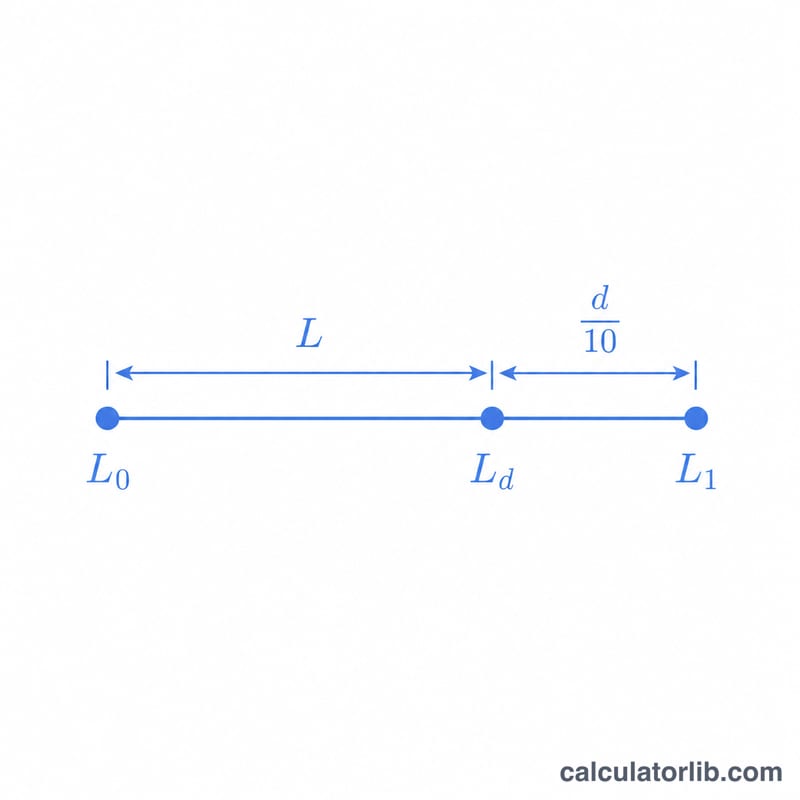
n क्रमबद्ध मानों के लिए, k-वें डेसाइल की स्थिति \(L = k(n+1)/10\) होती है। अगर \(L\) पूर्ण संख्या है, तो डेसाइल बस उसी रैंक पर मौजूद मान है। अगर \(L\) दो रैंक के बीच पड़ती है (मान लीजिए 3.4), तो डेसाइल तीसरे मान से चौथे मान की ओर 40% दूरी पर होगा:
$$D = x_3 + 0.4\,(x_4 - x_3)$$जो स्थिति 1 या उससे कम हो, वहाँ सबसे छोटा मान लिया जाता है; और जो स्थिति \(n\) या उससे अधिक हो, वहाँ सबसे बड़ा मान।
हल किया हुआ उदाहरण
डेटा लीजिए 2, 4, 6, 8, 10, 12, 14, 16, 18, 20 (\(n = 10\)) और D3 निकालिए। स्थिति होगी
$$L = \frac{3 \times (10 + 1)}{10} = 3.3$$तो D3 तीसरे मान (6) से चौथे मान (8) की ओर 30% दूरी पर होगा:
$$D_3 = 6 + 0.3 \times (8 - 6) = 6.6$$अधिक कार्य किए गए उदाहरण
नीचे दिया गया प्रत्येक उदाहरण एक ही तीन चरणों का पालन करता है: डेटा को क्रमबद्ध करें, रैंक स्थिति की गणना करें \(P = \dfrac{k\,(n+1)}{10}\), फिर इसे पूर्णांक भाग \(L = \lfloor P \rfloor\) और अंश \(f = P - L\) में विभाजित करें और \(L\)वें और \((L+1)\)वें क्रमबद्ध मानों के बीच प्रक्षेप करें।
उदाहरण 1 — एक पूर्ण-संख्या रैंक (n = 19, k = 5)
कच्चा इनपुट: 2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32
क्रमबद्ध सूची (पहले से आरोही में), रैंक 1–19 के साथ:
2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 18, 19, 21, 23, 25, 26, 28, 30, 32 → \(n = 19\)
रैंक स्थिति:
$$P = \frac{5\,(19+1)}{10} = \frac{5 \times 20}{10} = \frac{100}{10} = 10$$प्रक्षेप: \(L = \lfloor 10 \rfloor = 10\) और \(f = 10 - 10 = 0\), तो भिन्नात्मक पद लुप्त हो जाता है:
$$D_5 = x_{(10)} + 0 \times \bigl(x_{(11)} - x_{(10)}\bigr) = 16 + 0 \times (18 - 16) = 16$$अंतिम मान: \(D_5 = \) 16। क्योंकि \(P\) बिल्कुल एक पूर्णांक पर उतरा, कोई प्रक्षेप की आवश्यकता नहीं थी और \(D_5\) केवल 10वीं क्रमबद्ध टिप्पणी है — जो \(n = 19\) के लिए माध्यिका भी है।
उदाहरण 2 — छोटा, असंभाजित n दोहराए गए मानों के साथ (n = 7)
कच्चा इनपुट: 12, 5, 9, 5, 20, 9, 14
क्रमबद्ध चरण: 5, 5, 9, 9, 12, 14, 20 → \(n = 7\), तो रैंक 1 से 7 तक चलती है और \(n + 1 = 8\)। दोहराए गए 5 रैंक 1 और 2 पर हैं; दोहराए गए 9 रैंक 3 और 4 पर हैं। संबंध अलग टिप्पणियों के रूप में रखे जाते हैं — वे विलय नहीं किए जाते हैं।
D1:
$$P = \frac{1 \times 8}{10} = 0.8, \qquad L = \lfloor 0.8 \rfloor = 0, \qquad f = 0.8$$रैंक 0 मौजूद नहीं है (सबसे छोटे मान के नीचे कोई \(x_{(0)}\) नहीं है), तो लक्ष्य स्थिति डेटा के बाहर है और परिणाम न्यूनतम तक सीमित है:
$$D_1 = x_{(1)} = 5$$D9:
$$P = \frac{9 \times 8}{10} = 7.2, \qquad L = \lfloor 7.2 \rfloor = 7, \qquad f = 0.2$$प्रक्षेप को \(x_{(8)}\) की आवश्यकता होगी, लेकिन सूची रैंक 7 पर रुकती है, तो परिणाम अधिकतम तक सीमित है:
$$D_9 = x_{(7)} = 20$$समान डेटा के लिए D5 सूची के अंदर स्पष्ट रूप से उतरता है:
$$P = \frac{5 \times 8}{10} = 4, \qquad L = 4,\; f = 0 \quad\Rightarrow\quad D_5 = x_{(4)} = 9$$अंतिम मान: \(D_1 = 5\), \(D_5 = \) 9, \(D_9 = 20\)। केवल 7 टिप्पणियों के साथ, \(D_1\) और \(D_9\) सबसे छोटे और सबसे बड़े मानों पर ध्वस्त हो जाते हैं; डेटा सेट को \(k = 1\) के लिए \(P\) को रैंक 1 पर या उसके अंदर गिरने के लिए \(n \ge 9\) की आवश्यकता है, और \(k = 9\) के लिए भी इसी तरह \(n \ge 9\) की आवश्यकता है।
उदाहरण 3 — 25 परीक्षा स्कोर, D8 खोजें
कच्चा इनपुट (रिकॉर्ड किए गए क्रम में स्कोर):
72, 85, 58, 90, 66, 41, 78, 93, 62, 70, 99, 55, 80, 68, 48, 96, 74, 60, 82, 52, 91, 63, 76, 65, 71
क्रमबद्ध सूची (रैंक 1–25):
41, 48, 52, 55, 58, 60, 62, 63, 65, 66, 68, 70, 71, 72, 74, 76, 78, 80, 82, 85, 90, 91, 93, 96, 99 → \(n = 25\)
8वें डेसाइल के लिए रैंक स्थिति:
$$P = \frac{8\,(25+1)}{10} = \frac{8 \times 26}{10} = \frac{208}{10} = 20.8$$तो \(L = \lfloor 20.8 \rfloor = 20\) और \(f = 20.8 - 20 = 0.8\)। 20वां क्रमबद्ध स्कोर \(x_{(20)} = 85\) है और 21वां \(x_{(21)} = 90\) है।
प्रक्षेप:
$$D_8 = x_{(20)} + 0.8\,\bigl(x_{(21)} - x_{(20)}\bigr) = 85 + 0.8\,(90 - 85) = 85 + 0.8 \times 5 = 85 + 4 = 89$$अंतिम मान: \(D_8 = \) 89 अंक। इस उपकरण के सम्मेलन के तहत, 89 का स्कोर वह कट-ऑफ को चिह्नित करता है जिस पर 25 दर्ज किए गए स्कोर का लगभग 80% इस पर या उससे नीचे गिरता है। ध्यान दें कि 89 देखे गए स्कोर में से एक नहीं है — प्रक्षेप 20वीं और 21वीं टिप्पणियों के बीच एक मान उत्पन्न करता है, जो सामान्य है और जब भी \(f \neq 0\) अपेक्षित है।
डेसाइल, प्रतिशतक और चतुर्थक समतुल्य
डेसाइल, प्रतिशतक और मात्रा अंश एक ही कट-बिंदुओं के लिए तीन संकेतन हैं: \(D_k\) \(10k\)वां प्रतिशतक है, अर्थात् अंश \(k/10\) पर मात्रा। अंतिम स्तंभ इस उपकरण के रैंक सूत्र \(L = \dfrac{k(n+1)}{10}\) का मूल्यांकन \(n = 20\) के एक नमूने के लिए करता है (तो \(n + 1 = 21\)), क्रमबद्ध सूची में ठोस स्थिति दिखाने के लिए।
| डेसाइल | समतुल्य प्रतिशतक | मात्रा अंश | चतुर्थक समतुल्य | रैंक \(P = k(n+1)/10\) के लिए \(n = 20\) | प्रक्षेप की आवश्यकता है? |
|---|---|---|---|---|---|
| D1 | 10वां प्रतिशतक | 0.1 | — | \(1 \times 21/10 = 2.1\) | हाँ: \(x_{(2)} + 0.1\,(x_{(3)} - x_{(2)})\) |
| D2 | 20वां प्रतिशतक | 0.2 | — | \(2 \times 21/10 = 4.2\) | हाँ: \(x_{(4)} + 0.2\,(x_{(5)} - x_{(4)})\) |
| D3 | 30वां प्रतिशतक | 0.3 | — | \(3 \times 21/10 = 6.3\) | हाँ: \(x_{(6)} + 0.3\,(x_{(7)} - x_{(6)})\) |
| D4 | 40वां प्रतिशतक | 0.4 | — | \(4 \times 21/10 = 8.4\) | हाँ: \(x_{(8)} + 0.4\,(x_{(9)} - x_{(8)})\) |
| D5 | 50वां प्रतिशतक | 0.5 | \(Q_2\) = माध्यिका (किसी भी \(n\) के लिए सटीक) | \(5 \times 21/10 = 10.5\) | हाँ: \(x_{(10)} + 0.5\,(x_{(11)} - x_{(10)})\) — सामान्य सम-\(n\) माध्यिका |
| D6 | 60वां प्रतिशतक | 0.6 | — | \(6 \times 21/10 = 12.6\) | हाँ: \(x_{(12)} + 0.6\,(x_{(13)} - x_{(12)})\) |
| D7 | 70वां प्रतिशतक | 0.7 | — | \(7 \times 21/10 = 14.7\) | हाँ: \(x_{(14)} + 0.7\,(x_{(15)} - x_{(14)})\) |
| D8 | 80वां प्रतिशतक | 0.8 | — | \(8 \times 21/10 = 16.8\) | हाँ: \(x_{(16)} + 0.8\,(x_{(17)} - x_{(16)})\) |
| D9 | 90वां प्रतिशतक | 0.9 | — | \(9 \times 21/10 = 18.9\) | हाँ: \(x_{(18)} + 0.9\,(x_{(19)} - x_{(18)})\) |
चतुर्थकों पर नोट: केवल मध्य कट-बिंदु दोनों प्रणालियों के बीच साझा किया जाता है — \(D_5 = P_{50} = Q_2\) = माध्यिका। कोई डेसाइल \(Q_1\) या \(Q_3\) के साथ मेल नहीं खाता है। पहला चतुर्थक 25वें प्रतिशतक पर स्थित है, जो "\(D_{2.5}\)" होगा, और तीसरा चतुर्थक 75वें प्रतिशतक पर, अर्थात् "\(D_{7.5}\)" — और \(k = 2.5\) और \(k = 7.5\) डेसाइल नहीं हैं, क्योंकि \(k\) केवल पूर्णांक मान 1 से 9 तक लेता है। \(Q_1\) इसलिए \(D_2\) और \(D_3\) के बीच गिरता है, और \(Q_3\) \(D_7\) और \(D_8\) के बीच गिरता है। समान \((n+1)\) सम्मेलन के साथ \(Q_1\) या \(Q_3\) प्राप्त करने के लिए, रैंक \(P = \dfrac{j(n+1)}{4}\) का उपयोग करें \(j = 1, 3\) के लिए इसके बजाय।
सीमाओं पर नोट: \(k = 0\) और \(k = 10\) भी डेसाइल नहीं हैं — वे 0वें और 100वें प्रतिशतक के अनुरूप होंगे, अर्थात् डेटा सेट का न्यूनतम और अधिकतम। नौ डेसाइल दस अंतराल बनाते हैं, तो \(n\) टिप्पणियों के साथ प्रत्येक अंतर-डेसाइल अंतराल उनमें से लगभग \(n/10\) होता है।
अक्सर पूछे जाने वाले सवाल
डेसाइल और पर्सेंटाइल में क्या फर्क है? डेसाइल डेटा को 10 हिस्सों में बाँटते हैं, जबकि पर्सेंटाइल 100 हिस्सों में। \(D_k\), \((10k)\)-वें पर्सेंटाइल के बराबर होता है, इसलिए D3 दरअसल 30वाँ पर्सेंटाइल है।
मुझे ऐसा दशमलव मान क्यों मिलता है जो मेरे डेटा में है ही नहीं? जब निकाली गई रैंक स्थिति पूर्ण संख्या नहीं होती, तो कैलकुलेटर दो नज़दीकी मानों के बीच इंटरपोलेशन करता है, इसलिए नतीजा ऐसा मान हो सकता है जो आपकी मूल सूची में मौजूद न हो।
क्या मेरे इनपुट का क्रम मायने रखता है? नहीं — कैलकुलेटर आपके लिए डेटा को खुद क्रम में लगा देता है, इसलिए आप संख्याओं को किसी भी क्रम में पेस्ट कर सकते हैं।