Что делает этот калькулятор
Инструмент подбирает выбранную модель регрессии к вашей таблице парных наблюдений (x, y) методом наименьших квадратов. Он выдаёт найденные коэффициенты (A, B, а для квадратичной модели ещё и C), коэффициент корреляции \(r\), который показывает, насколько хорошо модель описывает данные, и прогнозное значение, рассчитанное прямо по полученному уравнению. Это универсальный математико-статистический инструмент: никаких региональных правил или ограничений он не учитывает.
Семь моделей
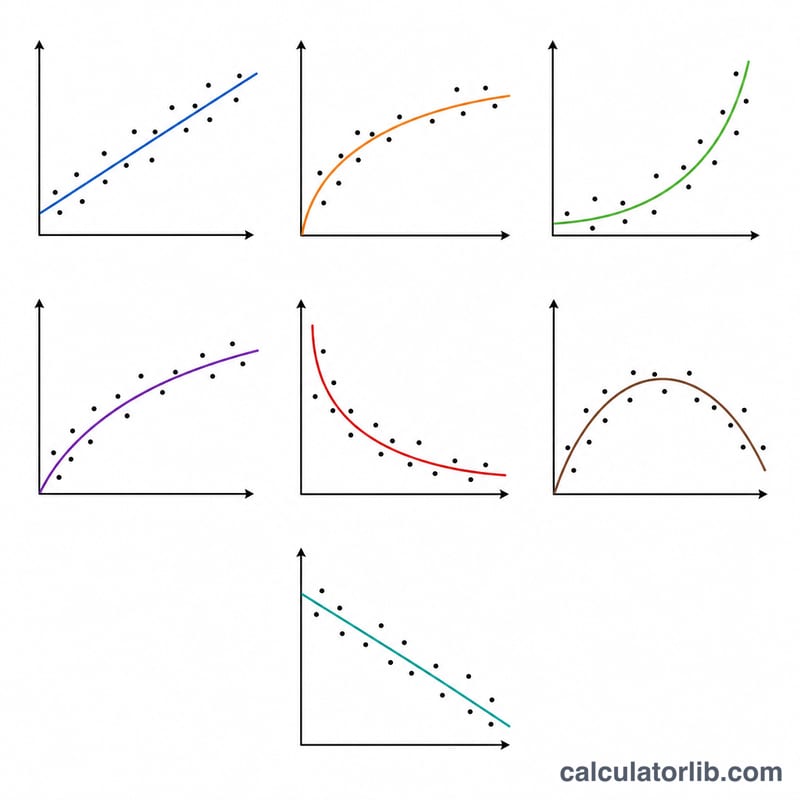
Доступны: линейная \((y = A + B\cdot x)\), логарифмическая \((y = A + B\cdot \ln x)\), e-экспоненциальная \((y = A\cdot e^{Bx})\), ab-экспоненциальная \((y = A\cdot B^x)\), степенная \((y = A\cdot x^B)\), обратная \((y = A + B/x)\) и квадратичная \((y = A + B\cdot x + C\cdot x^2)\). Все модели, кроме квадратичной, подбираются путём линеаризации к виду \(Y = a + b\cdot X\) с последующим применением обычного метода наименьших квадратов; квадратичная же решается из системы из трёх нормальных уравнений (\(3\times 3\)).
Как пользоваться
Введите значения x и значения y списками через запятую одинаковой длины, выберите тип регрессии, укажите, что хотите оценить — y по x или x по y, и впишите известное входное значение. Калькулятор вернёт коэффициенты, корреляцию \(r\) и прогноз.
Разбор формулы
Для линеаризованных пар (X, Y): \(b = S_{xy} / S_{xx}\) и \(a = \bar{Y} - b\cdot \bar{X}\), где \(S_{xx} = \sum X^2 - n\bar{X}^2\) и \(S_{xy} = \sum XY - n\bar{X}\bar{Y}\). Корреляция вычисляется как $$r = \frac{S_{xy}}{\sqrt{S_{xx}\cdot S_{yy}}}.$$ После этого коэффициенты возвращаются к исходным переменным обратной подстановкой (например, \(A = e^a\) в экспоненциальной и степенной моделях).
Пример с расчётом
Пусть x = [1,2,3,4,5,6,7] и y = [3,5,7,8,11,13,14] при линейной аппроксимации: \(S_{xx} = 28\), \(S_{xy} = 53\), поэтому $$B = \frac{53}{28} = 1{,}892857$$ и $$A = 8{,}714286 - 1{,}892857\cdot 4 = 1{,}142857.$$ Корреляция равна $$r = \frac{53}{\sqrt{28\cdot 101{,}4286}} = 0{,}99453.$$ Прогноз y при x = 64 даёт $$1{,}142857 + 1{,}892857\cdot 64 = 122{,}2857$$ (это экстраполяция далеко за пределы исходного диапазона данных).
Частые вопросы
Как трактовать \(r\)? Приблизительно так: \(0{,}7 < |r| \le 1\) — сильная связь, \(0{,}4 < |r| < 0{,}7\) — умеренная, \(0{,}2 < |r| < 0{,}4\) — слабая, ниже \(0{,}2\) — практически отсутствует.
Почему некоторые модели отклоняются? Логарифмическая и степенная модели требуют \(x > 0\), экспоненциальная и степенная — \(y > 0\), а обратная — \(x \ne 0\), поскольку используются логарифмическое или обратное преобразование.
Можно ли экстраполировать? Да, но прогнозы за пределами наблюдаемого диапазона данных — это экстраполяция, и относиться к ним следует с осторожностью.
Пошаговая инструкция: подбор кривой вручную
- Выберите модель. Выберите линейную, логарифмическую, экспоненциальную (e-форма или ab-форма), степенную, обратную или квадратичную модель в зависимости от формы диаграммы рассеяния и того, что вы знаете о процессе.
- Проверьте ограничения области определения. Логарифмическая модель требует x > 0. Экспоненциальная требует y > 0. Степенная требует одновременно x > 0 и y > 0. Обратная требует x ≠ 0. Если какая-либо точка данных нарушает это правило, эту модель нельзя подобрать к данным.
- Преобразуйте данные. Замените x и y на X и Y в соответствии с моделью: X = ln x, Y = ln y или X = 1/x. Оставьте переменную без изменений, если модель её не преобразует.
- Вычислите суммы, средние значения и суммы квадратов для преобразованных данных (n точек):
$$S_{xx}=\sum X^2-\frac{(\sum X)^2}{n},\quad S_{xy}=\sum XY-\frac{\sum X\,\sum Y}{n},\quad S_{yy}=\sum Y^2-\frac{(\sum Y)^2}{n}$$ и средние \(\bar X=\sum X/n\), \(\bar Y=\sum Y/n\). - Найдите наклон и свободный член прямой \(Y = a + bX\):
$$b=\frac{S_{xy}}{S_{xx}},\qquad a=\bar Y-b\,\bar X$$ - Выполните обратную подстановку к исходным параметрам. Для ab-экспоненциальной модели \(A=e^{a}\) и \(B=e^{b}\). Для e-экспоненциальной и степенной моделей \(A=e^{a}\) и \(B=b\). Для логарифмической и обратной моделей \(A=a\) и \(B=b\).
- Вычислите коэффициент корреляции:
$$r=\frac{S_{xy}}{\sqrt{S_{xx}\,S_{yy}}}$$ Он вычисляется по преобразованным данным. - Сделайте оценку. Подставьте ваше x в полученное уравнение (например, \(\hat y = A\,x^{B}\) для степенной аппроксимации). Чтобы оценить x по заданному y, преобразуйте уравнение и проверьте, что результат лежит в области определения модели.
Примечание о квадратичной модели. Квадратичная модель \(\hat y = A + Bx + Cx^2\) не линеаризуется. Вместо этого решите систему нормальных уравнений 3×3:
$$\begin{aligned}\sum y &= nA + B\sum x + C\sum x^2\\ \sum xy &= A\sum x + B\sum x^2 + C\sum x^3\\ \sum x^2y &= A\sum x^2 + B\sum x^3 + C\sum x^4\end{aligned}$$Вам нужны суммы Σx, Σx², Σx³, Σx⁴, Σy, Σxy и Σx²y. Решите систему по правилу Крамера или методом Гаусса. Требуется не менее трёх различных значений x.
Преобразования для линеаризации по моделям
| Модель | Уравнение | Преобразованный X | Преобразованный Y | Линейная форма | Обратная подстановка (a, b из прямой) | Ограничение области определения |
|---|---|---|---|---|---|---|
| Линейная | \(y = A + Bx\) | x | y | \(y = a + bx\) | A = a, B = b | Нет |
| Логарифмическая | \(y = A + B\ln x\) | ln x | y | \(y = a + bX\) | A = a, B = b | x > 0 |
| Экспоненциальная (e-форма) | \(y = A e^{Bx}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = b | y > 0 |
| Экспоненциальная (ab-форма) | \(y = A B^{x}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = eb | y > 0 |
| Степенная | \(y = A x^{B}\) | ln x | ln y | \(\ln y = a + bX\) | A = ea, B = b | x > 0 и y > 0 |
| Обратная | \(y = A + B/x\) | 1/x | y | \(y = a + bX\) | A = a, B = b | x ≠ 0 |
| Квадратичная | \(y = A + Bx + Cx^2\) | Без линеаризации | Решить систему нормальных уравнений 3×3 | A, B, C получаются непосредственно из решения | Нет (нужно не менее 3 различных значений x) | |
Экспоненты в e-форме и ab-форме описывают одно и то же семейство кривых: \(B_{ab}=e^{B_{e}}\). Они дают одну и ту же аппроксимацию и одинаковое r.
Интерпретация r и выбор между моделями
- Диапазон и знак. r лежит между −1 и 1. Положительное r означает, что Y в целом возрастает с ростом X, а отрицательное — что убывает. |r|, близкое к 1, указывает на сильное соответствие выбранной форме, а |r|, близкое к 0, — на слабое.
- Преобразованные модели. Для логарифмической, экспоненциальной, степенной и обратной аппроксимаций r вычисляется по преобразованным данным (например, ln y относительно ln x). Поэтому его нельзя напрямую сравнивать с r линейной аппроксимации в исходном масштабе. Сравнивать модели по r можно только как грубый ориентир.
- r² (объяснённая дисперсия). r² — это доля дисперсии (преобразованного) Y, объясняемая прямой. Например, r = 0,90 даёт r² = 0,81, то есть примерно 81% дисперсии объясняется.
- Корреляция не означает причинности. Высокое r не доказывает, что одна переменная вызывает другую, и не доказывает, что выбранная модель отражает истинную зависимость. Разные кривые могут примерно одинаково хорошо описывать одни и те же данные.
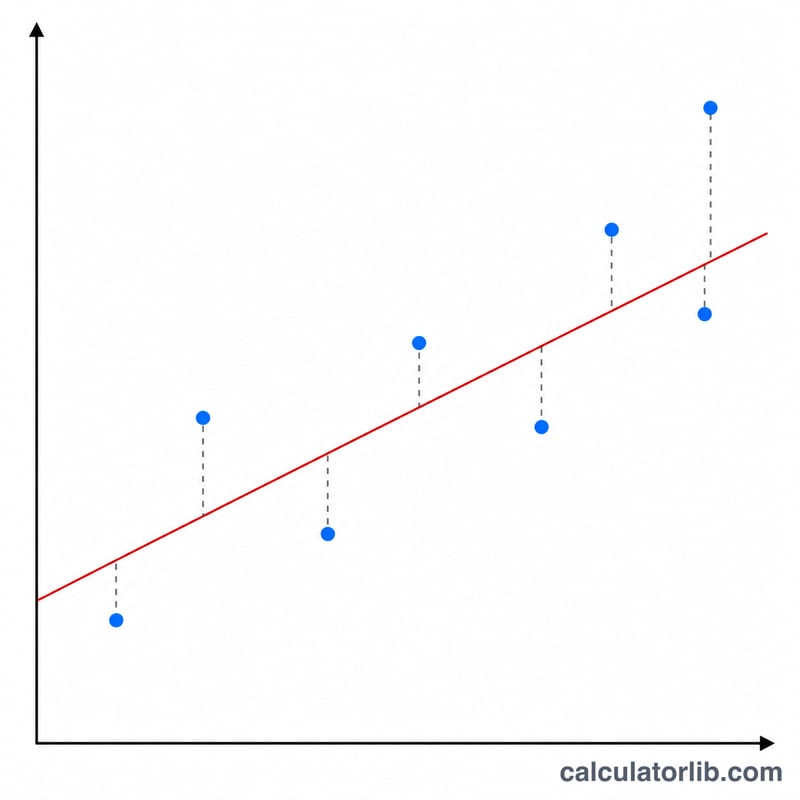
- Проверьте остатки. Постройте график разностей между наблюдаемыми и подобранными значениями. Они должны случайным образом рассеиваться вокруг нуля. Заметная закономерность, например изгиб или воронка, означает, что модель плохо подходит, даже если r высокое.
- Риск экстраполяции. Оценки внутри диапазона ваших данных по x (интерполяция) обычно гораздо надёжнее оценок за его пределами. Экспоненциальные, степенные и квадратичные кривые могут резко расходиться за пределами данных.
- Квадратичная или линейная. Квадратичная модель всегда описывает данные не хуже линейной, поскольку имеет больше параметров и содержит линейную модель как частный случай (C = 0). Один лишь лучший результат подгонки не оправдывает дополнительный член. Предпочитайте более простую модель, если улучшение не существенно и кривизна не имеет смысла для процесса.
- Размер выборки. При очень малом числе точек даже высокое r может возникнуть случайно. Используйте столько данных, сколько практически возможно.