이 계산기는 무엇을 하나요
이 도구는 짝지어진 관측값 (x, y) 표에 원하는 곡선 회귀 모형을 최소제곱법으로 적합합니다. 적합된 계수(A, B, 그리고 이차 모형의 경우 C), 모형이 데이터를 얼마나 잘 설명하는지 나타내는 상관계수 r, 그리고 적합된 식에서 직접 계산한 추정값을 함께 알려줍니다. 특정 국가의 규칙에 얽매이지 않는, 어디서나 쓸 수 있는 수학·통계 도구입니다.
7가지 모형
선형(\(y = A + B\cdot x\)), 로그(\(y = A + B\cdot\ln x\)), e-지수(\(y = A\cdot e^{Bx}\)), ab-지수(\(y = A\cdot B^{x}\)), 거듭제곱(\(y = A\cdot x^{B}\)), 역수(\(y = A + B/x\)), 이차(\(y = A + B\cdot x + C\cdot x^{2}\)) 중에서 고를 수 있습니다. 이차를 제외한 모든 모형은 \(Y = a + b\cdot X\) 형태로 선형화한 뒤 일반 최소제곱법을 적용해 적합하며, 이차 모형은 \(3\times 3\) 정규방정식을 풀어 구합니다.
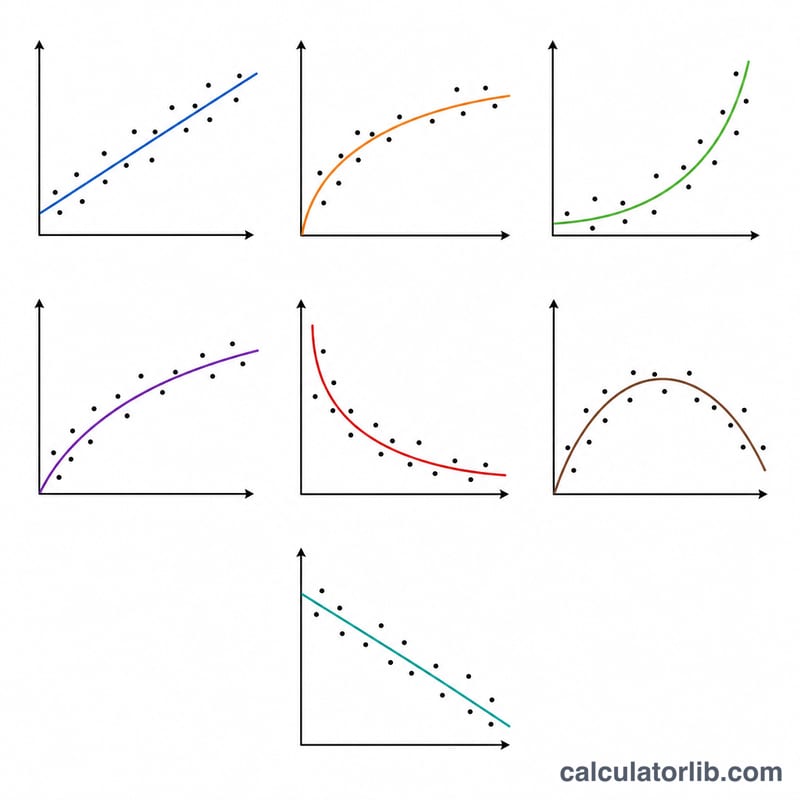
사용 방법
x 값과 y 값을 길이가 같은 쉼표 구분 목록으로 입력하고, 회귀 유형을 선택한 뒤, x로 y를 추정할지 y로 x를 추정할지 정하고 알고 있는 입력값을 적으면 됩니다. 계산기는 계수, 상관계수 r, 추정값을 돌려줍니다.
공식 설명
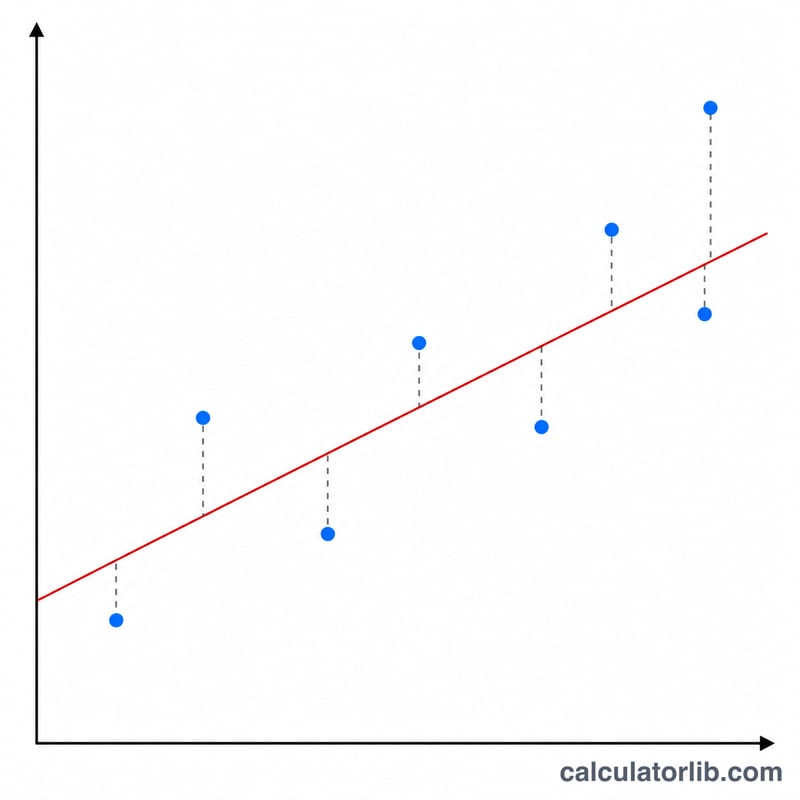
선형화한 짝 (X, Y)에 대해 \(b = S_{xy} / S_{xx}\), \(a = \bar{Y} - b\cdot\bar{X}\) 입니다. 여기서 \(S_{xx} = \sum X^2 - n\bar{X}^2\), \(S_{xy} = \sum XY - n\bar{X}\bar{Y}\) 입니다. 상관계수는 $$r = \frac{S_{xy}}{\sqrt{S_{xx}\cdot S_{yy}}}$$ 입니다. 이렇게 구한 값을 다시 대입해 계수를 복원합니다(예: 지수·거듭제곱 모형에서는 \(A = e^{a}\)).
풀이 예시
x = [1,2,3,4,5,6,7], y = [3,5,7,8,11,13,14] 를 선형으로 적합하면 \(S_{xx} = 28\), \(S_{xy} = 53\) 이므로 \(B = 53/28 = 1.892857\), \(A = 8.714286 - 1.892857\cdot 4 = 1.142857\) 입니다. 상관계수는 $$r = \frac{53}{\sqrt{28\cdot 101.4286}} = 0.99453$$ 입니다. x = 64 에서 y를 추정하면 \(1.142857 + 1.892857\cdot 64 = 122.2857\) 이 나오는데, 이는 데이터 범위를 크게 벗어난 외삽입니다.
단계별 설명: 손으로 곡선 맞추기
- 모델 선택. 산점도의 모양과 과정에 대해 알고 있는 내용을 바탕으로 선형, 로그, 지수(e형 또는 ab형), 거듭제곱, 역수 또는 이차 모델 중 하나를 고르세요.
- 정의역 제한 확인. 로그 모델은 x > 0이 필요합니다. 지수 모델은 y > 0이 필요합니다. 거듭제곱 모델은 x > 0과 y > 0이 모두 필요합니다. 역수 모델은 x ≠ 0이 필요합니다. 어떤 자료점이라도 이 규칙을 위반하면 그 모델은 자료에 맞출 수 없습니다.
- 자료 변환. 모델이 요구하는 대로 x와 y를 X와 Y로 바꾸세요: X = ln x, Y = ln y, 또는 X = 1/x. 모델이 어떤 변수를 변환하지 않으면 그 변수는 그대로 둡니다.
- 변환된 자료의 합, 평균, 제곱합 계산(n개의 점):
$$S_{xx}=\sum X^2-\frac{(\sum X)^2}{n},\quad S_{xy}=\sum XY-\frac{\sum X\,\sum Y}{n},\quad S_{yy}=\sum Y^2-\frac{(\sum Y)^2}{n}$$ 그리고 평균 \(\bar X=\sum X/n\), \(\bar Y=\sum Y/n\). - 직선 \(Y = a + bX\)의 기울기와 절편 구하기:
$$b=\frac{S_{xy}}{S_{xx}},\qquad a=\bar Y-b\,\bar X$$ - 원래 모수로 역대입. ab형 지수 모델에서는 \(A=e^{a}\), \(B=e^{b}\)입니다. e형 지수 모델과 거듭제곱 모델에서는 \(A=e^{a}\), \(B=b\)입니다. 로그 모델과 역수 모델에서는 \(A=a\), \(B=b\)입니다.
- 상관계수 계산:
$$r=\frac{S_{xy}}{\sqrt{S_{xx}\,S_{yy}}}$$ 이것은 변환된 자료에서 계산합니다. - 추정. 맞춘 방정식에 x를 넣으세요(예: 거듭제곱 맞춤의 경우 \(\hat y = A\,x^{B}\)). 주어진 y로부터 x를 추정하려면 방정식을 재배열하고, 결과가 모델의 정의역 안에 있는지 확인하세요.
이차 모델 참고. 이차식 \(\hat y = A + Bx + Cx^2\)은 선형화하지 않습니다. 대신 3×3 정규방정식을 풉니다:
$$\begin{aligned}\sum y &= nA + B\sum x + C\sum x^2\\ \sum xy &= A\sum x + B\sum x^2 + C\sum x^3\\ \sum x^2y &= A\sum x^2 + B\sum x^3 + C\sum x^4\end{aligned}$$Σx, Σx², Σx³, Σx⁴, Σy, Σxy, Σx²y의 합이 필요합니다. 크래머 공식 또는 가우스 소거법으로 연립방정식을 풉니다. 서로 다른 x 값이 최소 세 개 필요합니다.
모델별 선형화 변환
| 모델 | 방정식 | 변환된 X | 변환된 Y | 선형 형태 | 역대입(직선에서 얻은 a, b 사용) | 정의역 제한 |
|---|---|---|---|---|---|---|
| 선형 | \(y = A + Bx\) | x | y | \(y = a + bx\) | A = a, B = b | 없음 |
| 로그 | \(y = A + B\ln x\) | ln x | y | \(y = a + bX\) | A = a, B = b | x > 0 |
| 지수(e형) | \(y = A e^{Bx}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = b | y > 0 |
| 지수(ab형) | \(y = A B^{x}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = eb | y > 0 |
| 거듭제곱 | \(y = A x^{B}\) | ln x | ln y | \(\ln y = a + bX\) | A = ea, B = b | x > 0이고 y > 0 |
| 역수 | \(y = A + B/x\) | 1/x | y | \(y = a + bX\) | A = a, B = b | x ≠ 0 |
| 이차 | \(y = A + Bx + Cx^2\) | 선형화 없음 | 3×3 정규방정식을 풂 | A, B, C는 해에서 직접 구함 | 없음(서로 다른 x 값이 최소 3개 필요) | |
e형과 ab형 지수 함수는 같은 곡선 族을 나타냅니다: \(B_{ab}=e^{B_{e}}\). 두 형태는 같은 적합 결과와 같은 r을 줍니다.
r의 해석과 모델 선택
- 범위와 부호. r은 −1과 1 사이에 있습니다. r이 양수이면 Y가 X에 따라 증가하는 경향이 있고, 음수이면 감소하는 경향이 있습니다. |r|이 1에 가까우면 맞춘 형태에 대한 적합이 강하다는 뜻이고, |r|이 0에 가까우면 적합이 약하다는 뜻입니다.
- 변환된 모델. 로그, 지수, 거듭제곱, 역수 적합에서 r은 변환된 자료(예: ln y 대 ln x)에서 계산합니다. 따라서 원래 척도에서 한 선형 적합의 r과 직접 비교할 수 없습니다. r로 모델을 비교하는 것은 대략적인 기준일 뿐입니다.
- r² (설명된 분산). r²은 맞춘 직선이 변환된 Y의 분산 중 설명하는 비율입니다. 예를 들어 r = 0.90이면 r² = 0.81이므로 분산의 약 81%가 설명됩니다.
- 상관은 인과가 아닙니다. 높은 r은 한 변수가 다른 변수를 일으킨다는 것을 보여 주지 않으며, 선택한 모델이 참된 관계라는 것도 보여 주지 않습니다. 서로 다른 곡선들이 같은 자료에 거의 같은 정도로 잘 맞을 수 있습니다.
- 잔차 확인. 관측값과 적합값의 차이를 그려 보세요. 이 차이들은 0 주위에 무작위로 흩어져 있어야 합니다. 곡선이나 깔때기 모양 같은 뚜렷한 패턴이 보이면, r이 높더라도 그 모델은 잘 맞지 않는 것입니다.
- 외삽의 위험. x 자료의 범위 안에서 하는 추정(내삽)은 그 범위 밖에서 하는 추정보다 보통 훨씬 신뢰할 수 있습니다. 지수, 거듭제곱, 이차 곡선은 자료 범위를 벗어나면 급격히 벗어날 수 있습니다.
- 이차 대 선형. 같은 자료에서 이차 모델은 항상 선형 모델만큼은 잘 맞거나 그보다 잘 맞습니다. 이차 모델은 모수가 더 많고 선형 모델을 특수한 경우(C = 0)로 포함하기 때문입니다. 따라서 적합이 더 좋다는 것만으로는 추가된 항을 정당화할 수 없습니다. 개선이 의미 있고 곡률이 그 과정에 비추어 타당하지 않다면 더 단순한 모델을 선호하세요.
- 표본 크기. 점이 매우 적으면 r이 높아도 우연에 의해 생길 수 있습니다. 실용적으로 가능한 한 많은 자료를 사용하세요.
자주 묻는 질문
r은 어떻게 해석하나요? 대략적으로 \(0.7 < |r| \le 1\) 이면 강한 상관, \(0.4 < |r| < 0.7\) 이면 중간, \(0.2 < |r| < 0.4\) 이면 약한 상관, 0.2 미만이면 무시할 수준입니다.
일부 모형이 거부되는 이유는 무엇인가요? 로그·거듭제곱 모형은 \(x > 0\), 지수·거듭제곱 모형은 \(y > 0\), 역수 모형은 \(x \ne 0\) 이어야 합니다. 로그나 역수 변환을 사용하기 때문입니다.
외삽해도 되나요? 가능합니다. 다만 관측된 데이터 범위 밖의 추정값은 외삽이므로 주의해서 다뤄야 합니다.