यह कैलकुलेटर क्या करता है
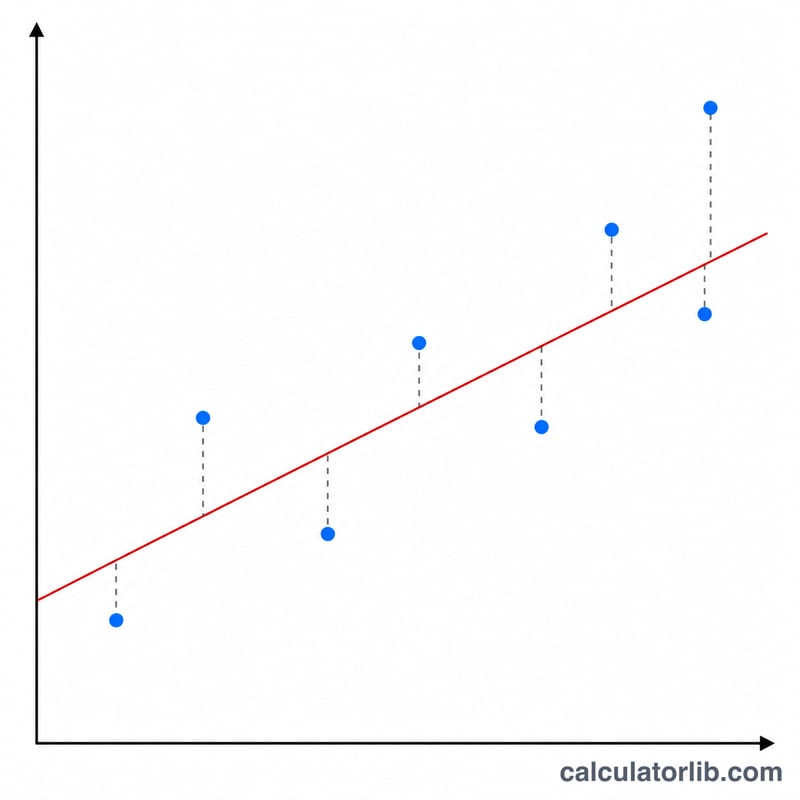
यह टूल आपके युग्मित प्रेक्षणों (x, y) की तालिका पर चुने गए वक्र-रिग्रेशन मॉडल को न्यूनतम वर्ग विधि (least squares) के ज़रिए फिट करता है। यह फिट किए गए गुणांक (A, B, और द्विघात के लिए C), सहसंबंध गुणांक r—जो बताता है कि मॉडल डेटा का कितना अच्छा वर्णन करता है—और फिट किए गए समीकरण से सीधे निकाला गया अनुमानित मान देता है। यह एक सर्वमान्य गणित एवं सांख्यिकी टूल है, जिसमें किसी देश-विशेष के नियम लागू नहीं होते।
सात मॉडल
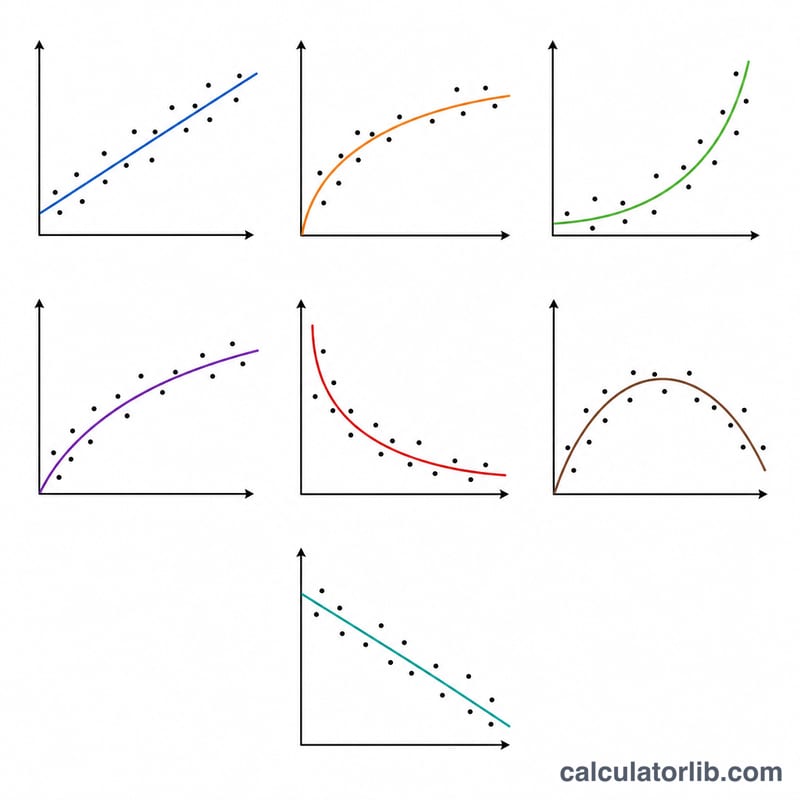
आप इनमें से चुन सकते हैं: रैखिक \(y = A + B\cdot x\), लघुगणकीय \(y = A + B\cdot \ln x\), e-चरघातांकी \(y = A\cdot e^{Bx}\), ab-चरघातांकी \(y = A\cdot B^x\), घात \(y = A\cdot x^B\), व्युत्क्रम \(y = A + B/x\), या द्विघात \(y = A + B\cdot x + C\cdot x^2\)। द्विघात को छोड़कर बाकी सभी को \(Y = a + b\cdot X\) रूप में रैखिक बनाकर साधारण न्यूनतम वर्ग लगाकर फिट किया जाता है; द्विघात को इसके \(3\times 3\) सामान्य समीकरणों से हल किया जाता है।
इसका उपयोग कैसे करें
अपने x मान और y मान बराबर लंबाई की कॉमा-विभाजित सूचियों के रूप में दर्ज करें, रिग्रेशन का प्रकार चुनें, तय करें कि आपको x से y का अनुमान चाहिए या y से x का, और ज्ञात इनपुट मान टाइप करें। कैलकुलेटर गुणांक, सहसंबंध r और अनुमान लौटा देगा।
सूत्र की व्याख्या
रैखिक बनाए गए युग्मों (X, Y) के लिए:
$$b = \frac{S_{xy}}{S_{xx}} \qquad a = \bar{Y} - b\cdot\bar{X}$$जहाँ
$$S_{xx} = \sum X^2 - n\bar{X}^2 \qquad S_{xy} = \sum XY - n\bar{X}\bar{Y}$$होते हैं। सहसंबंध
$$r = \frac{S_{xy}}{\sqrt{S_{xx}\cdot S_{yy}}}$$है। इसके बाद गुणांकों को वापस प्रतिस्थापित किया जाता है (उदाहरण के लिए चरघातांकी और घात मॉडलों में \(A = e^a\))।
हल किया गया उदाहरण
x = [1,2,3,4,5,6,7] और y = [3,5,7,8,11,13,14] के लिए रैखिक फिट करने पर: \(S_{xx} = 28\), \(S_{xy} = 53\), इसलिए
$$B = \frac{53}{28} = 1.892857$$और
$$A = 8.714286 - 1.892857\cdot 4 = 1.142857$$सहसंबंध
$$r = \frac{53}{\sqrt{28\cdot 101.4286}} = 0.99453$$है। x = 64 पर y का अनुमान
$$1.142857 + 1.892857\cdot 64 = 122.2857$$आता है (जो डेटा सीमा से कहीं आगे का एक्सट्रापोलेशन है)।
चरण-दर-चरण: हाथ से वक्र फिट करना
- मॉडल चुनें। स्कैटर प्लॉट के आकार और प्रक्रिया के बारे में आपकी जानकारी के आधार पर रैखिक, लघुगणकीय, घातांकीय (e-रूप या ab-रूप), घात, व्युत्क्रम या द्विघात में से चुनें।
- डोमेन प्रतिबंध जाँचें। लघुगणकीय के लिए x > 0 चाहिए। घातांकीय के लिए y > 0 चाहिए। घात के लिए x > 0 और y > 0 दोनों चाहिए। व्युत्क्रम के लिए x ≠ 0 चाहिए। यदि कोई डेटा बिंदु नियम का उल्लंघन करता है, तो वह मॉडल उस डेटा पर फिट नहीं किया जा सकता।
- डेटा रूपांतरित करें। मॉडल की आवश्यकता के अनुसार x और y को X और Y से बदलें: X = ln x, Y = ln y, या X = 1/x। यदि मॉडल किसी चर का रूपांतरण नहीं करता, तो उसे अपरिवर्तित रखें।
- रूपांतरित डेटा पर योग, माध्य और वर्गों के योग की गणना करें (n बिंदु):
$$S_{xx}=\sum X^2-\frac{(\sum X)^2}{n},\quad S_{xy}=\sum XY-\frac{\sum X\,\sum Y}{n},\quad S_{yy}=\sum Y^2-\frac{(\sum Y)^2}{n}$$ और माध्य \(\bar X=\sum X/n\), \(\bar Y=\sum Y/n\)। - सीधी रेखा \(Y = a + bX\) की ढलान और अंतःखंड निकालें:
$$b=\frac{S_{xy}}{S_{xx}},\qquad a=\bar Y-b\,\bar X$$ - मूल प्राचलों तक वापस लौटें। ab-घातांकीय मॉडल के लिए \(A=e^{a}\) और \(B=e^{b}\)। e-घातांकीय और घात मॉडल के लिए \(A=e^{a}\) और \(B=b\)। लघुगणकीय और व्युत्क्रम मॉडल के लिए \(A=a\) और \(B=b\)।
- सहसंबंध गुणांक की गणना करें:
$$r=\frac{S_{xy}}{\sqrt{S_{xx}\,S_{yy}}}$$ यह रूपांतरित डेटा पर गणना की जाती है। - अनुमान लगाएँ। अपना x फिट किए गए समीकरण में रखें (उदाहरण के लिए घात फिट के लिए \(\hat y = A\,x^{B}\))। दिए गए y से x का अनुमान लगाने के लिए समीकरण को पुनर्व्यवस्थित करें, और जाँचें कि परिणाम मॉडल के डोमेन में है।
द्विघात टिप्पणी। द्विघात \(\hat y = A + Bx + Cx^2\) का रैखिकीकरण नहीं किया जाता। इसके बजाय 3×3 सामान्य समीकरणों को हल करें:
$$\begin{aligned}\sum y &= nA + B\sum x + C\sum x^2\\ \sum xy &= A\sum x + B\sum x^2 + C\sum x^3\\ \sum x^2y &= A\sum x^2 + B\sum x^3 + C\sum x^4\end{aligned}$$आपको Σx, Σx², Σx³, Σx⁴, Σy, Σxy और Σx²y के योग चाहिए। तंत्र को क्रेमर नियम या गाउसीय विलोपन से हल करें। कम से कम तीन भिन्न x मान आवश्यक हैं।
मॉडल के अनुसार रैखिकीकरण रूपांतरण
| मॉडल | समीकरण | रूपांतरित X | रूपांतरित Y | रैखिक रूप | प्रतिस्थापन (रेखा से a, b) | डोमेन प्रतिबंध |
|---|---|---|---|---|---|---|
| रैखिक | \(y = A + Bx\) | x | y | \(y = a + bx\) | A = a, B = b | कोई नहीं |
| लघुगणकीय | \(y = A + B\ln x\) | ln x | y | \(y = a + bX\) | A = a, B = b | x > 0 |
| घातांकीय (e-रूप) | \(y = A e^{Bx}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = b | y > 0 |
| घातांकीय (ab-रूप) | \(y = A B^{x}\) | x | ln y | \(\ln y = a + bx\) | A = ea, B = eb | y > 0 |
| घात | \(y = A x^{B}\) | ln x | ln y | \(\ln y = a + bX\) | A = ea, B = b | x > 0 और y > 0 |
| व्युत्क्रम | \(y = A + B/x\) | 1/x | y | \(y = a + bX\) | A = a, B = b | x ≠ 0 |
| द्विघात | \(y = A + Bx + Cx^2\) | कोई रैखिकीकरण नहीं | 3×3 सामान्य समीकरण हल करें | A, B, C सीधे हल से मिलते हैं | कोई नहीं (कम से कम 3 भिन्न x मान चाहिए) | |
e-रूप और ab-रूप घातांकीय एक ही वक्र परिवार का वर्णन करते हैं: \(B_{ab}=e^{B_{e}}\)। वे एक ही फिट और एक ही r देते हैं।
r की व्याख्या और मॉडलों के बीच चयन
- सीमा और चिह्न। r −1 और 1 के बीच होता है। धनात्मक r का अर्थ है कि Y, X के साथ बढ़ने की प्रवृत्ति रखता है, और ऋणात्मक r का अर्थ है कि वह घटने की प्रवृत्ति रखता है। |r| का 1 के निकट होना फिट किए गए रूप से मजबूत फिट दर्शाता है, और |r| का 0 के निकट होना कमजोर फिट दर्शाता है।
- रूपांतरित मॉडल। लघुगणकीय, घातांकीय, घात और व्युत्क्रम फिट के लिए r रूपांतरित डेटा पर गणना किया जाता है (जैसे ln x के विरुद्ध ln y)। इसलिए इसे मूल पैमाने पर रैखिक फिट के r से सीधे तुलना नहीं किया जा सकता। r से मॉडलों की तुलना केवल एक मोटा मार्गदर्शन है।
- r² (समझाया गया विचरण)। r² रूपांतरित Y के उस विचरण का अनुपात है जो फिट की गई रेखा द्वारा समझाया गया है। उदाहरण के लिए, r = 0.90 से r² = 0.81 मिलता है, अर्थात लगभग 81% विचरण समझाया गया है।
- सहसंबंध कारण नहीं है। उच्च r यह नहीं दिखाता कि एक चर दूसरे का कारण है, न ही यह कि चुना गया मॉडल वास्तविक संबंध है। अलग-अलग वक्र उसी डेटा पर लगभग समान रूप से अच्छे फिट हो सकते हैं।
- अवशेषों की जाँच करें। देखे गए और फिट किए गए मानों के अंतर का प्लॉट बनाएँ। वे शून्य के चारों ओर यादृच्छिक रूप से बिखरे होने चाहिए। कोई दिखाई देने वाला पैटर्n, जैसे वक्र या फ़नल आकार, दर्शाता है कि मॉडल उपयुक्त नहीं है, भले ही r उच्च हो।
- एक्सट्रापोलेशन जोखिम। आपके x डेटा की सीमा के भीतर के अनुमान (इंटरपोलेशन) आमतौर पर उसके बाहर के अनुमानों से कहीं अधिक विश्वसनीय होते हैं। घातांकीय, घात और द्विघात वक्र डेटा से आगे तेजी से भटक सकते हैं।
- द्विघात बनाम रैखिक। द्विघात हमेशा उसी डेटा पर रैखिक मॉडल से कम से कम उतना ही अच्छा फिट होता है, क्योंकि इसमें अधिक प्राचल हैं और इसमें रैखिक मॉडल एक विशेष स्थिति के रूप में शामिल है (C = 0)। केवल बेहतर फिट होने से अतिरिक्त पद उचित नहीं ठहरता। जब तक सुधार सार्थक न हो और वक्रता प्रक्रिया के लिए तर्कसंगत न हो, सरल मॉडल को प्राथमिकता दें।
- नमूना आकार। बहुत कम बिंदुओं के साथ, उच्च r भी संयोग से उत्पन्न हो सकता है। जितना व्यावहारिक हो उतना डेटा उपयोग करें।
अक्सर पूछे जाने वाले प्रश्न
r की व्याख्या कैसे करें? मोटे तौर पर: \(0.7 < |r| \le 1\) मज़बूत, \(0.4 < |r| < 0.7\) मध्यम, \(0.2 < |r| < 0.4\) कमज़ोर, और \(0.2\) से कम नगण्य सहसंबंध माना जाता है।
कुछ मॉडल अस्वीकार क्यों हो जाते हैं? लघुगणकीय और घात मॉडलों के लिए \(x > 0\) ज़रूरी है, चरघातांकी और घात मॉडलों के लिए \(y > 0\) ज़रूरी है, और व्युत्क्रम के लिए \(x \ne 0\) चाहिए—क्योंकि इनमें ल␘घुगणक या व्युत्क्रम रूपांतरण लगता है।
क्या मैं एक्सट्रापोलेट कर सकता हूँ? हाँ, पर प्रेक्षित डेटा सीमा से बाहर के अनुमान एक्सट्रापोलेशन होते हैं और इन्हें सावधानी से ही लेना चाहिए।