この計算ツールでできること
このツールは、対になった観測データ(x, y)の表に対して、選んだ曲線回帰モデルを最小二乗法で当てはめます。当てはめた係数(A・B、2次回帰の場合はCも)、モデルがデータをどれだけうまく説明できているかを示す相関係数r、そして当てはめた式から直接求めた推定値を出力します。地域や国ごとのルールに左右されない、汎用的な数学・統計ツールです。
選べる7つのモデル
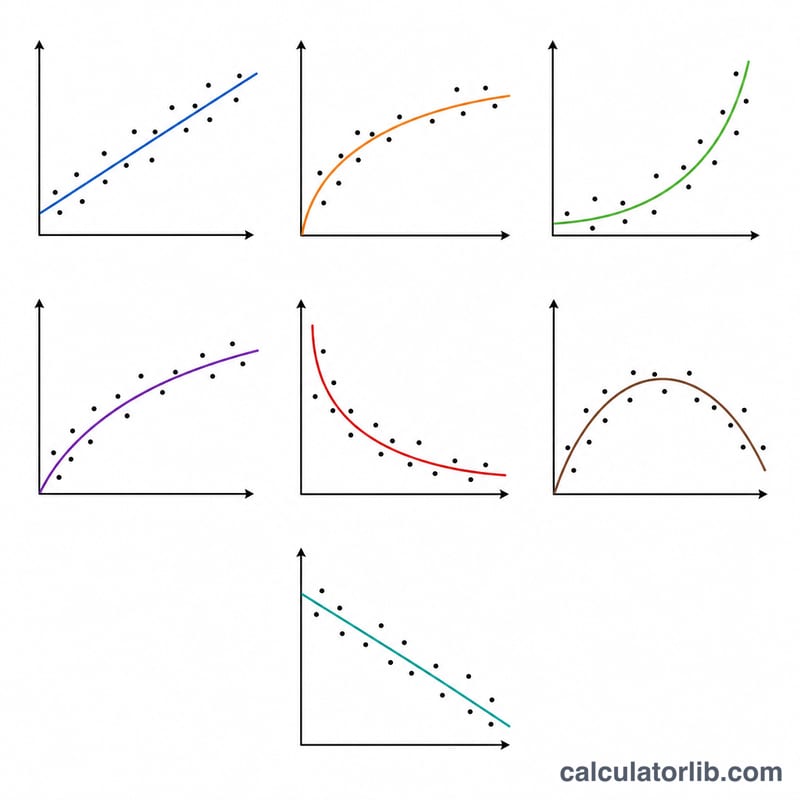
線形(\(y = A + B\cdot x\))、対数(\(y = A + B\cdot\ln x\))、e指数(\(y = A\cdot e^{Bx}\))、ab指数(\(y = A\cdot B^{x}\))、累乗(\(y = A\cdot x^{B}\))、逆数(\(y = A + B/x\))、2次(\(y = A + B\cdot x + C\cdot x^{2}\))の中から選択できます。2次以外はすべて \(Y = a + b\cdot X\) の形に線形化したうえで通常の最小二乗法を適用し、2次回帰は\(3\times 3\)の正規方程式を解いて求めます。
使い方
x の値と y の値を、要素数をそろえてカンマ区切りで入力します。回帰の種類を選び、x から y を推定するか y から x を推定するかを指定し、わかっている入力値を入力してください。計算すると、各係数・相関係数r・推定値が表示されます。
計算式の解説
線形化した組(X, Y)について、\(b = S_{xy} / S_{xx}\)、\(a = \bar{Y} - b\cdot\bar{X}\) となります。ここで \(S_{xx} = \sum X^2 - n\bar{X}^2\)、\(S_{xy} = \sum XY - n\bar{X}\bar{Y}\) です。相関係数は $$r = \frac{S_{xy}}{\sqrt{S_{xx}\cdot S_{yy}}}$$ で求めます。求めた a・b は元の係数へ戻して計算します(たとえば指数モデルや累乗モデルでは \(A = e^{a}\) となります)。
計算例
\(x = [1,2,3,4,5,6,7]\)、\(y = [3,5,7,8,11,13,14]\) を線形回帰で当てはめると、\(S_{xx} = 28\)、\(S_{xy} = 53\) なので、\(B = 53/28 = 1.892857\)、\(A = 8.714286 - 1.892857\cdot 4 = 1.142857\) となります。相関係数は $$r = \frac{53}{\sqrt{28\cdot 101.4286}} = 0.99453$$ です。\(x = 64\) のときの y を推定すると \(1.142857 + 1.892857\cdot 64 = 122.2857\)(データの範囲を大きく超えた外挿)になります。
手順:手作業で曲線をあてはめる
- モデルを選ぶ。散布図の形状と、対象となるプロセスについての知見に基づき、直線、対数、指数(e形式またはab形式)、べき乗、逆数、または二次のいずれかを選ぶ。
- 定義域の制限を確認する。対数モデルはx > 0が必要である。指数モデルはy > 0が必要である。べき乗モデルはx > 0かつy > 0の両方が必要である。逆数モデルはx ≠ 0が必要である。いずれかのデータ点がこの条件を満たさない場合、そのモデルはデータにあてはめることができない。
- データを変換する。モデルの要求に応じて、xとyをXとYに置き換える:X = ln x、Y = ln y、またはX = 1/x。モデルがある変数を変換しない場合、その変数はそのままにする。
- 変換後のデータについて、和、平均、平方和を計算する(n個の点):
$$S_{xx}=\sum X^2-\frac{(\sum X)^2}{n},\quad S_{xy}=\sum XY-\frac{\sum X\,\sum Y}{n},\quad S_{yy}=\sum Y^2-\frac{(\sum Y)^2}{n}$$ および平均 \(\bar X=\sum X/n\)、\(\bar Y=\sum Y/n\)。 - 直線 \(Y = a + bX\) の傾きと切片を求める:
$$b=\frac{S_{xy}}{S_{xx}},\qquad a=\bar Y-b\,\bar X$$ - 元のパラメータに戻す。ab形式の指数モデルでは \(A=e^{a}\)、\(B=e^{b}\)。e形式の指数モデルおよびべき乗モデルでは \(A=e^{a}\)、\(B=b\)。対数モデルおよび逆数モデルでは \(A=a\)、\(B=b\)。
- 相関係数を計算する:
$$r=\frac{S_{xy}}{\sqrt{S_{xx}\,S_{yy}}}$$ これは変換後のデータについて計算する。 - 推定する。あてはめた式にxを代入する(例えば、べき乗のあてはめでは \(\hat y = A\,x^{B}\))。与えられたyからxを推定するには、式を変形し、その結果がモデルの定義域に含まれるかを確認する。
二次モデルの注記。二次式 \(\hat y = A + Bx + Cx^2\) は線形化しない。代わりに3×3の正規方程式を解く:
$$\begin{aligned}\sum y &= nA + B\sum x + C\sum x^2\\ \sum xy &= A\sum x + B\sum x^2 + C\sum x^3\\ \sum x^2y &= A\sum x^2 + B\sum x^3 + C\sum x^4\end{aligned}$$必要な和は、Σx、Σx²、Σx³、Σx⁴、Σy、Σxy、Σx²yである。連立方程式はクラメルの公式またはガウスの消去法で解く。異なるx値が少なくとも3つ必要である。
モデル別の線形化変換
| モデル | 方程式 | 変換後のX | 変換後のY | 線形形式 | 元のパラメータへの戻し(直線のa、b から) | 定義域の制限 |
|---|---|---|---|---|---|---|
| 直線 | \(y = A + Bx\) | x | y | \(y = a + bx\) | A = a、B = b | なし |
| 対数 | \(y = A + B\ln x\) | ln x | y | \(y = a + bX\) | A = a、B = b | x > 0 |
| 指数(e形式) | \(y = A e^{Bx}\) | x | ln y | \(\ln y = a + bx\) | A = ea、B = b | y > 0 |
| 指数(ab形式) | \(y = A B^{x}\) | x | ln y | \(\ln y = a + bx\) | A = ea、B = eb | y > 0 |
| べき乗 | \(y = A x^{B}\) | ln x | ln y | \(\ln y = a + bX\) | A = ea、B = b | x > 0かつy > 0 |
| 逆数 | \(y = A + B/x\) | 1/x | y | \(y = a + bX\) | A = a、B = b | x ≠ 0 |
| 二次 | \(y = A + Bx + Cx^2\) | 線形化なし | 3×3の正規方程式を解く | A、B、Cは解から直接得られる | なし(異なるx値が少なくとも3つ必要) | |
e形式とab形式の指数は同じ曲線族を表す:\(B_{ab}=e^{B_{e}}\)。両者は同じあてはめと同じrを与える。
rの解釈とモデルの選択
- 範囲と符号。rは−1から1の間にある。rが正であればYはXとともに増加する傾向があり、rが負であれば減少する傾向がある。|r|が1に近いほど、あてはめた形に対する適合が強いことを示し、|r|が0に近いほど適合が弱いことを示す。
- 変換したモデル。対数、指数、べき乗、逆数のあてはめでは、rは変換後のデータ(例えばln yとln xの関係)について計算される。したがって、元の尺度での直線あてはめのrと直接比較することはできない。rによってモデルを比較することは、あくまで大まかな目安にすぎない。
- r²(説明分散)。r²は、変換後のYの分散のうち、あてはめた直線によって説明される割合である。例えば、r = 0.90ならr² = 0.81となり、分散の約81%が説明される。
- 相関は因果ではない。rが高くても、一方の変数が他方の原因であることや、選んだモデルが真の関係であることを示すわけではない。同じデータに対して、異なる曲線がほぼ同程度によくあてはまることもある。
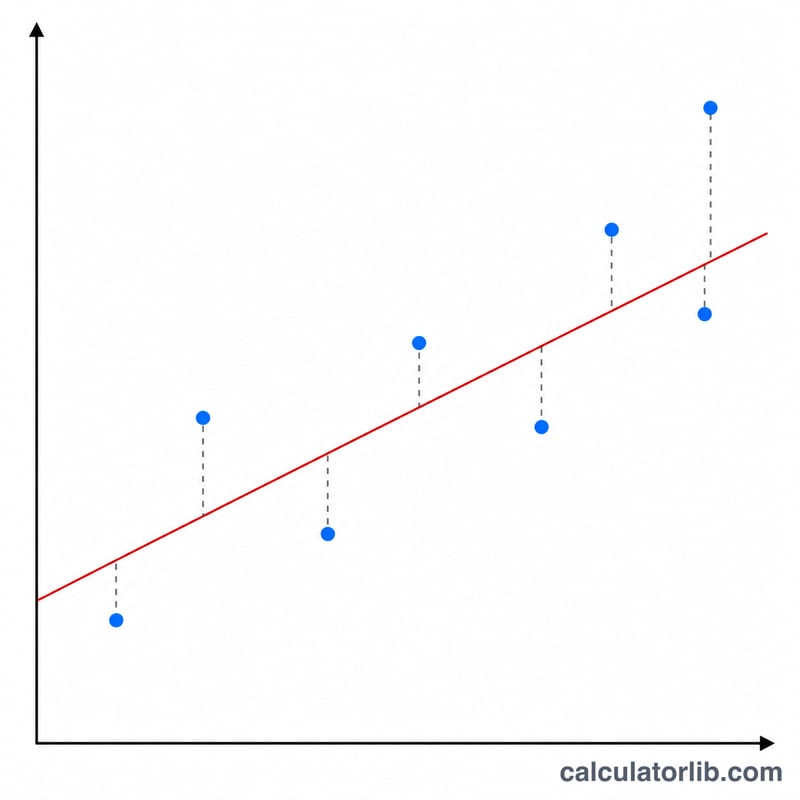
- 残差を確認する。観測値とあてはめ値の差をプロットする。差は0のまわりにランダムに散らばるはずである。曲線や漏斗型などの明確なパターンがあれば、rが高くてもそのモデルは不適切である。
- 外挿のリスク。xのデータの範囲内での推定(内挿)は、範囲外での推定(外挿)よりも通常はるかに信頼できる。指数、べき乗、二次の曲線は、データの範囲を超えると急激に発散することがある。
- 二次と直線の比較。二次式は、同じデータに対して直線モデルより少なくとも同程度によくあてはまる。パラメータが多く、直線モデルを特殊な場合(C = 0)として含むためである。したがって、あてはまりが良くなるだけでは追加の項を正当化できない。改善が意味のあるものであり、曲率がそのプロセスにとって妥当である場合を除き、より単純なモデルを優先する。
- 標本の大きさ。データ点が非常に少ない場合は、rが高くても偶然に生じることがある。実行可能な範囲で、できるだけ多くのデータを用いる。
よくある質問
相関係数rはどう読み取ればよい? 目安としては、\(0.7 < |r| \le 1\) で強い相関、\(0.4 < |r| < 0.7\) で中程度、\(0.2 < |r| < 0.4\) で弱い相関、0.2 未満ではほとんど相関なしと判断します。
選べないモデルがあるのはなぜ? 対数・累乗モデルは \(x > 0\)、指数・累乗モデルは \(y > 0\)、逆数モデルは \(x \ne 0\) が必要です。対数や逆数の変換を含むためで、条件を満たさないデータでは計算できません。
データ範囲の外も推定できる? できますが、観測データの範囲外の値は外挿となるため、結果の扱いには注意が必要です。