¿Qué es la calculadora de cuadratura gaussiana?
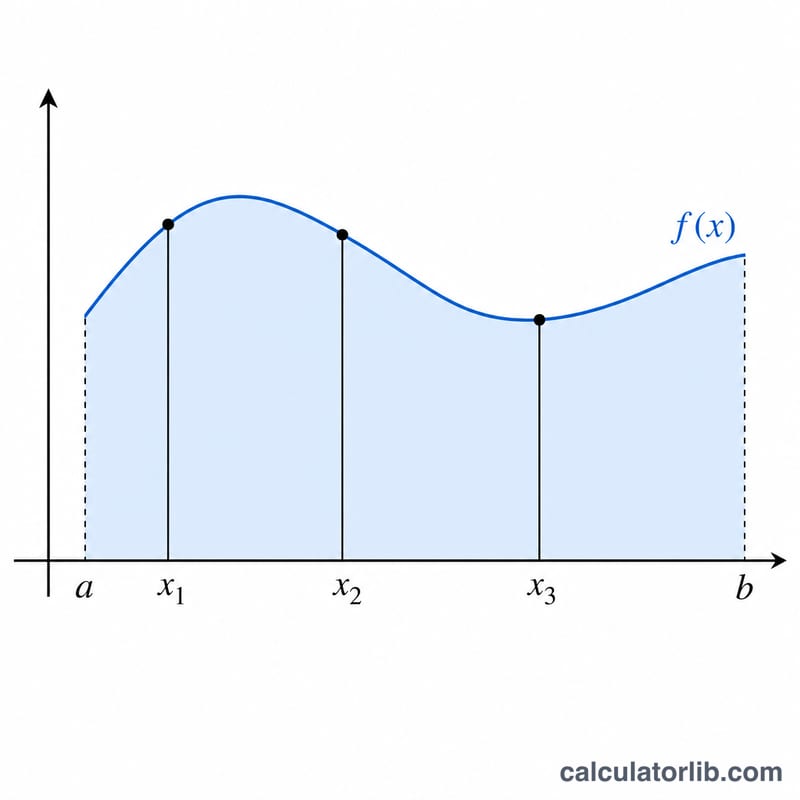
Es una herramienta de matemática pura (funciona exactamente igual en cualquier país) que aproxima numéricamente una integral definida mediante la regla de cuadratura gaussiana que elijas. La cuadratura gaussiana evalúa el integrando en un pequeño conjunto de puntos elegidos con astucia, llamados nodos, multiplica cada valor por un peso correspondiente y los suma. Con \(n\) puntos integra de forma exacta polinomios de hasta grado \(2n-1\), lo que la hace mucho más precisa que los métodos de puntos equiespaciados —como la regla del trapecio o la de Simpson— cuando la función es suave.
Cómo usarla
Elige un método de cuadratura, fija el número de puntos \(n\), escribe el integrando \(f(x)\) con la sintaxis habitual (+ - * / ^, paréntesis, sin, cos, tan, exp, log, ln, sqrt, abs, pi, e) y, en las reglas finitas, indica los límites \(a\) y \(b\). La función de peso \(w(x)\) ya está incorporada en cada regla, así que introduce solo la parte suave \(f(x)\): en Gauss-Laguerre omite el factor \(x^{\alpha} e^{-x}\), en Gauss-Hermite omite \(e^{-x^2}\), y en Chebyshev/Jacobi omite el peso \((1-x^2)\). El menú de cifras significativas solo cambia cuántos dígitos se muestran.
La fórmula
Todas las reglas tienen la misma forma: la integral de \(w(x) f(x)\) sobre el intervalo canónico se aproxima por la suma de \(w_i\) por \(f(x_i)\), donde los nodos \(x_i\) son las raíces del polinomio ortogonal correspondiente y los \(w_i\) son los pesos de Golub-Welsch. Para un intervalo finito arbitrario \([a,b]\) con peso 1, los nodos canónicos \(t_i\) en \([-1,1]\) se transforman mediante $$x_i = \frac{b-a}{2} t_i + \frac{a+b}{2}$$ y toda la suma se escala por \(\frac{b-a}{2}\).
Ejemplo resuelto
Elige Gauss-Legendre, \(n=20\), \(f(x)=\frac{4}{1+x^2}\), \(a=0\), \(b=1\). El valor exacto es \(4\arctan(1) = \pi = 3.14159265358979\). La regla de Legendre con 20 puntos transforma los nodos a \([0,1]\), escala los pesos por \(\frac{1}{2}\) y devuelve \(3.141592653589793\), que coincide con \(\pi\) en toda la precisión doble. Por eso \(\frac{4}{1+x^2}\) es el integrando predeterminado.
Ejemplo de nodos y pesos para n pequeño (Gauss-Legendre)
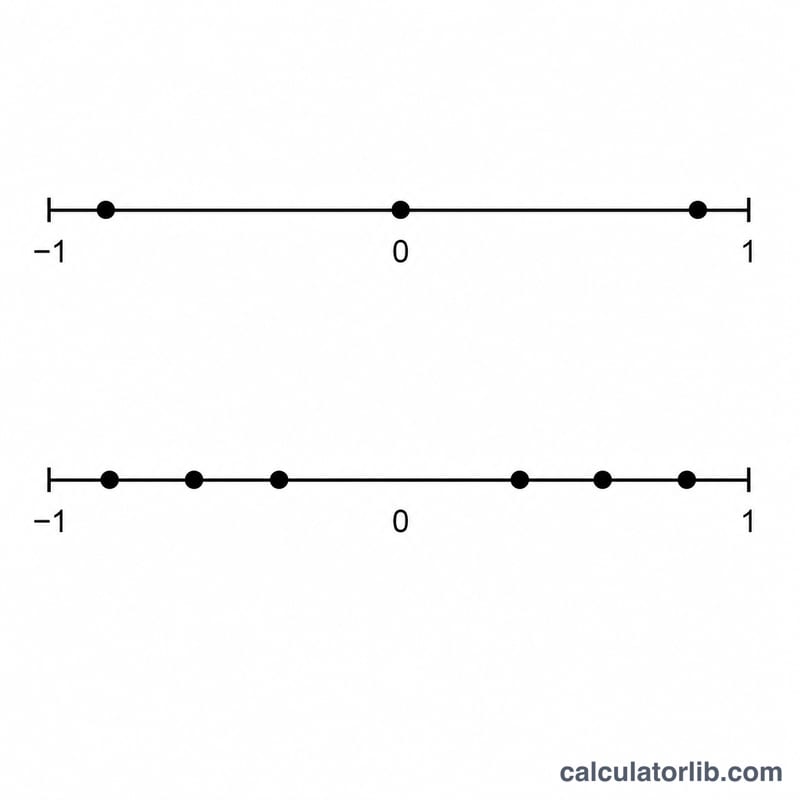
La tabla muestra los nodos de Gauss-Legendre \(x_i\) y los pesos \(w_i\) en el intervalo estándar \([-1,1]\). Para un intervalo general \([a,b]\), la calculadora transforma cada nodo con \(t_i = \frac{b-a}{2}x_i + \frac{a+b}{2}\) y multiplica la suma por \(\frac{b-a}{2}\). Los nodos aparecen en pares simétricos ± y cada par comparte un mismo peso.
| n | Nodos \(x_i\) | Pesos \(w_i\) |
|---|---|---|
| 1 | 0 | 2 |
| 2 | ±0.5773502692 | 1 (cada uno) |
| 3 | 0 ±0.7745966692 |
0.8888888889 0.5555555556 |
| 4 | ±0.3399810436 ±0.8611363116 |
0.6521451549 0.3478548451 |
| 5 | 0 ±0.5384693101 ±0.9061798459 |
0.5688888889 0.4786286705 0.2369268851 |
Para todo n, los pesos suman 2, que es la longitud de \([-1,1]\). Es una comprobación rápida: para n=5, \(0.5688888889 + 2(0.4786286705) + 2(0.2369268851) \approx 2\).
Comprobación rápida con n=2 sobre \(\int_{-1}^{1}(x^3+x^2)\,dx = \frac{2}{3}\): la suma es \(1\cdot f(-0.57735) + 1\cdot f(0.57735)\). El término impar se cancela y los dos términos \(x^2\) dan \(\frac{1}{3}+\frac{1}{3}=\frac{2}{3}\), que es exacto porque el polinomio tiene grado 3 = 2n-1.
Interpretación del resultado y precisión
- Exactitud para polinomios: una regla de Gauss-Legendre de n puntos integra de forma exacta polinomios de hasta grado \(2n-1\). Por ejemplo, 3 puntos son exactos hasta grado 5.
- Reglas de Lobatto: incluyen ambos extremos como nodos, por lo que pierden algo de precisión. Una regla de Gauss-Lobatto de n puntos es exacta hasta grado \(2n-3\).
- Integrandos suaves: para funciones analíticas (infinitamente derivables), el error suele disminuir muy rápido al aumentar n, a menudo en varios órdenes de magnitud por cada punto añadido.
- Integrandos problemáticos: la convergencia es lenta o poco fiable en singularidades, explosiones en los extremos, discontinuidades, esquinas y funciones muy oscilantes. Dividir el intervalo en esos puntos, o usar una regla ponderada (Chebyshev, Jacobi, Laguerre, Hermite) que coincida con el peso o la singularidad, suele ayudar.
- Comprobación aumentando n: ejecute el cálculo con n y con un n mayor. Si las primeras cifras coinciden, el resultado probablemente ha convergido hasta aproximadamente ese número de cifras. Si siguen cambiando, el integrando no se adapta bien a la regla con ese n. Una extensión de Kronrod ofrece una estimación de error integrada al compararla con la regla de Gauss incrustada.
- Ajuste de cifras significativas: esto solo cambia cuántos dígitos se muestran. No modifica los nodos, los pesos ni la precisión real de la aproximación.
- Límites de precisión: en doble precisión estándar hay disponibles unas 15-16 cifras significativas. Los dígitos solicitados más allá de eso no son significativos, salvo que la calculadora use aritmética de mayor precisión. La cancelación (contribuciones positivas y negativas que casi se anulan) y el redondeo en las sumas de nodos y pesos pueden reducir aún más los dígitos fiables.
- Cuándo dividir el intervalo: use paneles compuestos, es decir, reglas de Gauss separadas en subintervalos, cuando la función cambia de comportamiento a lo largo del rango, oscila muchas veces o tiene un punto problemático conocido. Coloque el punto problemático en el límite de un subintervalo.
Las reglas ponderadas resuelven un problema distinto: Laguerre aborda \(\int_0^\infty e^{-x}f(x)\,dx\), Hermite aborda \(\int_{-\infty}^{\infty} e^{-x^2}f(x)\,dx\), y las reglas de Chebyshev incluyen los pesos \(1/\sqrt{1-x^2}\) o \(\sqrt{1-x^2}\). Asegúrese de que el integrando que introduce coincida con la convención de peso del método seleccionado.
Preguntas frecuentes
¿Por qué mi resultado parece incorrecto con Laguerre o Hermite? Esas reglas ya incluyen el peso \(e^{-x}\) o \(e^{-x^2}\); introduce solo el factor restante, no el integrando completo. Por ejemplo, para obtener la integral de \(e^{-x^2}\) sobre toda la recta, pon \(f(x)=1\), lo que da \(\sqrt{\pi}\).
¿Qué hacen \(\alpha\) y \(\beta\)? \(\alpha\) es el exponente del peso de Laguerre \(x^{\alpha}\) y uno de los exponentes de Jacobi; \(\beta\) es el otro exponente de Jacobi. Ambos deben ser mayores que \(-1\), o la integral del peso diverge.
¿Más puntos siempre ayudan? En funciones suaves, un \(n\) mayor mejora la precisión, pero en funciones con singularidades o picos pronunciados dentro del intervalo puede empeorarla. Aumenta \(n\) de forma gradual y vigila la convergencia.