F分布のパーセント点とは
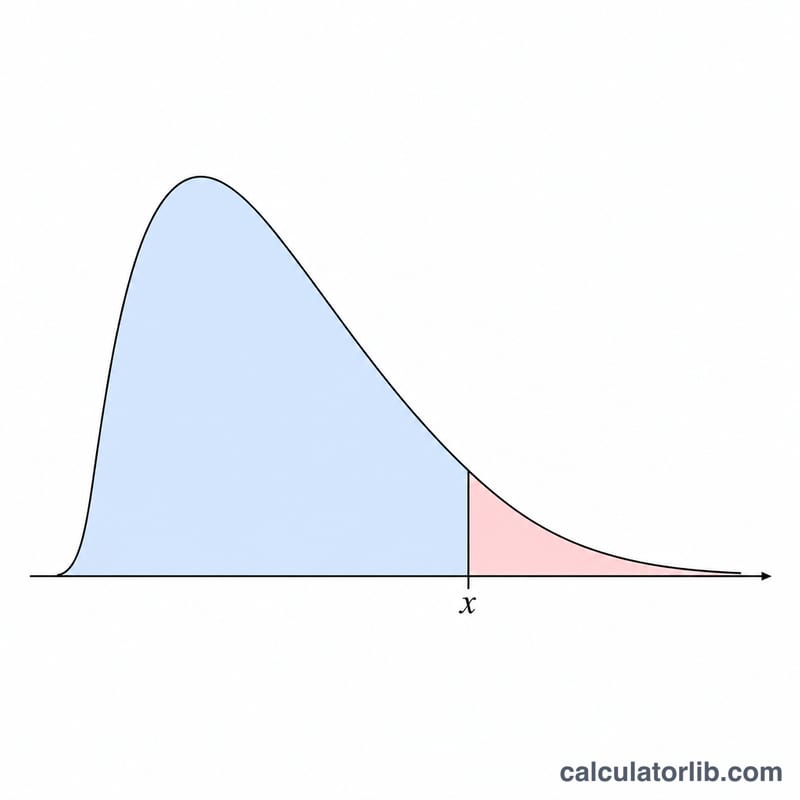
F分布のパーセント点(逆F・分位点・棄却限界値とも呼ばれます)とは、分子自由度d1・分母自由度d2を持つF分布の累積確率が指定した値になるような x のことです。これはF分布の累積分布関数(CDF)の逆関数にあたり、分散分析(ANOVA)や回帰モデル全体の有意性検定、分散比(等分散性)の検定で、F分布表から読み取る臨界値そのものを表します。
計算機の使い方
まず累積モードを選びます。確率が \( P = \Pr(F \le x) \) で与えられる場合は 下側累積 P を選択してください。たとえば P = 0.95 とすると、分布全体の95%がその値より下に収まる x が求まります。上側の確率 \( Q = \Pr(F > x) \) を扱う場合は 上側累積 Q を選びます。たとえば Q = 0.05 なら、よく使われる上側5%の臨界値が得られます。続いて確率(0より大きく1より小さい値)、分子自由度 d1、分母自由度 d2 を入力し、計算を実行します。
計算式の解説
F分布のCDFは、正規化不完全ベータ関数 I を用いて表されます。\( a = d_1/2 \)、\( b = d_2/2 \) とし、\( w = \frac{d_1 x}{d_1 x + d_2} \) と置き換えると、 $$\text{F-CDF}(x) = I_w(a, b)$$ となります。逆関数を求めるため、この計算機は \( I_w(a, b) = \text{targetP} \) を満たす w を区間 (0, 1) 上の二分法で解きます。\( I_w \) の評価には Lanczos 近似による対数ガンマ関数と、Numerical Recipes に基づく連分数展開を用います。求めた w を $$x = \frac{d_2 w}{d_1 (1 - w)}$$ に代入して x を逆算します。上側モードの場合、目標確率は \( \text{targetP} = 1 - Q \) となります。
計算例
P = 0.95、d1 = 5、d2 = 10 の場合、上側5%のF臨界値を求めます。\( a = 2.5 \)、\( b = 5 \) として \( I_w(2.5, 5) = 0.95 \) を逆算すると \( w \approx 0.6245 \) となり、 $$x = \frac{10 \times 0.6245}{5 \times 0.3755} \approx 3.3258$$ が得られます。これは表に載っている \( F_{0.05}(5, 10) = 3.3258 \) と一致します。
F臨界値表(上側5%水準)
この表は上側の臨界値 \(F_{0.05}(d_1, d_2)\)(F分布の右側に5%の確率がある点)を示します。これは上側確率 \(Q = 0.05\) に対応するので、下側確率は \(P = 0.95\) です。値を再現するには、P = 0.95(または Q = 0.05)と、分子の自由度 \(d_1\)、分母の自由度 \(d_2\) を入力します。列は \(d_1\)(分子)、行は \(d_2\)(分母)を表します。値は小数点以下4桁に四捨五入しています。
| d2 \ d1 | 1 | 2 | 3 | 4 | 5 | 6 | 8 | 10 | 12 |
|---|---|---|---|---|---|---|---|---|---|
| 5 | 6.6079 | 5.7861 | 5.4095 | 5.1922 | 5.0503 | 4.9503 | 4.8183 | 4.7351 | 4.6777 |
| 10 | 4.9646 | 4.1028 | 3.7083 | 3.4780 | 3.3258 | 3.2172 | 3.0717 | 2.9782 | 2.9130 |
| 15 | 4.5431 | 3.6823 | 3.2874 | 3.0556 | 2.9013 | 2.7905 | 2.6408 | 2.5437 | 2.4753 |
| 20 | 4.3513 | 3.4928 | 3.0984 | 2.8661 | 2.7109 | 2.5990 | 2.4471 | 2.3479 | 2.2776 |
| 30 | 4.1709 | 3.3158 | 2.9223 | 2.6896 | 2.5336 | 2.4205 | 2.2662 | 2.1646 | 2.0921 |
| 60 | 4.0012 | 3.1504 | 2.7581 | 2.5252 | 2.3683 | 2.2541 | 2.0970 | 1.9926 | 1.9174 |
| 120 | 3.9201 | 3.0718 | 2.6802 | 2.4472 | 2.2899 | 2.1750 | 2.0164 | 1.9105 | 1.8337 |
| ∞ | 3.8415 | 2.9957 | 2.6049 | 2.3719 | 2.2141 | 2.0986 | 1.9384 | 1.8307 | 1.7522 |
読み取り例:\(F_{0.05}(5,10) = 3.3258\)、\(F_{0.05}(1,10) = 4.9646\)、\(F_{0.05}(2,10) = 4.1028\)。∞行は \(\chi^2_{0.05}(d_1)/d_1\) に等しく、\(d_1 = 1\) の場合は \(1.96^2 = 3.8415\) です。
臨界値の解釈
右側検定。 分散分析(ANOVA)および回帰のF検定では、帰無仮説 \(H_0\) は有意水準 \(\alpha\) において、観測された統計量が上側臨界値を超えたときに棄却されます:
$$F_{\text{観測}} > F_{\alpha}(d_1, d_2) \;\Rightarrow\; \text{\text{棄却}} H_0.$$
ここで \(d_1\) は分子の自由度(例:一元配置分散分析では群の数から1を引いた値)で、\(d_2\) は分母の自由度(例:残差の自由度)です。
PとQ。 計算機は下側確率 \(P = \Pr(F \le x)\) または上側確率 \(Q = \Pr(F > x)\) を受け付け、\(P = 1 - Q\) です。有意水準は上側に直接対応し、\(\alpha = Q\) となるので、5%検定では \(Q = 0.05\)、すなわち \(P = 0.95\) を用います。
両側分散比検定。 2つの分散が等しいかを両側対立仮説に対して検定するには、有意水準を分割し、2つの臨界値 \(F_{\alpha/2}(d_1, d_2)\)(上側)と \(F_{1-\alpha/2}(d_1, d_2)\)(下側)を用います。比が上側の値より大きいか、下側の値より小さい場合に \(H_0\) を棄却します。下側の値は次の逆数の関係から求められます:
$$F_{1-\alpha}(d_1, d_2) = \frac{1}{F_{\alpha}(d_2, d_1)}.$$
自由度が入れ替わる点に注意してください。例えば表から \(F_{0.05}(10, 5) = 4.7351\) なので、\(F_{0.95}(5, 10) = 1/4.7351 \approx 0.2112\) です。
\(d_2\) が大きくなるときの振る舞い。 分母の推定値がより精密になるため、表の各列は \(d_2\) の増加とともに減少します。\(d_2 \to \infty\) のとき、臨界値は \(\chi^2_{\alpha}(d_1)/d_1\) に近づきます。表の∞行はこの極限を示します。
形状。 F分布は \(x > 0\) の範囲でのみ定義され、特に自由度が小さいとき右に裾を長く引く分布です。そのため下側と上側の臨界値は1を中心に対称にならず、下側の値を求めるには逆数の関係が必要になります。
よくある質問
P と Q の違いは何ですか? P は x までの下側(累積)確率、Q は x を超える上側確率です。両者には \( P = 1 - Q \) の関係があります。
なぜ確率は0より大きく1より小さくなければならないのですか? 確率0は分位点 x = 0 に、確率1は x → 無限大に対応し、いずれも有限で意味のある臨界値にはならないためです。
自由度は整数でなくてもよいですか? はい。計算式は正の実数 d1・d2 すべてに対して成り立ちます。ただし分散分析(ANOVA)では通常、整数を用います。