什麼是 F 分配的百分位點?
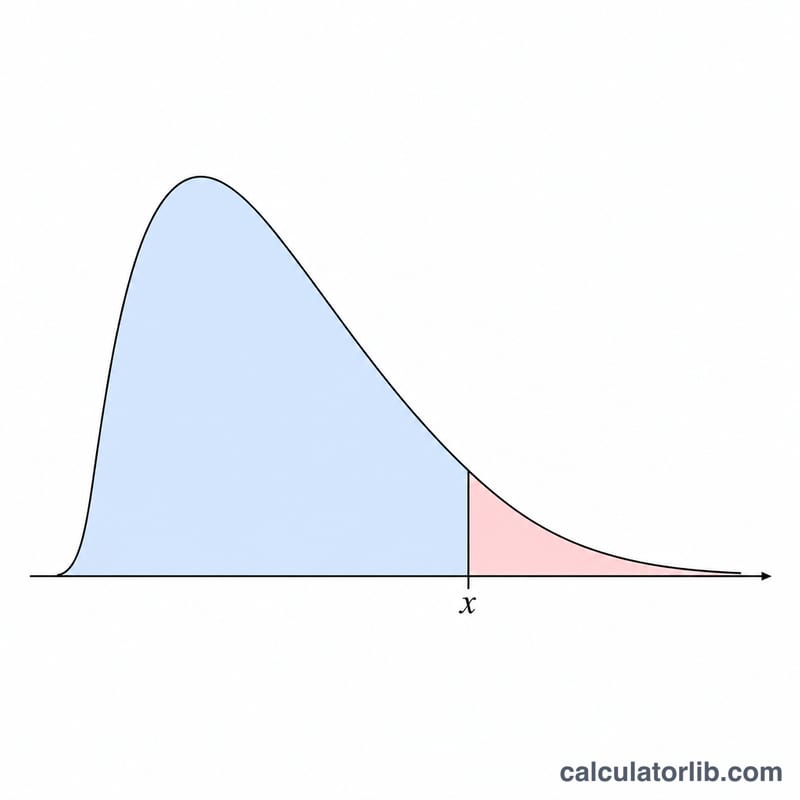
F 分配的百分位點(又稱 F 反函數、分位數或臨界值)是指這樣一個數值 x:當分子自由度為 d1、分母自由度為 d2 時,F 分配的累積機率恰好等於你所指定的機率。它就是 F 分配累積分配函數(CDF)的反函數,也正是你在 F 分配表中查找的臨界值——廣泛用於變異數分析(ANOVA)、迴歸整體顯著性檢定,以及變異數比(檢定兩組變異數是否相等)的檢定。
計算器使用方式
先選擇累積機率的模式。如果你手上的機率是 \(P = \Pr(F \le x)\),請選擇 左尾累積 P——例如 \(P = 0.95\) 會回傳「整個分配有 95% 落在其下方」的那個數值。如果你掌握的是尾端機率 \(Q = \Pr(F > x)\),則選擇 右尾累積 Q——例如 \(Q = 0.05\) 會回傳常見的上側 5% 臨界值。接著輸入機率(必須嚴格介於 0 與 1 之間)、分子自由度 \(d_1\) 與分母自由度 \(d_2\),再送出即可。
公式說明
F 分配的累積分配函數可用正則化不完全 Beta 函數 \(I\) 來表示:令 \(a = d_1/2\)、\(b = d_2/2\),並代入 \(w = d_1 \cdot x / (d_1 \cdot x + d_2)\),則 \(\text{F-CDF}(x) = I_w(a, b)\)。為了求其反函數,本計算器在區間 \((0, 1)\) 上以二分法求解 $$F_p = \{\, x : I_{\frac{d_1 x}{d_1 x + d_2}}\!\left(\tfrac{d_1}{2},\tfrac{d_2}{2}\right) = \text{P} \,\}$$ 中的 \(w\),並透過 Lanczos 對數 Gamma 函數搭配《Numerical Recipes》的連分數法來計算 \(I_w\)。求得 \(w\) 後,再反代回 \(x = d_2 \cdot w / (d_1 \cdot (1 - w))\)。在右尾模式下,目標機率則為 \(\text{targetP} = 1 - Q\)。
實例演算
以 \(P = 0.95\)、\(d_1 = 5\)、\(d_2 = 10\) 為例,我們要找的是上側 5% 的 F 臨界值。代入 \(a = 2.5\)、\(b = 5\),求解 \(I_w(2.5, 5) = 0.95\) 可得 \(w \approx 0.6245\),再算出 $$x = \frac{10 \times 0.6245}{5 \times 0.3755} \approx 3.3258$$ 與 F 分配表中 \(F_{0.05}(5, 10) = 3.3258\) 完全吻合。
F 臨界值表(上側 5% 水準)
本表列出上尾臨界值 \(F_{0.05}(d_1, d_2)\),即 F 分布右側面積為 5% 的點。這些數值對應上尾機率 \(Q = 0.05\),因此下尾機率為 \(P = 0.95\)。若要查得某個數值,請輸入 P = 0.95(或 Q = 0.05),並輸入分子自由度 \(d_1\) 與分母自由度 \(d_2\)。欄為 \(d_1\)(分子),列為 \(d_2\)(分母)。數值四捨五入至小數點後 4 位。
| d2 \ d1 | 1 | 2 | 3 | 4 | 5 | 6 | 8 | 10 | 12 |
|---|---|---|---|---|---|---|---|---|---|
| 5 | 6.6079 | 5.7861 | 5.4095 | 5.1922 | 5.0503 | 4.9503 | 4.8183 | 4.7351 | 4.6777 |
| 10 | 4.9646 | 4.1028 | 3.7083 | 3.4780 | 3.3258 | 3.2172 | 3.0717 | 2.9782 | 2.9130 |
| 15 | 4.5431 | 3.6823 | 3.2874 | 3.0556 | 2.9013 | 2.7905 | 2.6408 | 2.5437 | 2.4753 |
| 20 | 4.3513 | 3.4928 | 3.0984 | 2.8661 | 2.7109 | 2.5990 | 2.4471 | 2.3479 | 2.2776 |
| 30 | 4.1709 | 3.3158 | 2.9223 | 2.6896 | 2.5336 | 2.4205 | 2.2662 | 2.1646 | 2.0921 |
| 60 | 4.0012 | 3.1504 | 2.7581 | 2.5252 | 2.3683 | 2.2541 | 2.0970 | 1.9926 | 1.9174 |
| 120 | 3.9201 | 3.0718 | 2.6802 | 2.4472 | 2.2899 | 2.1750 | 2.0164 | 1.9105 | 1.8337 |
| ∞ | 3.8415 | 2.9957 | 2.6049 | 2.3719 | 2.2141 | 2.0986 | 1.9384 | 1.8307 | 1.7522 |
範例讀數:\(F_{0.05}(5,10) = 3.3258\)、\(F_{0.05}(1,10) = 4.9646\) 與 \(F_{0.05}(2,10) = 4.1028\)。∞ 列等於 \(\chi^2_{0.05}(d_1)/d_1\);當 \(d_1 = 1\) 時,此值為 \(1.96^2 = 3.8415\)。
臨界值的解讀
右尾檢定。在 ANOVA 與迴歸 F 檢定中,當觀測統計量超過上尾臨界值時,在顯著水準 \(\alpha\) 下拒絕虛無假設 \(H_0\):
$$F_{\text{obs}} > F_{\alpha}(d_1, d_2) \;\Rightarrow\; \text{拒絕 } H_0.$$
此處 \(d_1\) 為分子自由度(例如單因子 ANOVA 中,組數減 1),\(d_2\) 為分母自由度(例如殘差自由度)。
P 與 Q。計算機接受下尾機率 \(P = \Pr(F \le x)\) 或上尾機率 \(Q = \Pr(F > x)\),且 \(P = 1 - Q\)。顯著水準直接對應上尾,即 \(\alpha = Q\),因此 5% 檢定使用 \(Q = 0.05\),亦即 \(P = 0.95\)。
雙邊變異數比檢定。要檢定兩個變異數是否相等(對立假設為雙邊),需將顯著水準一分為二,並使用兩個臨界值:上側 \(F_{\alpha/2}(d_1, d_2)\) 與下側 \(F_{1-\alpha/2}(d_1, d_2)\)。若比值高於上臨界值或低於下臨界值,則拒絕 \(H_0\)。下臨界值可由倒數恆等式求得:
$$F_{1-\alpha}(d_1, d_2) = \frac{1}{F_{\alpha}(d_2, d_1)}.$$
請注意自由度會互換。例如由表中可知 \(F_{0.05}(10, 5) = 4.7351\),因此 \(F_{0.95}(5, 10) = 1/4.7351 \approx 0.2112\)。
\(d_2\) 增大時的變化。表中每一欄的數值都隨 \(d_2\) 增加而遞減,因為分母的估計變得更精確。當 \(d_2 \to \infty\) 時,臨界值趨近於 \(\chi^2_{\alpha}(d_1)/d_1\)。表中的 ∞ 列即顯示此極限值。
分布形狀。F 分布僅定義於 \(x > 0\),且呈右偏,自由度較小時尤其明顯。這就是為何下尾與上尾臨界值並非以 1 為中心對稱,也因此下尾必須使用倒數恆等式。
常見問題
P 與 Q 有什麼差別?\(P\) 是直到 \(x\) 為止的左尾(累積)機率;\(Q\) 則是超過 \(x\) 之後的右尾機率。兩者的關係為 \(P = 1 - Q\)。
為什麼機率必須嚴格介於 0 與 1 之間?機率為 0 對應分位數 \(x = 0\),機率為 1 則對應 \(x\) 趨近無限大,兩者都不是有限且有意義的臨界值。
自由度可以不是整數嗎?可以——這套數學對任何正實數 \(d_1\) 與 \(d_2\) 都成立,只是在 ANOVA 應用中通常會使用整數。