什麼是 Cohen's d?
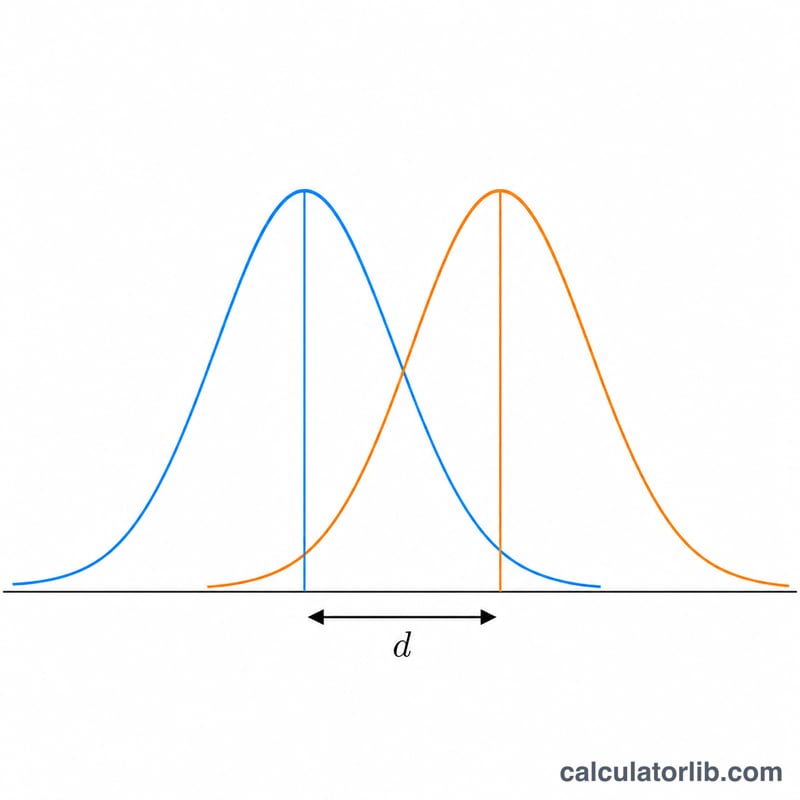
Cohen's d 是一種標準化的效應量指標,它以標準差為單位,表達兩組平均數之間的差異有多大。在心理學、教育與醫學研究中被廣泛使用,能夠在不受樣本數影響的情況下,量化差異的幅度。和只能告訴你差異「是否達到統計顯著」的 p 值不同,Cohen's d 告訴你這個差異「實際上有多大意義」。
如何使用這個計算器
分別輸入兩組資料的平均數、標準差與樣本數。計算器會先算出合併標準差,再以兩組平均數的差除以它,得到 Cohen's d。系統還會依照 Cohen 提出的慣用基準,將結果歸類為可忽略、小、中或大效應。
公式說明
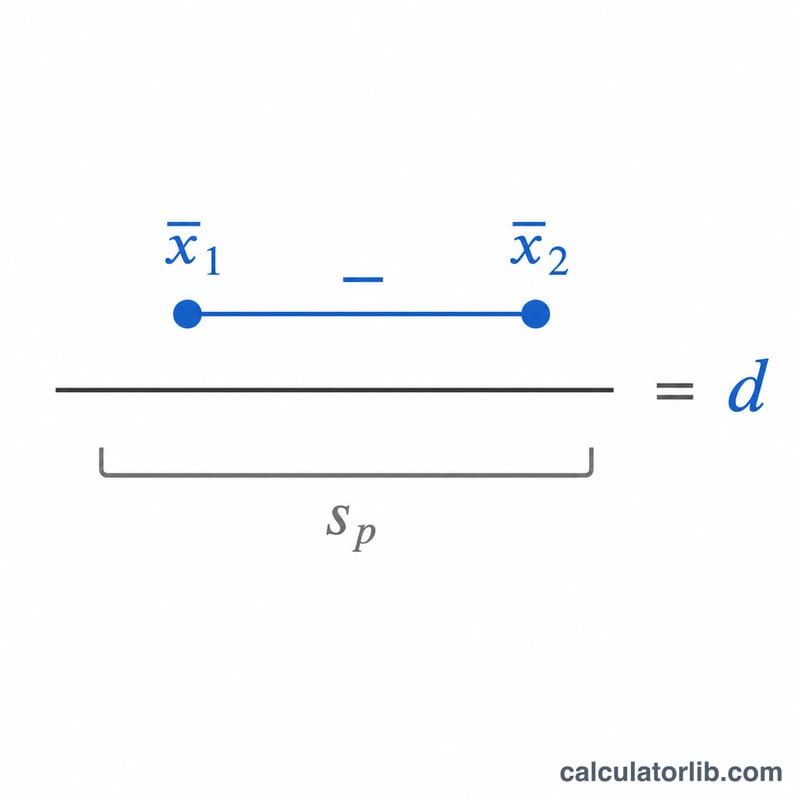
效應量的計算為 $$d = \frac{\bar{x}_1 - \bar{x}_2}{s_p}$$ 合併標準差為 $$s_p = \sqrt{\frac{(n_1-1)\cdot s_1^2 + (n_2-1)\cdot s_2^2}{n_1 + n_2 - 2}}$$ 這個算式會依各組的自由度為其變異數加權,整合成單一的整體離散程度,用來標準化平均數的差異。
實例演算
假設第 1 組的平均數為 100、標準差為 10、樣本數 \(n\) 為 30;第 2 組的平均數為 90、標準差為 12、樣本數 \(n\) 為 30。合併變異數為 $$\frac{(29\cdot 100)+(29\cdot 144)}{58} = \frac{2900+4176}{58} = 122$$ 因此 $$s_p = \sqrt{122} \approx 11.0454,\quad d = \frac{100-90}{11.0454} \approx 0.905$$ —— 屬於大效應。
Cohen's d 基準與重疊參考
Cohen's d 以合併標準差為單位,表示兩組平均數之間的差異。Cohen (1988) 建議以 0.2、0.5 和 0.8 作為小、中、大效應的粗略標籤。Sawilowsky (2009) later 後來新增了 1.2(非常大)與 2.0(極大)。下方的重疊數值假設兩個常態分佈具有相等變異數,並由 d 計算得出。
| 科恩 d 值 | 標籤 | 分佈重疊(OVL) | Cohen's U3(第 2 組中低於第 1 組平均數的比例) | 優勢機率 |
|---|---|---|---|---|
| 0.2 | 小 | ≈ 92.0% | ≈ 57.9% | ≈ 55.6% |
| 0.5 | 中 | ≈ 80.3% | ≈ 69.1% | ≈ 63.8% |
| 0.8 | 大 | ≈ 68.9% | ≈ 78.8% | ≈ 71.4% |
| 1.2 | 非常大 | ≈ 54.9% | ≈ 88.5% | ≈ 80.2% |
| 2.0 | 極大 | ≈ 31.7% | ≈ 97.7% | ≈ 92.1% |
表中的公式為 \(\text{OVL} = 2\,\Phi(-d/2)\)、\(U_3 = \Phi(d)\),以及優勢機率 \(= \Phi(d/\sqrt{2})\),其中 \(\Phi\) 為標準常態累積分布函數。
- |d| 低於 0.2 的數值通常被描述為可忽略。
- Cohen 將這些基準描述為在沒有更好的特定領域參考時使用的粗略慣例。它們並非嚴格的分界點,d 為 0.49 與 0.50 在意義上並無明顯差異。
解讀你的 Cohen's d 結果
d 以標準差為單位。 d 為 0.5 表示兩組平均數相差半個合併標準差。d 為 1.0 表示相差一個完整的合併標準差。
正負號與大小。 正負號只表示哪一組平均數較高。以 \(\text{Mean}_1 - \text{Mean}_2\) 計算時,正的 d 表示第 1 組較高,負的 d 表示第 2 組較高。效應大小為絕對值 |d|,小、中、大的標籤即是指此數值。
效應量不等於統計顯著性。 p 值高度取決於樣本數。極小的 d 在數千名參與者時可能達到「顯著」,而很大的 d 在樣本很少時可能不顯著。Cohen's d 不會隨 n 增大,它描述的是差異有多大,而不是你對其存在有多確定。同時報告 d 的信賴區間是良好做法。
情境很重要。 0.2、0.5 和 0.8 這些標籤是通用的。在某些領域,例如教育或醫學,當結果容易改變或影響許多人時,0.2 的 d 也可能很重要。在嚴格控制的實驗室研究中,0.2 可能並不引人注意。請將你的 d 與你所在領域報告的效應做比較,並判斷其實際影響。
小樣本偏誤。 當樣本較小時,Cohen's d 會略微高估母體效應。Hedges' g 可大致校正此偏誤:
$$g \approx d \times \left(1 - \frac{3}{4(n_1 + n_2) - 9}\right)$$
例如,當 \(n_1 + n_2 = 80\) 時,校正因子為 \(1 - 3/311 \approx 0.990\),因此 d 為 0.53 時 g 約為 0.53。校正主要在總樣本數低於約 20 至 50 時才有影響。
合併標準差的假設。
- 兩個母體的變異數大致相等。若標準差差異很大,合併標準差可能會產生誤導,此時使用以對照組標準差為基準的 Glass's Δ 等替代方法可能較為合適。
- 資料近似常態。嚴重偏態或離群值會同時扭曲平均數與標準差,參考表中的重疊百分比將不再完全成立。
- 各組彼此獨立。對於成對或重複測量設計,需要使用不同的效應量公式。
情境比較:輸入值如何改變 d
每一列都使用合併標準差 \(s_p = \sqrt{\dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}}\) 與 \(d = (\text{Mean}_1 - \text{Mean}_2)/s_p\)。分類依據 Cohen 的慣例。
| 情境 | 第 1 組(平均數、標準差、n) | 第 2 組(平均數、標準差、n) | 合併標準差 | d | 分類 |
|---|---|---|---|---|---|
| A. 基準 | 105, 15, 30 | 100, 15, 30 | 15.00 | 0.33 | 小 |
| B. 差異相同(5),標準差較大 | 105, 25, 30 | 100, 25, 30 | 25.00 | 0.20 | 小 |
| C. d 與 A 相同,樣本數較大 | 105, 15, 100 | 100, 15, 100 | 15.00 | 0.33 | 小 |
| D. n 與標準差皆不相等 | 82, 10, 20 | 75, 14, 60 | 13.14 | 0.53 | 中 |
| E. 差距較大,標準差相近 | 78, 8, 25 | 70, 10, 25 | 9.06 | 0.88 | 大 |
計算驗證
情境 D: $$s_p = \sqrt{\frac{19(10^2) + 59(14^2)}{20 + 60 - 2}} = \sqrt{\frac{1900 + 11564}{78}} = \sqrt{172.62} \approx 13.14$$ $$d = \frac{82 - 75}{13.14} \approx 0.53$$
情境 E: $$s_p = \sqrt{\frac{24(8^2) + 24(10^2)}{48}} = \sqrt{\frac{1536 + 2400}{48}} = \sqrt{82} \approx 9.06$$ $$d = \frac{78 - 70}{9.06} \approx 0.88$$
比較結果說明
- A 與 B:兩者的原始平均數差都是 5,但 B 較大的離散程度使 d 從 0.33 降至 0.20。
- A 與 C:樣本數不會改變 d,只有平均數與標準差會。較大的 n 會使估計更精確,結果也更可能達到統計顯著。
- D:當 n 不相等時,合併標準差會偏向較大組的標準差,因此它較接近 14 而非 10。
常見問題
多大才算大效應?依照 Cohen 的經驗法則,0.2 為小效應、0.5 為中效應、0.8 以上為大效應。
d 值可以是負數嗎?可以。負值只是代表第 2 組的平均數高於第 1 組。判斷效應大小時,看的是其絕對值(幅度)。
兩組的樣本數一定要相等嗎?不需要。合併公式會依自由度加權,因此即使兩組樣本數不同,也能正確處理。