코헨의 d란?
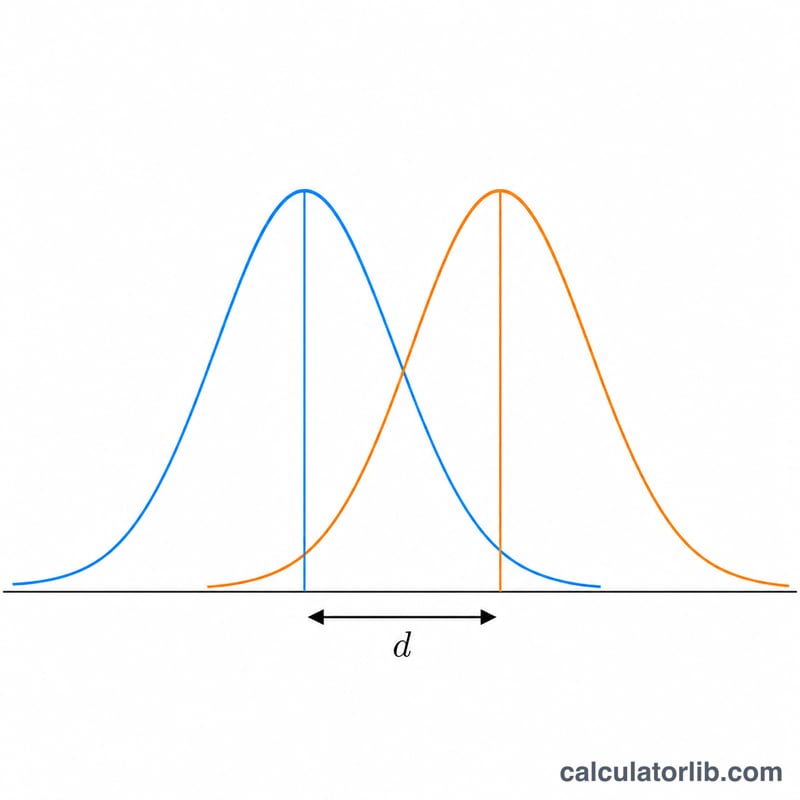
코헨의 d(Cohen's d)는 두 집단 평균의 차이를 표준편차 단위로 나타내는 표준화된 효과크기 지표입니다. 심리학, 교육학, 의학 등 다양한 분야에서 표본 크기와 무관하게 '차이가 얼마나 큰가'를 정량화하는 데 널리 쓰입니다. 차이가 통계적으로 유의한지만 알려주는 p값과 달리, 코헨의 d는 그 차이가 실질적으로 얼마나 의미 있는지를 알려줍니다.
계산기 사용 방법
두 집단 각각의 평균, 표준편차, 표본 크기를 입력하세요. 계산기는 통합 표준편차(pooled SD)를 구한 뒤 평균 차이를 이 값으로 나누어 코헨의 d를 산출합니다. 또한 코헨이 제시한 기준에 따라 결과를 무시할 만함, 소, 중, 대 효과로 자동 분류해 줍니다.
공식 설명
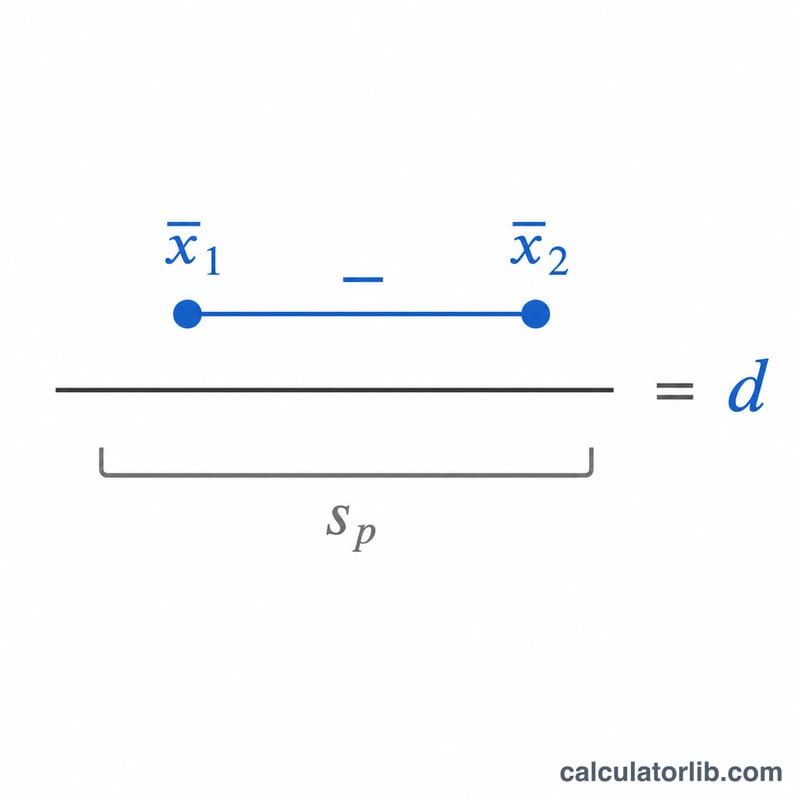
효과크기는 다음과 같이 정의됩니다.
$$d = \frac{\text{Mean}_1 - \text{Mean}_2}{s_p}$$통합 표준편차는 다음과 같습니다.
$$s_p = \sqrt{\frac{(n_1-1)\,s_1^2 + (n_2-1)\,s_2^2}{n_1 + n_2 - 2}}$$이 공식은 각 집단의 분산을 자유도로 가중 평균하여 하나의 통합된 산포도를 만들고, 이를 기준으로 평균 차이를 표준화합니다.
계산 예시
1집단이 평균 100, 표준편차 10, 표본 수 30이고, 2집단이 평균 90, 표준편차 12, 표본 수 30이라고 합시다. 통합 분산은 다음과 같습니다.
$$\frac{(29\cdot 100)+(29\cdot 144)}{58} = \frac{2900+4176}{58} = 122$$따라서 \(s_p = \sqrt{122} \approx 11.0454\) 이고, \(d = (100-90)/11.0454 \approx 0.905\) 로 큰 효과(large effect)에 해당합니다.
코헨의 d 기준값과 중첩 참조표
코헨의 d는 두 집단 평균의 차이를 합동 표준편차 단위로 나타냅니다. 코헨(1988)은 0.2, 0.5, 0.8을 각각 작은, 중간, 큰 효과의 대략적인 기준으로 제시했습니다. 사와일로스키(2009)는 나중에 1.2(매우 큰)와 2.0(거대한)을 추가했습니다. 아래 중첩 수치는 분산이 같은 두 정규분포를 가정하고 d로부터 계산한 값입니다.
| 코헨의 d | 분류 | 분포 중첩(OVL) | 코헨의 U3(집단 1 평균보다 낮은 집단 2의 비율) | 우위 확률 |
|---|---|---|---|---|
| 0.2 | 작은 | ≈ 92.0% | ≈ 57.9% | ≈ 55.6% |
| 0.5 | 중간 | ≈ 80.3% | ≈ 69.1% | ≈ 63.8% |
| 0.8 | 큰 | ≈ 68.9% | ≈ 78.8% | ≈ 71.4% |
| 1.2 | 매우 큰 | ≈ 54.9% | ≈ 88.5% | ≈ 80.2% |
| 2.0 | 거대한 | ≈ 31.7% | ≈ 97.7% | ≈ 92.1% |
표 뒤의 공식은 \(\text{OVL} = 2\,\Phi(-d/2)\), \(U_3 = \Phi(d)\), 우위 확률 \(= \Phi(d/\sqrt{2})\)이며, 여기서 \(\Phi\)는 표준정규 누적분포함수입니다.
- |d| 값이 0.2 미만이면 보통 무시할 만한 수준으로 설명합니다.
- 코헨은 이 기준값들을 더 나은 분야별 참고 자료가 없을 때 쓰는 대략적인 관례라고 설명했습니다. 엄격한 경계값이 아니며, d가 0.49인 것과 0.50인 것은 의미 있게 다르지 않습니다.
코헨의 d 결과 해석하기
d는 표준편차 단위로 측정됩니다. d가 0.5라는 것은 두 집단 평균이 합동 표준편차의 절반만큼 차이 난다는 뜻입니다. d가 1.0이면 합동 표준편차 한 개만큼 차이 난다는 뜻입니다.
부호와 크기. 부호는 어느 집단의 평균이 더 높은지만 나타냅니다. \(\text{Mean}_1 - \text{Mean}_2\)에서 d가 양수이면 집단 1이 더 높고, 음수이면 집단 2가 더 높습니다. 효과의 크기는 절댓값 |d|이며, 작은/중간/큰 분류는 이를 가리킵니다.
효과 크기는 통계적 유의성이 아닙니다. p값은 표본 크기에 크게 좌우됩니다. 참가자가 수천 명이면 아주 작은 d도 "유의"하게 나올 수 있고, 소수일 때는 큰 d도 유의하지 않을 수 있습니다. 코헨의 d는 n이 커진다고 커지지 않으므로, 차이가 얼마나 큰지를 나타내지 그 차이가 실제로 존재하는지에 대한 확신을 나타내지는 않습니다. d와 함께 신뢰구간을 보고하는 것이 좋은 관행입니다.
맥락이 중요합니다. 0.2, 0.5, 0.8이라는 기준은 일반적인 것입니다. 교육이나 의학처럼 일부 분야에서는 결과를 쉽게 바꿀 수 있거나 많은 사람에게 영향을 줄 때 d가 0.2여도 중요할 수 있습니다. 엄격히 통제된 실험실 연구에서는 0.2가 별다를 것 없을 수도 있습니다. 자신의 분야에서 보고된 효과와 자신의 d를 비교하고 실제적 결과를 판단하세요.
소표본 편향. 표본이 작을 때 코헨의 d는 모집단 효과를 약간 과대추정합니다. 헤지스의 g는 이를 대략적으로 보정합니다.
$$g \approx d \times \left(1 - \frac{3}{4(n_1 + n_2) - 9}\right)$$
예를 들어 \(n_1 + n_2 = 80\)이면 보정 계수는 \(1 - 3/311 \approx 0.990\)이므로, d가 0.53이면 g는 약 0.53이 됩니다. 보정은 전체 표본이 대략 20~50 미만일 때 주로 중요합니다.
합동 표준편차의 가정.
- 두 모집단의 분산이 대략 같아야 합니다. 표준편차가 많이 다르면 합동 표준편차는 오해를 낳을 수 있으며, 대조집단 표준편차를 사용하는 글래스의 Δ 같은 대안이 더 적합할 수 있습니다.
- 데이터가 대략 정규분포를 따라야 합니다. 심한 왜도나 이상치는 평균과 표준편차를 모두 왜곡하며, 참조표의 중첩 백분율이 더 이상 정확히 성립하지 않습니다.
- 집단이 독립적이어야 합니다. 짝을 이룬 설계나 반복측정 설계에는 다른 효과 크기 공식이 필요합니다.
시나리오 비교: 입력값이 d를 어떻게 바꾸는가
각 행은 합동 표준편차 \(s_p = \sqrt{\dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}}\)와 \(d = (\text{Mean}_1 - \text{Mean}_2)/s_p\)를 사용합니다. 분류는 코헨의 기준을 따릅니다.
| 시나리오 | 집단 1(평균, 표준편차, n) | 집단 2(평균, 표준편차, n) | 합동 표준편차 | d | 분류 |
|---|---|---|---|---|---|
| A. 기준 | 105, 15, 30 | 100, 15, 30 | 15.00 | 0.33 | 작은 |
| B. 같은 차이(5), 더 큰 표준편차 | 105, 25, 30 | 100, 25, 30 | 25.00 | 0.20 | 작은 |
| C. A와 같은 d, 더 큰 표본 | 105, 15, 100 | 100, 15, 100 | 15.00 | 0.33 | 작은 |
| D. 서로 다른 n과 서로 다른 표준편차 | 82, 10, 20 | 75, 14, 60 | 13.14 | 0.53 | 중간 |
| E. 더 큰 차이, 비슷한 표준편차 | 78, 8, 25 | 70, 10, 25 | 9.06 | 0.88 | 큰 |
작업 검산
시나리오 D: $$s_p = \sqrt{\frac{19(10^2) + 59(14^2)}{20 + 60 - 2}} = \sqrt{\frac{1900 + 11564}{78}} = \sqrt{172.62} \approx 13.14$$ $$d = \frac{82 - 75}{13.14} \approx 0.53$$
시나리오 E: $$s_p = \sqrt{\frac{24(8^2) + 24(10^2)}{48}} = \sqrt{\frac{1536 + 2400}{48}} = \sqrt{82} \approx 9.06$$ $$d = \frac{78 - 70}{9.06} \approx 0.88$$
비교가 보여주는 것
- A 대 B: 두 경우 모두 원점수 평균 차이는 5이지만, B의 더 큰 散布(산포)가 d를 0.33에서 0.20으로 줄입니다.
- A 대 C: 표본 크기는 d를 바꾸지 않습니다. 바뀌는 것은 평균과 표준편차뿐입니다. n이 커지면 추정이 더 정밀해지고 결과가 통계적으로 유의할 가능성이 높아집니다.
- D: n이 다를 때 합동 표준편차는 더 큰 집단의 표준편차 쪽으로 가중되므로, 10보다 14에 더 가깝습니다.
자주 묻는 질문
어느 정도면 큰 효과인가요? 코헨의 경험적 기준에 따르면 0.2는 소(small), 0.5는 중(medium), 0.8 이상은 대(large) 효과로 봅니다.
d가 음수가 될 수도 있나요? 네. 음수 값은 단지 2집단의 평균이 1집단보다 높다는 뜻입니다. 효과의 크기를 판단할 때는 부호와 상관없이 절댓값이 중요합니다.
두 집단의 표본 크기가 같아야 하나요? 아닙니다. 통합 공식은 자유도로 가중하므로 표본 크기가 서로 달라도 정확하게 계산됩니다.