什么是 Cohen's d?
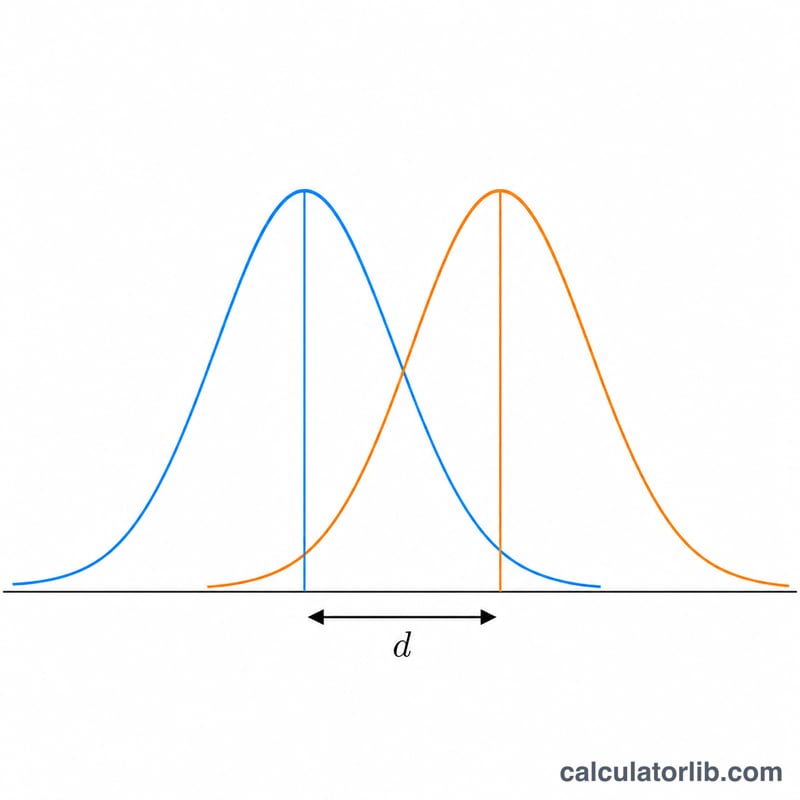
Cohen's d 是一种标准化的效应量指标,它以标准差为单位来表示两组均值之间的差异。在心理学、教育学和医学研究中,Cohen's d 被广泛用于衡量差异究竟有多大,且不受样本量大小的影响。与只能告诉你差异是否具有统计学显著性的 p 值不同,Cohen's d 能告诉你这个差异到底有多大的实际意义。
如何使用本计算器
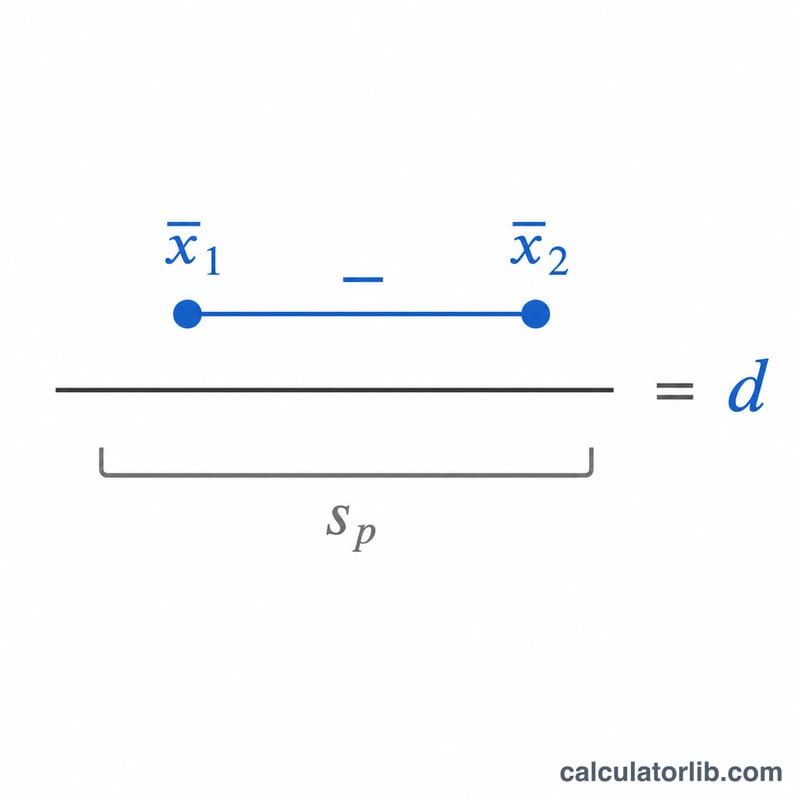
分别填入两组数据各自的均值、标准差和样本量。计算器会先算出合并标准差,再用两组均值之差除以它,得到 Cohen's d。同时,它还会根据 Cohen 提出的经典参考标准,将结果判定为可忽略、小、中或大效应。
公式详解
效应量的计算公式为 $$d = \frac{\bar{x}_1 - \bar{x}_2}{s_p}$$ 其中合并标准差为 $$s_p = \sqrt{\frac{(n_1-1)\cdot s_1^2 + (n_2-1)\cdot s_2^2}{n_1 + n_2 - 2}}$$ 该公式按各组的自由度对方差进行加权,从而得到一个综合的离散程度,用来标准化两组的均值差异。
计算实例
假设第 1 组的均值为 100、标准差为 10、样本量为 30,第 2 组的均值为 90、标准差为 12、样本量为 30。则合并方差为 $$\frac{(29\cdot 100)+(29\cdot 144)}{58} = \frac{2900+4176}{58} = 122$$ 因此 \(s_p = \sqrt{122} \approx 11.0454\),\(d = \frac{100-90}{11.0454} \approx 0.905\)——属于大效应。
Cohen's d 基准值与重叠度参考
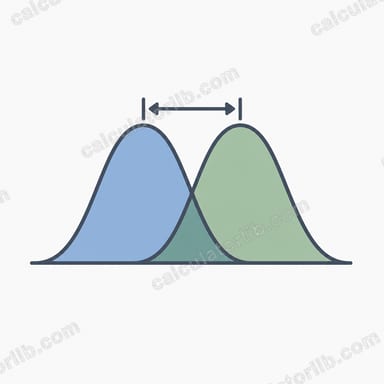
Cohen's d 以合并标准差为单位,表示两组均值之间的差异。Cohen(1988)建议将 0.2、0.5 和 0.8 作为小、中、大效应的粗略标签。Sawilowsky(2009)后来又补充了 1.2(非常大)和 2.0(极大)。下表的重叠度数值假设两个方差相等的正态分布,并由 d 计算得出。
| 科恩 d 值 | 标签 | 分布重叠度(OVL) | Cohen's U3(组2中低于组1均值的比例) | 优势概率 |
|---|---|---|---|---|
| 0.2 | 小 | ≈ 92.0% | ≈ 57.9% | ≈ 55.6% |
| 0.5 | 中 | ≈ 80.3% | ≈ 69.1% | ≈ 63.8% |
| 0.8 | 大 | ≈ 68.9% | ≈ 78.8% | ≈ 71.4% |
| 1.2 | 非常大 | ≈ 54.9% | ≈ 88.5% | ≈ 80.2% |
| 2.0 | 极大 | ≈ 31.7% | ≈ 97.7% | ≈ 92.1% |
表中的公式为 \(\text{OVL} = 2\,\Phi(-d/2)\)、\(U_3 = \Phi(d)\) 以及优势概率 \(= \Phi(d/\sqrt{2})\),其中 \(\Phi\) 为标准正态累积分布函数。
- |d| 低于 0.2 的值通常被描述为可忽略。
- Cohen 强调,这些基准值是在没有更好的领域特定参考时使用的粗略惯例。它们并非严格的临界值,d 为 0.49 与 0.50 在实际意义上并无显著差别。
解读你的 Cohen's d 结果
d 以标准差为单位衡量。d 为 0.5 表示两组均值相差半个合并标准差。d 为 1.0 表示两组均值相差一个完整的合并标准差。
符号与大小。符号仅表示哪一组的均值更高。对于 \(\text{均值}_1 - \text{均值}_2\),正的 d 表示组1更高,负的 d 表示组2更高。效应大小是绝对值 |d|,小、中、大的标签指的就是它。
效应量不等于统计显著性。p 值在很大程度上取决于样本量。很小的 d 在数千名参与者的情况下可能“显著”,而很大的 d 在只有少数人时可能不显著。Cohen's d 不会随 n 增大而增大,它描述的是差异有多大,而不是你对差异是否存在有多确定。建议同时报告 d 的置信区间。
背景很重要。0.2、0.5 和 0.8 这些标签是通用的。在教育或医学等领域,当结果容易改变或影响许多人时,0.2 的 d 也可能很重要。在严格控制的实验室研究中,0.2 可能并不引人注意。请将你的 d 与本领域报告的效应进行比较,并判断其实际后果。
小样本偏差。样本较小时,Cohen's d 会略微高估总体效应。Hedges' g 可以近似地校正这一点:
$$g \approx d \times \left(1 - \frac{3}{4(n_1 + n_2) - 9}\right)$$
例如,当 \(n_1 + n_2 = 80\) 时,修正系数为 \(1 - 3/311 \approx 0.990\),因此 d 为 0.53 时,g 约为 0.53。修正主要在总样本量低于大约 20 至 50 时才有意义。
合并标准差的假设。
- 两个总体的方差大致相等。如果标准差相差很大,合并标准差可能会产生误导,此时 Glass's Δ(使用对照组标准差)等替代方法可能更合适。
- 数据近似服从正态分布。严重偏态或异常值会扭曲均值和标准差,参考表中的重叠百分比也不再完全成立。
- 各组相互独立。对于配对或重复测量设计,需要使用不同的效应量公式。
情景比较:输入如何影响 d
每一行都使用合并标准差 \(s_p = \sqrt{\dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}}\),且 \(d = (\text{均值}_1 - \text{均值}_2)/s_p\)。分类依据 Cohen 的标准。
| 情景 | 组1(均值、标准差、n) | 组2(均值、标准差、n) | 合并标准差 | d | 分类 |
|---|---|---|---|---|---|
| A. 基线 | 105, 15, 30 | 100, 15, 30 | 15.00 | 0.33 | 小 |
| B. 均值差相同(5),标准差更大 | 105, 25, 30 | 100, 25, 30 | 25.00 | 0.20 | 小 |
| C. 与 A 的 d 相同,样本量更大 | 105, 15, 100 | 100, 15, 100 | 15.00 | 0.33 | 小 |
| D. 样本量与标准差均不相等 | 82, 10, 20 | 75, 14, 60 | 13.14 | 0.53 | 中 |
| E. 均值差更大,标准差相近 | 78, 8, 25 | 70, 10, 25 | 9.06 | 0.88 | 大 |
计算示例
情景 D: $$s_p = \sqrt{\frac{19(10^2) + 59(14^2)}{20 + 60 - 2}} = \sqrt{\frac{1900 + 11564}{78}} = \sqrt{172.62} \approx 13.14$$ $$d = \frac{82 - 75}{13.14} \approx 0.53$$
情景 E: $$s_p = \sqrt{\frac{24(8^2) + 24(10^2)}{48}} = \sqrt{\frac{1536 + 2400}{48}} = \sqrt{82} \approx 9.06$$ $$d = \frac{78 - 70}{9.06} \approx 0.88$$
比较结果说明
- A 与 B:两者的原始均值差都是 5,但 B 的离散程度更大,使 d 从 0.33 降至 0.20。
- A 与 C:样本量不会改变 d,只有均值和标准差会。更大的 n 会使估计更精确,结果也更可能具有统计显著性。
- D:样本量不相等时,合并标准差会偏向较大组的标准差,因此它更接近 14,而不是 10。
常见问题
多大才算大效应?按照 Cohen 的经验法则,\(0.2\) 为小效应,\(0.5\) 为中等效应,\(0.8\) 及以上为大效应。
d 可以为负数吗?可以。负值只是表示第 2 组的均值高于第 1 组。衡量效应大小时,看的是它的绝对值(数值大小)。
两组样本量必须相等吗?不必。合并公式会按自由度进行加权,因此即使两组样本量不相等,结果依然准确可靠。