इनवर्स नॉर्मल कैलकुलेटर क्या करता है
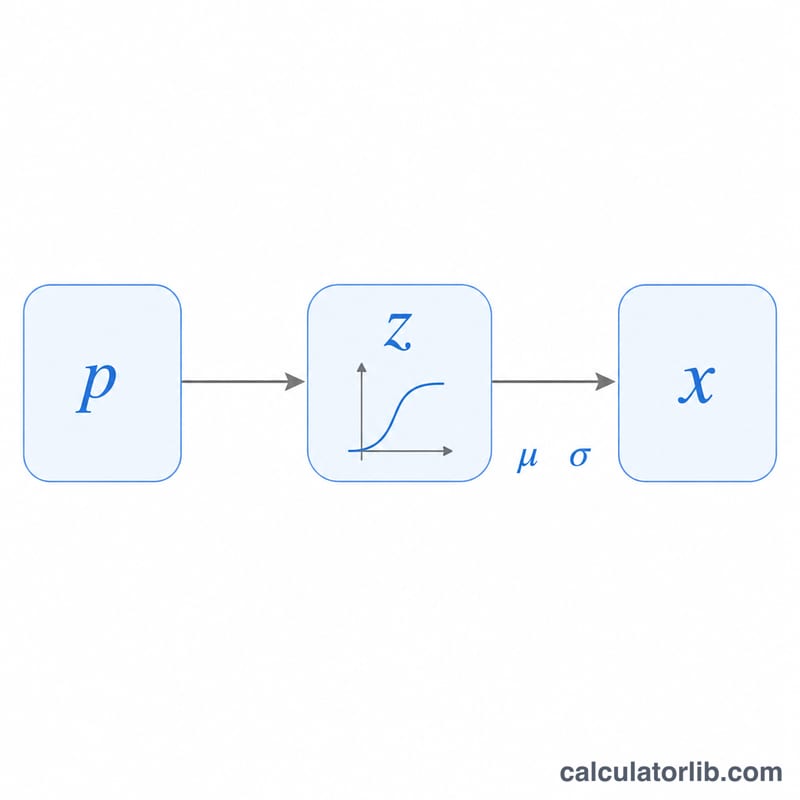
यह कैलकुलेटर सांख्यिकी के एक आम सवाल का जवाब उल्टी दिशा में देता है। आमतौर पर हम पूछते हैं — "किसी मान x से कम होने की प्रायिकता क्या है?" लेकिन यहाँ सवाल बदल जाता है — "किसी दी गई प्रायिकता के नीचे कौन सा मान आता है?" आप एक संचयी (cumulative) प्रायिकता और नॉर्मल वितरण के पैरामीटर डालते हैं, और यह टूल उससे मेल खाता डेटा मान (इनवर्स नॉर्मल), उसका पर्सेंटाइल और संगत z‑स्कोर लौटा देता है। इसका इस्तेमाल पढ़ाई-लिखाई, क्वालिटी कंट्रोल, फाइनेंस (value-at-risk) और स्टैंडर्डाइज़्ड टेस्ट जैसी जगहों पर खूब होता है।
तीन इनपुट
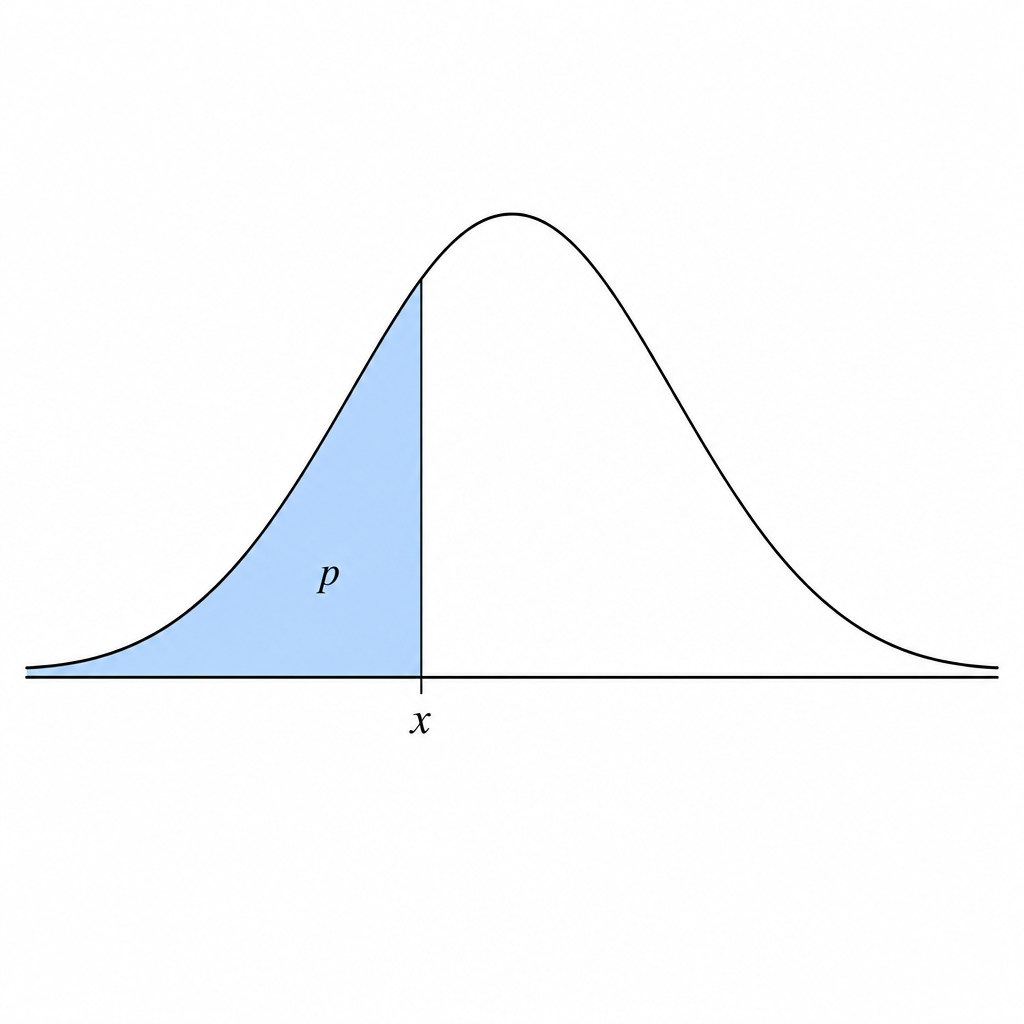
- प्रायिकता (0 से 1): जिस मान को आप ढूँढना चाहते हैं, उसके बाईं ओर का संचयी क्षेत्रफल। उदाहरण के लिए, 0.95 का मतलब है "वह मान जिसके नीचे वितरण का 95% हिस्सा आता है।" यह 0 और 1 के बीच ही होना चाहिए (दोनों को छोड़कर)।
- माध्य (μ): आपके नॉर्मल वितरण का केंद्र।
- मानक विचलन (σ): वितरण का फैलाव। यह हमेशा 0 से बड़ा होना चाहिए।
सूत्र
यह टूल आपके μ और σ वाले नॉर्मल वितरण का इनवर्स संचयी वितरण फलन (क्वांटाइल फंक्शन) निकालता है:
- इनवर्स नॉर्मल मान: x = Φ⁻¹(p; μ, σ) — वह मान जहाँ संचयी प्रायिकता p के बराबर होती है।
- पर्सेंटाइल: प्रायिकता × 100।
- Z‑स्कोर: z = (x − μ) / σ — x माध्य से कितने मानक विचलन दूर है।
अंदरूनी तौर पर यह पहले स्टैंडर्ड नॉर्मल इनवर्स निकालता है, फिर उसे स्केल और शिफ्ट करता है: x = μ + σ · z, जहाँ z प्रायिकता p से मेल खाता है।
हल किया हुआ उदाहरण
मान लीजिए परीक्षा के अंक नॉर्मली डिस्ट्रिब्यूटेड हैं, जिनका माध्य (μ) 70 और मानक विचलन (σ) 8 है, और आप 90वाँ पर्सेंटाइल जानना चाहते हैं। तो डालें — प्रायिकता = 0.90, माध्य = 70, मानक विचलन = 8।
- 0.90 के लिए स्टैंडर्ड नॉर्मल z‑स्कोर लगभग 1.2816 होता है।
- इनवर्स नॉर्मल मान: 70 + 8 × 1.2816 ≈ 80.25।
- पर्सेंटाइल: 0.90 × 100 = 90%।
- Z‑स्कोर: (80.25 − 70) / 8 ≈ 1.28।
यानी लगभग 80.25 अंक पाने वाला छात्र 90वें पर्सेंटाइल पर आता है।
सामान्य प्रायिकताएँ और उनके Z-स्कोर
तालिका मानक सामान्य क्वांटाइल \(z = \Phi^{-1}(p)\) दिखाती है, यानी वह z-स्कोर जिसके बाईं ओर संचयी प्रायिकता p हो, और यह माध्य 0 तथा मानक विचलन 1 वाले बंटन के लिए है। किसी भी सामान्य बंटन में बदलने के लिए \(x = \mu + \sigma \cdot z\) का उपयोग करें।
| संचयी प्रायिकता p | z = Φ⁻¹(p) |
|---|---|
| 0.01 | -2.3263 |
| 0.025 | -1.9600 |
| 0.05 | -1.6449 |
| 0.50 | 0 |
| 0.75 | 0.6745 |
| 0.80 | 0.8416 |
| 0.90 | 1.2816 |
| 0.95 | 1.6449 |
| 0.975 | 1.9600 |
| 0.99 | 2.3263 |
| 0.995 | 2.5758 |
| 0.999 | 3.0902 |
मानक सामान्य वक्र सममित है, इसलिए \(\Phi^{-1}(1-p) = -\Phi^{-1}(p)\)। इसीलिए 0.05 के लिए -1.6449 और 0.95 के लिए +1.6449 मिलता है।
आपके परिणाम की व्याख्या
मान x वह कट-ऑफ बिंदु है जिसके बाईं ओर प्रायिकता p और दाईं ओर 1 − p है, इसलिए \(P(X \le x) = p\)। उदाहरण के लिए, p = 0.95 के साथ x 95वां प्रतिशतक है: 95% मान इसके बराबर या इससे नीचे और 5% इससे ऊपर आते हैं।
- यदि p < 0.5 है, तो z ऋणात्मक है और x माध्य से नीचे होता है।
- यदि p > 0.5 है, तो z धनात्मक है और x माध्य से ऊपर होता है।
- यदि p = 0.5 है, तो z = 0 और x माध्य के बराबर होता है (जो माध्यिका भी है)।
अनुभवजन्य नियम पैमाने का उपयोगी अंदाज़ा देता है: लगभग 68% मान माध्य के ±1σ के भीतर, लगभग 95% ±2σ के भीतर, और लगभग 99.7% ±3σ के भीतर आते हैं। अधिक सटीक रूप से, 95% केंद्रीय अंतराल z = ±1.96 का उपयोग करता है, ठीक ±2 नहीं।
कवरेज c वाला द्विपक्षीय केंद्रीय अंतराल पाने के लिए ऊपरी सीमा के लिए \(p = (1 + c)/2\) और निचली सीमा के लिए \(p = (1 - c)/2\) का उपयोग करें। 95% केंद्रीय अंतराल के लिए, p = 0.975 से z = 1.96 मिलता है, और अंतराल \(\mu \pm 1.96\sigma\) है।
यह सब मानता है कि डेटा को उस माध्य और मानक विचलन के साथ सामान्य बंटन से अच्छी तरह वर्णित किया गया है जो आपने दर्ज किए हैं। यदि वास्तविक डेटा तिरछा (skewed) या भारी-पूंछ वाला है, तो कट-ऑफ वास्तविक प्रतिशतक से मेल नहीं खाएगा।
अक्सर पूछे जाने वाले सवाल
प्रायिकता 0 और 1 के बीच ही (दोनों को छोड़कर) क्यों होनी चाहिए? नॉर्मल वितरण दोनों दिशाओं में अनंत तक फैला होता है, इसलिए ठीक 0 या 1 की प्रायिकता ±अनंत (infinity) से मेल खाती है। कैलकुलेटर सिर्फ इसी खुले अंतराल के भीतर के मान स्वीकार करता है।
अगर मैं माध्य और मानक विचलन को मानक (standard) मानों पर ही छोड़ दूँ तो? यदि आप माध्य = 0 और मानक विचलन = 1 डालते हैं, तो इनवर्स नॉर्मल मान सीधे z‑स्कोर के बराबर हो जाता है, जो आपको क्लासिक स्टैंडर्ड नॉर्मल क्वांटाइल देता है।
नतीजा ऋणात्मक (negative) आने का क्या मतलब है? अगर आपकी प्रायिकता 0.5 से कम है, तो मान माध्य के बाईं ओर पड़ता है, जिससे z‑स्कोर ऋणात्मक और मान μ से छोटा आता है। यह अपेक्षित है, कोई गलती नहीं।