역정규분포 계산기로 무엇을 할 수 있나요?
이 계산기는 일반적인 통계 문제를 거꾸로 풀어 줍니다. 즉 "x보다 작은 값이 나올 확률은 얼마인가?"가 아니라, "주어진 확률 아래에 놓이는 값은 무엇인가?"를 묻는 것이죠. 누적 확률과 정규분포의 모수를 입력하면, 그에 대응하는 데이터 값(역정규분포 값), 백분위수, 그리고 z-점수를 돌려줍니다. 학교 과제, 품질 관리, 금융(Va, 가치-위험 분석), 표준화 시험 등 다양한 분야에서 널리 쓰입니다.
세 가지 입력값
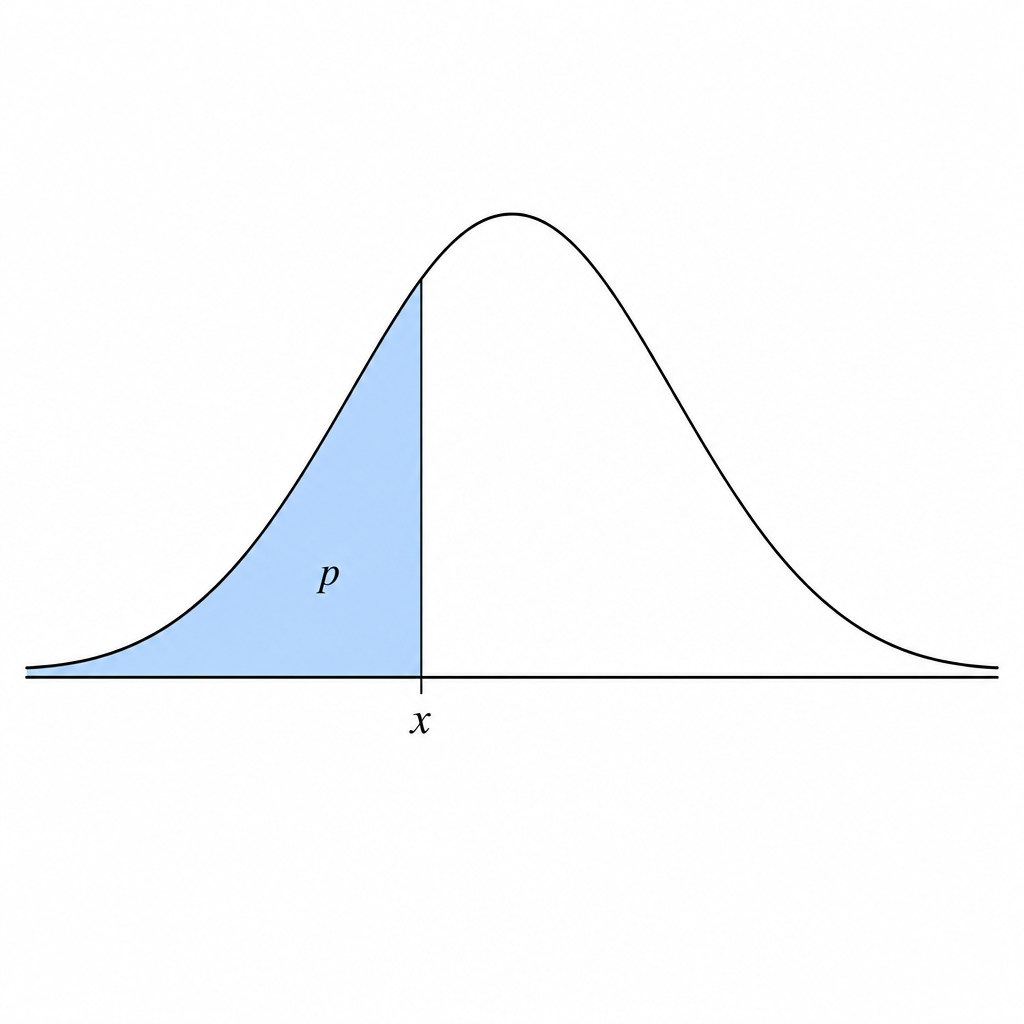
- 확률 (0~1): 구하려는 값의 왼쪽 누적 면적입니다. 예를 들어 0.95는 "분포의 95%가 그 아래에 놓이는 값"을 의미합니다. 반드시 0과 1 사이의 값이어야 합니다.
- 평균 (μ): 정규분포의 중심입니다.
- 표준편차 (σ): 분포가 얼마나 퍼져 있는지를 나타냅니다. 반드시 0보다 커야 합니다.
계산 공식
입력한 μ와 σ를 가진 정규분포의 역누적분포함수(분위수 함수)를 계산합니다.
- 역정규분포 값: x = Φ⁻¹(p; μ, σ) — 누적 확률이 p가 되는 지점의 값입니다.
- 백분위수: 확률 × 100.
- Z-점수: z = (x − μ) / σ — x가 평균에서 표준편차 몇 배만큼 떨어져 있는지를 나타냅니다.
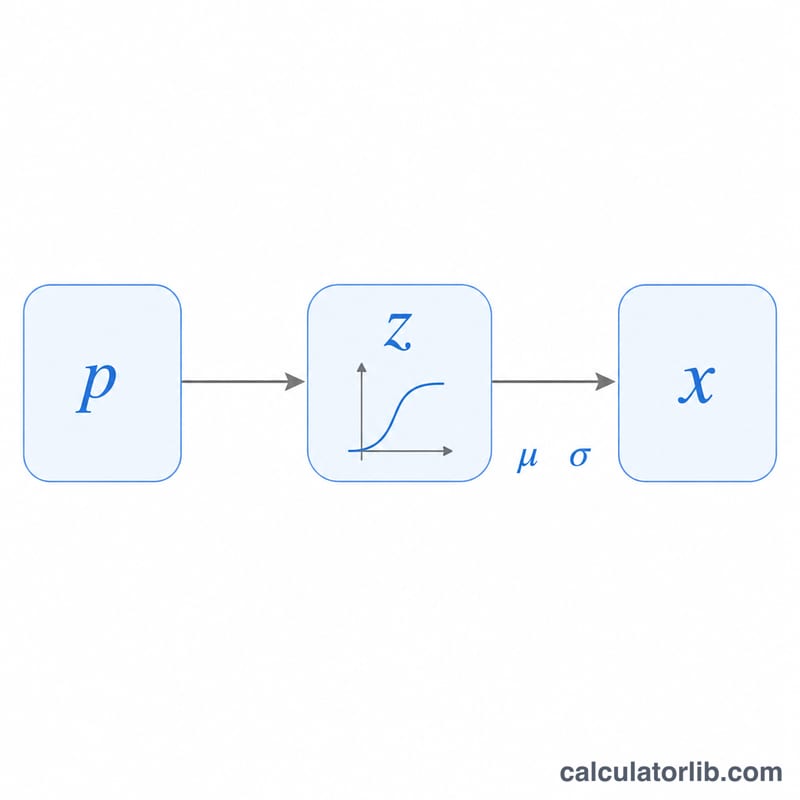
내부적으로는 표준정규분포의 역함수를 먼저 구한 뒤, 이를 확대·이동하여 계산합니다: x = μ + σ · z (여기서 z는 확률 p에 대응하는 값).
예제로 살펴보기
시험 점수가 평균(μ) 70, 표준편차(σ) 8인 정규분포를 따른다고 가정하고, 90번째 백분위수를 구하고 싶다고 해 봅시다. 확률 = 0.90, 평균 = 70, 표준편차 = 8을 입력합니다.
- 0.90에 해당하는 표준정규 z-점수는 약 1.2816입니다.
- 역정규분포 값: 70 + 8 × 1.2816 ≈ 80.25.
- 백분위수: 0.90 × 100 = 90%.
- Z-점수: (80.25 − 70) / 8 ≈ 1.28.
즉, 약 80.25점을 받은 학생은 90번째 백분위수에 위치하게 됩니다.
일반적인 확률과 z-점수
이 표는 표준 정규 분위수 \(z = \Phi^{-1}(p)\)를 나타내며, 이는 평균 0, 표준편차 1인 분포에서 왼쪽 누적확률이 p인 z-점수입니다. 임의의 정규분포로 변환하려면 \(x = \mu + \sigma \cdot z\)를 사용하세요.
| 누적확률 p | z = Φ⁻¹(p) |
|---|---|
| 0.01 | -2.3263 |
| 0.025 | -1.9600 |
| 0.05 | -1.6449 |
| 0.50 | 0 |
| 0.75 | 0.6745 |
| 0.80 | 0.8416 |
| 0.90 | 1.2816 |
| 0.95 | 1.6449 |
| 0.975 | 1.9600 |
| 0.99 | 2.3263 |
| 0.995 | 2.5758 |
| 0.999 | 3.0902 |
표준 정규 곡선은 대칭이므로 \(\Phi^{-1}(1-p) = -\Phi^{-1}(p)\)입니다. 그래서 0.05는 -1.6449를, 0.95는 +1.6449를 제공합니다.
결과 해석하기
값 x는 왼쪽에 확률 p, 오른쪽에 1 − p를 갖는 기준점이므로 \(P(X \le x) = p\)입니다. 예를 들어 p = 0.95이면 x는 95 백분위수입니다. 값의 95%는 이 점 이하에 있고, 5%는 이 점 위에 있습니다.
- p < 0.5이면 z는 음수이며 x는 평균보다 아래에 있습니다.
- p > 0.5이면 z는 양수이며 x는 평균보다 위에 있습니다.
- p = 0.5이면 z = 0이며 x는 평균(또한 중앙값)과 같습니다.
경험적 법칙은 규모를 가늠하는 데 유용합니다. 값의 약 68%는 평균의 ±1σ 안에, 약 95%는 ±2σ 안에, 약 99.7%는 ±3σ 안에 놓입니다. 더 정확히는, 95% 중심 구간은 정확히 ±2가 아니라 z = ±1.96을 사용합니다.
포함 확률이 c인 양측 중심 구간을 구하려면 상한에는 \(p = (1 + c)/2\), 하한에는 \(p = (1 - c)/2\)를 사용하세요. 95% 중심 구간의 경우 p = 0.975이면 z = 1.96이며, 구간은 \(\mu \pm 1.96\sigma\)입니다.
이 모든 내용은 데이터가 입력한 평균과 표준편차를 가진 정규분포로 잘 설명된다고 가정합니다. 실제 데이터가 왜도가 있거나 꼬리가 두꺼우면, 기준점은 실제 백분위수와 일치하지 않습니다.
자주 묻는 질문
왜 확률은 반드시 0과 1 사이여야 하나요? 정규분포는 양쪽으로 무한히 뻗어 있기 때문에, 정확히 0이나 1의 확률은 ±무한대에 대응합니다. 따라서 계산기는 0과 1 사이의 (양 끝을 제외한) 값만 받습니다.
평균과 표준편차를 기본값 그대로 두면 어떻게 되나요? 평균 = 0, 표준편차 = 1로 입력하면 역정규분포 값이 곧 z-점수와 같아져, 고전적인 표준정규 분위수를 그대로 얻을 수 있습니다.
결과가 음수로 나오면 무슨 뜻인가요? 확률이 0.5보다 작으면 값이 평균의 왼쪽에 놓이게 되어, z-점수가 음수가 되고 값도 μ보다 작아집니다. 이는 오류가 아니라 정상적인 결과입니다.