Что такое логнормальное распределение?
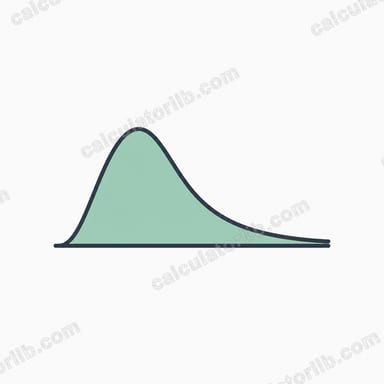
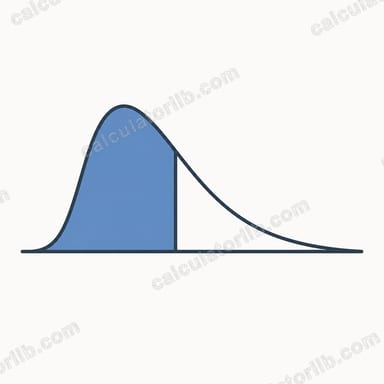
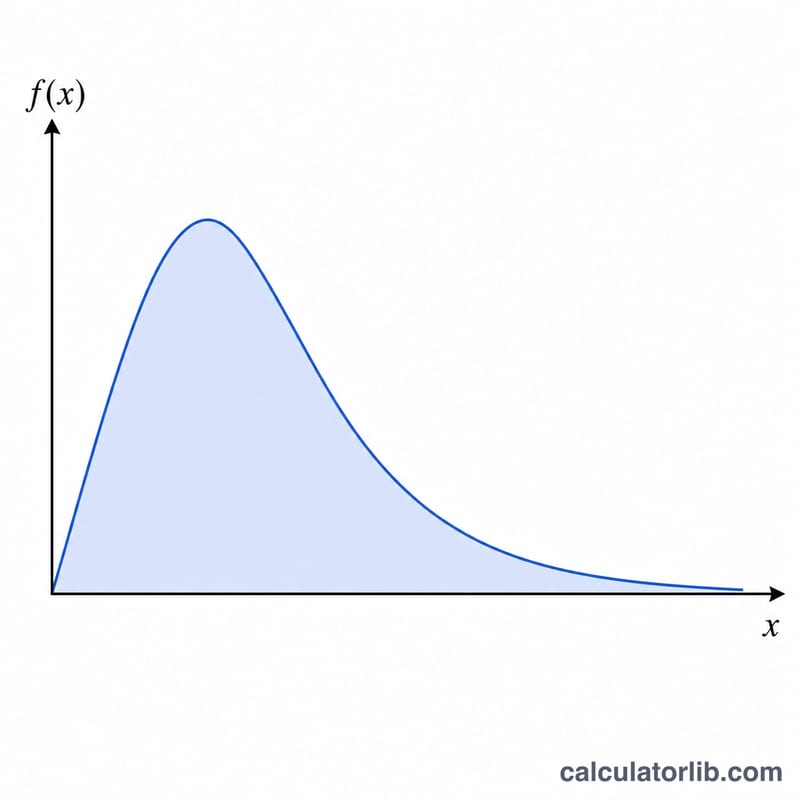
Положительная случайная величина X подчиняется логнормальному распределению, если её натуральный логарифм ln(X) распределён нормально. Иными словами, \(X = e^Y\), где Y — нормальная случайная величина со средним \(\mu\) и стандартным отклонением \(\sigma\). Поскольку логарифм определён только для положительных чисел, логнормальное распределение целиком сосредоточено на положительной полуоси. Это делает его естественной моделью для величин, которые не могут быть отрицательными: цен акций, доходов, размеров частиц, биологических измерений и времени до отказа оборудования.
Как пользоваться калькулятором
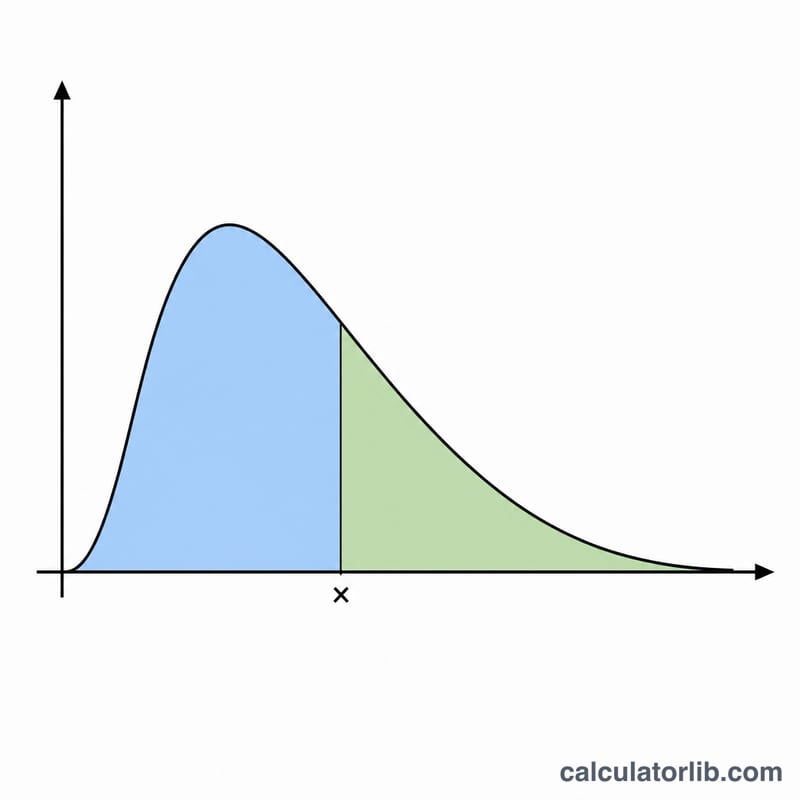
Введите значение x, в котором нужно вычислить распределение (оно должно быть больше 0), а затем укажите \(\mu\) и \(\sigma\). Важный момент, который часто сбивает с толку новичков: здесь \(\mu\) и \(\sigma\) — это среднее и стандартное отклонение величины \(\ln(X)\), а не самой X. Калькулятор выдаёт три числа: плотность вероятности \(f(x)\), нижнюю кумулятивную вероятность \(P(x) = P(X \le x)\) и верхнюю кумулятивную вероятность \(Q(x) = P(X > x) = 1 - P(x)\).
Разбор формулы
Введём стандартизованную величину \(z = (\ln x - \mu) / \sigma\). Тогда плотность равна
$$f(x) = \frac{1}{\text{x}\;\sigma\sqrt{2\pi}}\,\exp\!\left(-\frac{\left(\ln \text{x} - \mu\right)^2}{2\,\sigma^2}\right)$$Нижняя кумулятивная вероятность вычисляется как
$$\begin{gathered} P(X \le x) = \Phi\!\left(\frac{\ln \text{x} - \mu}{\sigma}\right) \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \Phi(z) &= \tfrac{1}{2}\left(1 + \operatorname{erf}\!\left(\tfrac{z}{\sqrt{2}}\right)\right) \\ P(X > x) &= 1 - P(X \le x) \end{aligned} \right. \end{gathered}$$где \(\Phi\) — функция стандартного нормального распределения. Так как функция ошибок erf отсутствует в стандартных математических библиотеках, в калькуляторе используется полиномиальная аппроксимация Абрамовица и Стиган (формула 7.1.26) с точностью около \(1{,}5 \times 10^{-7}\).
Пример расчёта
Возьмём \(x = 2\), \(\mu = 0\), \(\sigma = 1\). Тогда \(\ln(2) = 0{,}693147\) и \(z = 0{,}693147\). Плотность получается так: экспоненциальный множитель \(0{,}786429\) делим на \(5{,}013256\), что даёт примерно \(0{,}156874\). Нижняя кумулятивная вероятность \(\Phi(0{,}693147) \approx 0{,}755891\), поэтому верхняя кумулятивная вероятность равна \(Q(2) = 1 - 0{,}755891 \approx 0{,}244109\).
Частые вопросы
Почему x должно быть положительным? Логнормальное распределение определено только при \(x > 0\), потому что иначе \(\ln(x)\) не существует. При \(x \le 0\) плотность равна 0, \(P(x) = 0\), а \(Q(x) = 1\).
Как найти среднее самой величины X? Среднее X равно \(\exp(\mu + \sigma^2/2)\), медиана — \(\exp(\mu)\), а мода — \(\exp(\mu - \sigma^2)\). Обратите внимание: эти значения отличаются от \(\mu\) и \(\sigma\), которые описывают именно \(\ln(X)\).
Что будет, если σ равно 0? Нулевое стандартное отклонение даёт вырожденное распределение с точечной массой и приводит к делению на ноль, поэтому такое значение не принимается — используйте малое положительное \(\sigma\).