什麼是全距?
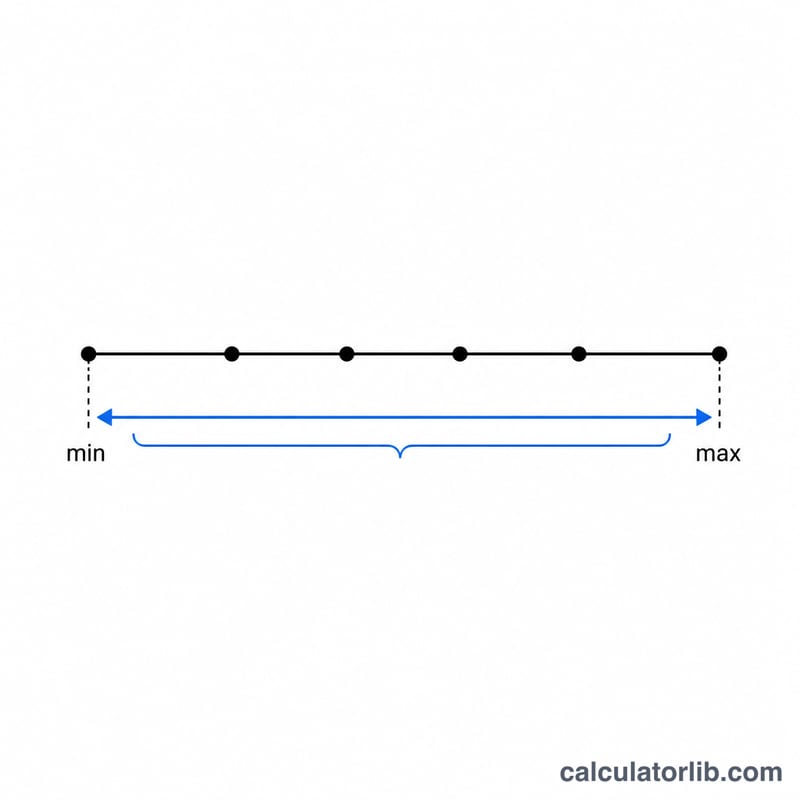
全距(Range)是統計學中最簡單的離散程度(分散度)指標之一,用來衡量一組資料中最大值與最小值之間相差多少。全距愈大,代表數值分布得愈分散;全距愈小,則代表數值集中在一起。由於它只用到兩個數值,計算非常快速,但也因此特別容易受到極端值(離群值)的影響。
如何使用這個計算器
只要把你的數字輸入到欄位中,並以逗號或空格分隔即可(例如 4, 8, 15, 16, 23, 42)。計算器會自動找出最大值與最小值,將兩者相減後算出全距,並同時顯示資料筆數。小數與負數都可以使用。
公式說明
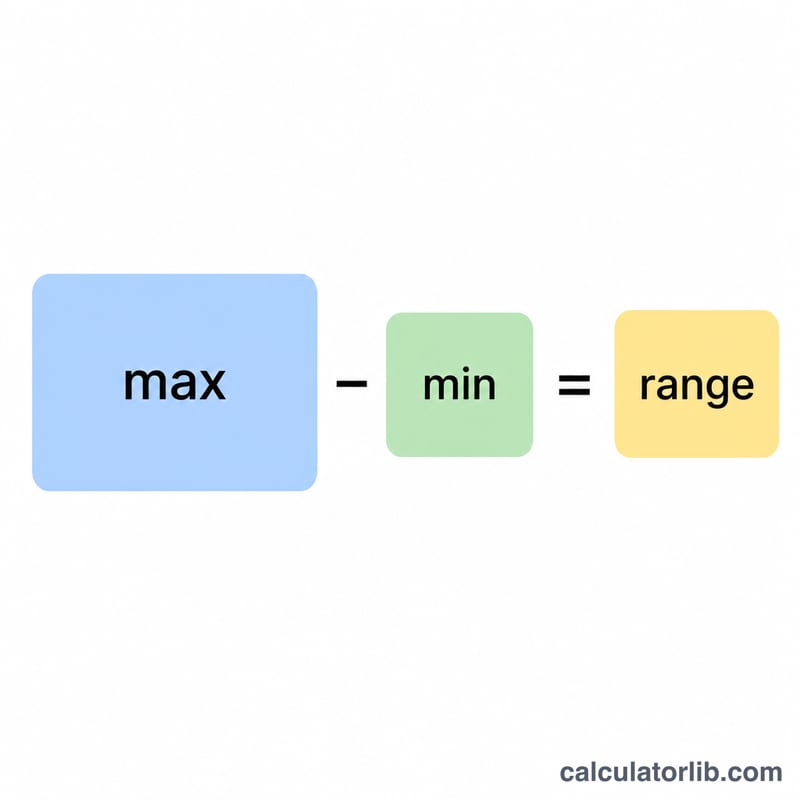
全距的定義如下:
$$\text{全距} = \max\!\left(\text{資料集}\right) - \min\!\left(\text{資料集}\right)$$
先在清單中找出最大值,再找出最小值,然後相減即可。計算結果一定會是零或正數。如果所有數值都相同,全距就是 \(0\)。
實際範例
以資料集 4、8、15、16、23、42 為例,其中最大值為 42,最小值為 4,因此全距為 $$42 - 4 = \mathbf{38}$$ 這個數字就簡潔地總結了整組資料的分布範圍。
更多範圍範例:負數、小數與離群值
範圍永遠等於最大值減最小值。這三個範例展示了經常導致錯誤的情況。
範例 1:含負數的資料
資料集:-12、-5、0、7、3。最小值為 -12,最大值為 7。
$$\text{範圍} = 7 - (-12) = 7 + 12$$
減去一個負數等於加上它的正值,因此範圍為 19。常見的錯誤是寫成 7 - 12 = -5,這是錯的,因為最小值是 -12,而不是 12。
範例 2:小數
資料集:2.5、3.1、9.8、4.4。最小值為 2.5,最大值為 9.8。
$$\text{範圍} = 9.8 - 2.5$$
範圍為 7.3。用手算減法時,請將小數點對齊。
範例 3:離群值會大幅改變範圍
資料集 A:10、12、13、14、95。最小值為 10,最大值為 95。
$$\text{範圍}_A = 95 - 10$$
範圍為 85。
現在移除數值 95,得到資料集 B:10、12、13、14。最大值為 14,最小值仍為 10。
$$\text{範圍}_B = 14 - 10 = 4$$
一個極端值就讓範圍從 4 變成 85,即使其餘四個數值都緊密聚集。範圍只取決於兩個極端值,因此對離群值非常敏感。當存在離群值時,可以考慮同時報告四分位距或標準差。
如何手動求出範圍
- 列出所有數值。 寫下資料集中的每個數字,包括重複的數字。重複的數值不會改變範圍,但會改變個數。
- 找出最小值與最大值。 逐一掃描列表,或將其由小到大排序。排序後第一個值為最小值,最後一個值為最大值。
- 相減。 計算 \(\text{範圍} = \text{最大值} - \text{最小值}\)。
- 檢查結果。 範圍應為零或正數。若答案為負數,表示相減的順序錯誤。範圍為零表示所有數值都相同。
- (選擇性)記下個數。 計算資料集中數值的數量(\(n\))。這有助於判斷範圍的可靠程度,因為較大的樣本通常會有較寬的範圍。
排序小技巧:排序能讓極端值一目了然,也有助於發現遺漏的數值。例如,7、-12、3、0、-5 排序後為 -12、-5、0、3、7。
負數最小值的小技巧:當最小值為負數時,將其放入括號中,並把兩個減號改成加號。例如 \(7 - (-12) = 7 + 12 = 19\)。若最大值與最小值都是負數,例如 -3 與 -20,則範圍為 \(-3 - (-20) = 17\)。
關鍵術語:範圍、最大值、最小值、分散程度
- 範圍
- 資料集中最大值與最小值之間的差距(最大值減最小值)。其單位與資料相同。
- 最大值
- 資料集中最大的數值。
- 最小值
- 資料集中最小的數值。它可能是負數。
- 資料集
- 一組數值,例如考試成績或每日氣溫,用來進行摘要或分析。
- 個數
- 資料集中數值的數量,通常寫作 \(n\)。重複的數值每一個都會計入。
- 分散度量(離散度)
- 描述資料集中數值分布範圍大小的統計量。例如範圍、四分位距、變異數與標準差。
- 離群值
- 遠離其他資料、異常偏大或偏小的數值。單一離群值就可能大幅改變範圍。
- 四分位距(IQR)
- 第三四分位數與第一四分位數之差(\(Q_3 - Q_1\))。它衡量中間 50% 資料的分散程度,受離群值的影響遠小於範圍。
- 標準差
- 衡量數值通常與平均值相差多遠的指標。與範圍不同,它使用資料集中的每一個數值,而不只是兩個極端值。
常見問題
全距會受到極端值影響嗎?會。因為全距只取決於最大與最小這兩個極端數值,所以只要出現一個特別大或特別小的數字,就可能讓全距產生巨大變化。
全距有可能是負數嗎?不會。由於最大值一定大於或等於最小值,所以全距永遠不會是負數。
有沒有更好的分散度指標?對於含有極端值的資料,四分位距(IQR)或標準差能更穩健地呈現資料的分散情形。